Mike Blazer
25 August 2026 12:15
Интеграция соцсетей в Search Console переливает ссылочный вес паразитных URL на бренд
Панель About This Result доказывает, что алгоритм снимает доменную принадлежность с паразитных урлов и перепривязывает страницы напрямую к личной сущности автора, отмечает Корай Тугберк Гюбюр.
Если загуглить целевое имя вместе с урлом linkedin.com или reddit.com и открыть меню сниппета через три точки, в блоке паблишера высветится имя энтити автора, а не соцсеть.
Система явно маппит сабфолдер или профиль на конкретного человека, изолируя ассет от широкой структуры домена платформы.
Более того, практики форсят это слияние сущностей, чтобы перелить вес поискового трафика на главный мани-сайт, и подвязывают профили соцсетей прямо внутри Google Search Console.
После того как Гугл выкатил интеграции с соцсетями, GSC трекает кросс-системные клики — включая трафик из YouTube или TikTok — и атрибутирует их к центральной брендовой энтити.
Эта связка перенаправляет внешнее вовлечение с паразита обратно в сигналы ранжирования основного домена.
#EntitySEO #ParasiteSEO #GSC
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
24 August 2026 15:05
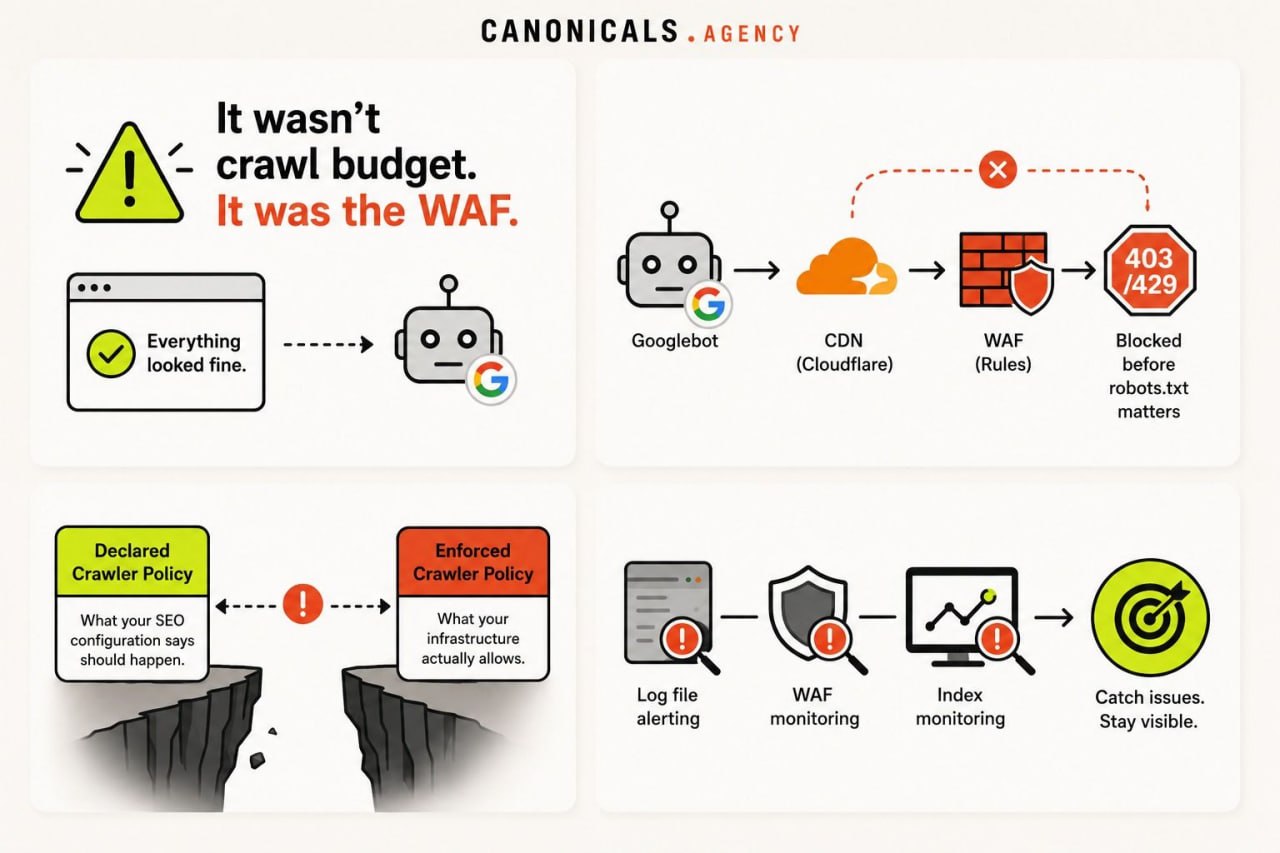
Недавно мы столкнулись с SEO-проблемой, которую команда клиента приняла за проблему с краулинговым бюджетом, пишет Джон Феган.
Это была не она.
Инженеры одного ритейлера закрутили гайки в правилах Cloudflare/WAF после всплеска парсинга.
С точки зрения SEO всё выглядело нормально:
— robots.txt разрешал доступ Googlebot
— сайтмапы были валидны
— страницы были открыты для индексации
— Chrome отдавал статус 200
— в CMS ничего не менялось
Но затем новые страницы товаров стали дольше появляться в Google.
В GSC стало больше URL со статусом "Обнаружено, не проиндексировано", активность сканирования стала хаотичной, а некоторые URL из сайтмапов перестали переобкачиваться.
На первый взгляд это выглядело как проблема краулингового бюджета или индексации.
Это была не она.
WAF периодически отдавал краулерам 403 и 429 ответы — в том числе верифицированному Googlebot.
Поэтому, пока заявленная политика гласила: robots.txt → Googlebot разрешен
фактическая политика выглядела так: Googlebot → CDN → WAF → 403/429
Googlebot блокировался еще до того, как robots.txt имел хоть какое-то значение.
Вот важное различие:
Заявленная политика краулера = то, что должно происходить согласно вашей SEO-настройке.
Фактическая политика краулера = то, что реально пропускает ваша инфраструктура.
И если вы не мониторите индексацию, доступность для краулеров и логи сервера, подобные проблемы могут висеть в слепой зоне неделями.
Симптомы проявляются в SEO.
Корень проблемы может лежать совершенно в другом месте.
Если бы у вас стояли алерты по логам, вы бы это поймали.
Если бы стоял мониторинг WAF, вы бы это поймали.
Если бы стоял мониторинг индекса, вы бы это поймали.
Большинство компаний этого не делают.
Инсайты комьюнити
— Правила WAF могут триггериться на паттерны хедеров или диапазоны IP, специфичные для юзер-агента Googlebot, даже когда остальной трафик проходит чисто. Если лимиты запросов привязаны к CIDR-блоку, а не к индивидуальным IP верифицированного краулера, легитимные запросы Googlebot сливаются в общую корзину — WAF видит перегруз от "сети" и выдает случайные 429, хотя каждый отдельный запрос абсолютно чист.
— CDN, отдающий страницу с капчей любому запросу без нормального отпечатка браузера, может втихую блочить краулеров, пока сайт визуально работает для любого живого юзера — в Search Console этот сбой выглядит как медленная капель софт 404, которую легко упустить, так как внутри ничего не сломано. Проблема вскрывается только при парсинге под видом Googlebot извне корпоративной сети.
#BotBlocking #Crawling #TechnicalSEO
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
24 August 2026 08:15
Патенты Layout-Aware доказывают: границы HTML-контейнеров разрывают семантическую связь
Патенты Google на визуальный анализ документов доказывают: границы HTML-блоков не дают алгоритму строить матрицы совместной встречаемости для соседних кусков текста, раскрывает Корай Тугберк Гюбюр.
Система оценивает предложения через визуальные контейнеры и границы компонентов верстки, а не через строгую последовательную NLP-токенизацию.
По логике архитектуры Майкла Бендерского и Марка Найока, предложения в разных родительских HTML-элементах или отдельных визуальных карточках обрабатываются как изолированные сущности.
Эта структурная изоляция блокирует расчет семантической дистанции между сегментами, независимо от их визуальной близости после рендера.
Чтобы форсить поисковик обрабатывать и токенизировать концепты вместе, практики оборачивают целевые предложения в единый веб-компонент.
При этом такая оценка по верстке диктует правила centerpiece annotation (аннотирования главного контента).
Алгоритм присваивает отдельный вес интерактивным элементам — калькуляторам, полям ввода или слайдерам — если они стоят на первом экране.
Получается, система оценивает сам физический компонент, а не опирается чисто на текстовые строки.
#SemanticSEO #TechnicalSEO #OnPage
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
21 August 2026 15:05
SEO-инфлюенсер: "Повторите эти простые шаги и ваш сайт встанет в топ".
#Humor
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
21 August 2026 08:15
Гайды с самопиаром на первое место отдают рекомендации вашим конкурентам
Анализ 100 B2B-запросов формата "best [category] software" прогнали этой весной по трем разным датам.
В запросах, активирующих AI Overviews, алгоритм в 69% случаев цитировал собственный саморекламный список бренда, но выкидывал этот же бренд из блока рекомендаций, отправляя покупателей прямиком к конкурентам.
Такие подборки получили 323 цитирования; в 224 случаях бренд-автор так и не получил рекомендацию.
Цитирование и рекомендация — это независимые действия, которыми управляют разные критерии.
Цитирование означает, что страница оказалась удобной для парсинга информации.
Рекомендация отражает то, что более широкий веб (форумы, отзовики, пресса, аналитики) уже говорит об этом бренде, независимо от наличия гайда.
Тот факт, что вы поставили себя на первое место в собственном материале, никак не влияет на второй пункт.
Для нового бренда со слабым цифровым следом такой гайд бьет рикошетом и работает против вас: модель вытягивает со страницы названия конкурентов и их сравнение, рекомендует их, но оставляет автора за бортом.
Кейс по запросу "best AI data catalogs in 2026" доказывает это максимально чисто.
Определение для AIO парсится с DQLabs — небольшого вендора, который поставил себя на первое место в рейтинге.
Но в рекомендациях висят лидеры категории во главе с Atlan.
Atlan тоже публикует аналогичный список с самопиаром, но при этом получает и цитаты, и рекомендации, потому что Gartner и Forrester уже признали их лидерами.
Даже когда "best" сводится к входному порогу функций, бренд с трастом от внешнего веба всегда побеждает гайд, который сам же эту категорию описывает.
Но теперь побочный ущерб уже не ограничивается простым игнором.
В промптах с жесткими требованиями модели начали напрямую называть конкретные продукты, которых стоит избегать под конкретный юзкейс, и подтягивать под это источники.
Так что неподходящий бренд может всплыть как прямое исключение из правил.
Рекомендация — это то место, куда реально перетекает трафик.
Для пользователей, впервые столкнувшихся с брендом, она принесла примерно вдвое больше поисков, визитов и просмотров продуктов по сравнению со вскользь брошенным упоминанием — скачок на 117–185% в течение недели.
Рекомендованный бренд забрал примерно в 2.5 раза больше нового трафика, чем конкуренты за бортом списка.
При этом только около 9% этих визитов пришли напрямую из AI.
Остальное — это брендовый поиск и direct, которые атрибуция по последнему клику никогда не свяжет с ИИ.
Рычаг для нового бренда лежит за пределами сайта.
Он жестко привязан к авторитетным сигналам, которые невозможно сфабриковать гайдом: стороннее подтверждение (G2, Gartner), сайты с отзывами, обсуждения в комьюнити (особенно Reddit, на который жестко опираются ИИ-ответы), заработанные медиа (earned media), попадание в чужие рейтинги, оригинальные исследования и обзоры аналитиков.
Собственный гайд по-прежнему формирует то, как LLM воспринимает категорию — и это единственная выгода, которая остается бренду, пока модели не готовы его рекомендовать.
Инсайты комьюнити
— Цитаты и рекомендации лежат на разных слоях, а не на разных ступенях одной лестницы: цитата означает, что страница полезна прямо сейчас, тогда как рекомендация зависит от того, считает ли модель бренд трастовой сущностью в нише. Эту метрику нельзя прокачать простым он-пейдж контентом. Гайд бьет рикошетом по новому бренду, потому что упоминание конкурентов в сравнении алгоритм считывает как глубину категории именно для этих конкурентов, а не для площадки-издателя.
— Полевые данные из миллионов ИИ-ответов, которые трекаются ежемесячно, указывают на офф-пейдж стратегию: нужно составить карту экосистемы, смежных категорий покупок, критериев покупателей и юзкейсов, а затем выстраивать контент вокруг этих контекстных модификаторов, чтобы перехватить больше цитирований. Это критически важно в AI Mode. Тренировочные данные тоже жестко якорят эти ответы, особенно в Claude и ChatGPT.
#AIOverviews #ContentStrategy #B2B
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
20 August 2026 12:53
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
20 August 2026 08:15
Обновление сайтмапов палит ИИ-ответы и триггерит ручник на 168k тредов
Принудительный краулинг старого UGC-контента пробивает пороги ручной проверки Гугла при интеграции ИИ-сервисов.
Домен windowsforum.com 15 лет жил с немодерируемым комьюнити и спокойно пережил серию кор-апдейтов.
Но Гугл внезапно вкатил сайту ручной фильтр WNC-651700 за малоценный контент, прицельно ударив по паттерну URL windowsforum.com/threads/.
Санкция выкосила 168 290 тредов и более 500 000 постов, убив 75.6% кликов из поиска и обвалив общие просмотры на 60%.
Фильтр сработал сразу после того, как админы обновили robots.txt и XML-сайтмапы, прикрутив WebMCP для парсинга контента.
Смена директив краулинга заставила алгоритм переоценить форумные страницы по современным спам-лимитам.
При этом Гугл полностью проигнорировал реально пустые архивные разделы на 11 927 тредов, которые неактивны уже три года.
Истинной целью ручника, вероятнее всего, стали сгенерированные ответы: с 2023 года форум использовал ИИ-чатбота, который оставил более 100 000 сообщений.
Добавленная ценность форума — это реальный человеческий опыт, тогда как ИИ просто компилирует чужие тексты, что алгоритм приравнивает к пустым аффилиатникам.
Когда краулер переваривает тысячи старых веток, внезапно залитых машинными ответами, система флагит паттерн URL за массовый абуз, и ревьюер сносит весь каталог без предоставления единого примера URL.
https://www.searchenginejournal.com/google-may-be-penalizing-ai-generated-content-as-thin-content/583773/
#ManualActions #ThinContent #Crawling
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
19 August 2026 12:15
Гугл схлопнул сайт? Рестарт в топе за 72 часа — даже с клонированным контентом
Снимать бан со старого домена — гиблое дело.
Можно впустую похоронить месяцы.
Спецы его и не снимают.
Они переезжают на особый класс доменов, которым поисковик отсыпает траст по умолчанию.
На таком домене Гугл видит авторитет и региональный вес — и вообще не вяжет его с твоим забаненным прошлым.
Клонируешь туда контент снесенного сайта, агрессивно пушишь в индекс — и забираешь топ по гиперконкурентным ключам за три дня.
Работает в любой нише.
В кейсе морду по жестко конкурентному ключу вытащили ровно за 72 часа.
Пока ты строчишь слезные реквесты на пересмотр, конкурент с баном в анамнезе уже снова сидит в топе.
Какой класс доменов даёт врождённый траст и полный протокол рестарта → @
Действуй, пока дыру не прикрыли.
Читать полностью…
Mike Blazer
18 August 2026 15:05
GSC флагит Core Web Vitals в зеленой зоне Lighthouse — полевые данные опровергают лабораторные тесты
Расхождение реально и ожидаемо: GSC показывает полевые данные Chrome User Experience Report (CrUX) — измерения от реальных пользователей — тогда как лабораторные тесты Lighthouse и PSI выполняют синтетический прогон на контролируемой машине.
Когда GSC вообще выводит метрику, это значит, что страницу посетило достаточно реальных пользователей, чтобы Google поделился данными.
Зеленая зона в лабе плюс красная в поле — это не баг; эти два инструмента измеряют разные вещи.
Три точки сбоя объясняют, почему цифры расходятся, и все три больше всего бьют по INP и LCP:
GSC группирует "похожие" страницы в единый бакет отчетности.
Это расширяет охват — вы получаете данные для URL, которым по отдельности не хватает трафика — но теряете гранулярность, и одна плохая страница в группе может утащить весь бакет в красную зону (или хорошая может замаскировать плохую).
URL, на который ругается GSC, часто не является той конкретной страницей, которую вы можете воспроизвести.
CLS оценивается по-разному в этих двух контекстах.
Полевая метрика измеряет сдвиг макета по всей странице; Lighthouse оценивает сдвиг только внутри начального вьюпорта.
Страница, которая съезжает при скролле пользователем, проходит в лабе и проваливается в поле.
INP вообще не имеет лабораторного эквивалента — это исключительно метрика реальных пользователей.
Lighthouse нечего воспроизводить, поэтому он никогда не покажет проблему с INP, как бы вы его ни настраивали.
Для SPA и гидрирующих фреймворков — next.js, nuxt — атрибуция только усугубляет путаницу.
CLS, накопленный за любой просмотр страницы на пути пользователя, присваивается первому URL, на который он приземлился.
В итоге лендинг наследует сдвиг, который произошел позже, глубоко в сессии.
(Google дорабатывает метрики soft navigation, чтобы это пофиксить).
Чтобы синхронизировать лабу с полем до того, как вы начнете искать проблему вслепую, вытяните историческую сводку CrUX для URL напрямую по адресу https://cruxvis.withgoogle.com/#/ и сравните с тем, что показывает консоль — источник один, поэтому это сразу раскроет, искажает ли картину группировка страниц GSC.
Инсайты комьюнити
— Лабораторные инструменты можно приблизить к полевым условиям, хотя они никогда не совпадут на 100%: в Lighthouse троттлите CPU и симулируйте медленное сетевое соединение, чтобы сымитировать устройство и пропускную способность реального пользователя. Это сужает разрыв между лабой и полем, но не закрывает его.
— Чтобы собирать полевые данные без ожидания сгруппированной, отложенной отчетности GSC, добавьте библиотеку web-vitals в Google Tag Manager и прокидывайте измерения в ГА4 для расширенной аналитики по каждой странице. Полевое развертывание этого сетапа дало разработчикам гранулярность на уровне страниц, необходимую для точной локализации сбоев. Справка по настройке: https://www.simoahava.com/analytics/track-core-web-vitals-in-ga4-with-google-tag-manager/
#CWV #GSC #TechnicalSEO
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
18 August 2026 08:15
Собственные /g/ ноды вытаскивают трафик в core-апдейте — сила бренда не предсказывает рост
В контролируемом сравнении по смежным нишам 34% сайтов, завязанных на персональную сущность, показали рост (n=95), тогда как из 29 крупных брендов в тех же нишах не вырос никто, и только 3 бренда хоть как-то сдвинулись вверх.
Затем автор собрал 159 верифицированных авторских сайтов, оставил 128 с читаемой историей трафика и зафиксировал: 46% из них выросли в июньском core-апдейте 2025 года при типичной базовой ставке около 18%.
Мое внимание привлек один сайт, ранжирующийся по ВЧ-запросу в email-маркетинге, за которым не стояло никакого бренда: emailvendorselection.com, управляемый одним человеком, Джорди ван Рейном, с ростом с 21 399 до 458 618 визитов в месяц.
Инструмент скоринга — это как раз то, что можно перенести на другие проекты.
Wikidata провалилась как прокси для персональной сущности: из 119 проверенных людей у 48% вообще не было сущности, 24% выдали коллизию полных тезок, 23% оказались неверифицированными однофамильцами, и только 3 вернулись как подтвержденное совпадение со своим сайтом.
Wikipedia измеряла известность.
Google Knowledge Graph API измеряет нечто иное — у 137 из 149 человек была /g/ нода, тип, который Google собирает сам из футпринта человека: сайта, профилей sameAs и упоминаний в сети, без энциклопедической статьи за спиной.
Известность не предсказывала ничего.
Люди, имеющие только собственную /g/ ноду, росли в 51% случаев (36 из 71); те, у кого была и /g/, и старая /m/ нода уровня Freebase, выросли на 38% — это самый низкий показатель среди всех групп.
Энциклопедические ноды по нишевым авторам также привязываются не к тем людям — 18 из 40 оказались коллизией имен, а один сайт по деревообработке совпал с сыном Арнольда Шварценеггера.
Разброс по 54 победителям узкий: медианный возраст домена около 16 лет, 45 из 54 — в хобби-нишах, а стартовый диапазон трафика от 10К до 100К рос в 63% случаев, что стало лучшим результатом.
Сайты до 1К подросли на 11%, причем часть этой группы дала всплеск во время апдейта, только чтобы слить прирост в течение пары месяцев.
Пять YMYL-сайтов по финансам и здоровью вообще не выросли.
Все цифры трафика — это оценки органики по Ahrefs (база — май 2025, после апдейта — апрель 2026, перепроверка — июнь 2026), а вывод о том, что персональная сущность теперь несет вес, который раньше был у бренда, подается как рабочая теория, а не доказанный механизм.
https://usewhistle.co/research/personal-entity-correlation
#EntitySEO #CoreUpdates #KnowledgeGraph
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
17 August 2026 12:15
Логи отрендеренного HTML фиксируют: часы Гуглобота останавливаются, пока страница подгружает ресурсы
Гуглобот рендерит по собственным часам, а не по реальному времени, и эти часы останавливаются, пока выполняется JavaScript или висят сетевые запросы.
В простое он гонит: 5-секундный таймер сработал всего через 455 мс реального серверного времени.
15 ресурсов в цепочке по 500 мс каждый сожгли 9 986 мс реального времени, тогда как часы Гуглобота доползли лишь до 162 мс.
API времени работают как счетчики, а не часы — каждый вызов Date.now() или performance.now() двигает собственный счетчик на 1 мс, и оба идут независимо: 10 000 вызовов Date.now() довели его значение до 10001, тогда как performance.now() остался нетронутым.
Снапшот срабатывает по внутреннему времени, а не по реальному.
После 5 секунд по собственным часам размер вьюпорта меняется, и страница получает последний шанс загрузить контент; отрендеренный HTML фиксируется примерно на отметке 5 250 мс этих часов, а 6-секундный таймаут так и не наступает.
Реальное время задает лишь внешнюю границу.
При цепочке 5-секундных серверных задержек сетевые запросы обрывались на 52 132 мс реального времени, в то время как внутренние часы показывали 112 мс — после чего они спокойно летели к своей отметке в 5 250 мс и завершали рендер.
Детерминизм зашит в эти же часы.
performance.timeOrigin у реального Гуглобота сброшен на полночь по UTC, стирая время суток.
Math.random() выдает идентичную последовательность при каждом краулинге (0.6393021999392658, затем 0.5943970666266978) во всех средах: реальном Гуглоботе, Google-InspectionTool и Rich Result Test, в разное время суток, причем криптографические случайные значения тоже совпадают.
Я собирал скрипт для сброса кеша, чтобы форсировать перекраулинг ресурсов, и обнаружил, что эти цифры никогда не меняются.
Завязанные на рандом сбросы кеша не работают, и всё, что варьируется от времени суток, сводится для краулера к одному замороженному варианту.
Срабатывают два события изменения размера, оба привязаны ко времени Гуглобота:
1. На 5 000 мс: внешние габариты окна схлопываются до 1px, а масштаб вьюпорта прыгает 0.42 → 1.
2. На 5 299.9 мс: window.innerHeight отдает 1 251 074px на странице, которая добавляет блоки по 1000px каждую миллисекунду Гуглобота.
Никаких событий скролла не происходит.
Бесконечный скролл на IntersectionObserver продвигается только при этих двух изменениях размера — первая секция грузится на первом, вторая на втором, а затем время останавливается.
Три секции, независимо от длины страницы.
Весь лог пишется хелпером htmlLog(), который добавляет текстовые ноды в тег <script type="text/plain">, и этот тег доживает до отрендеренного HTML, который возвращают инструменты тестирования.
Побочный эффект такого длинного вьюпорта: главное изображение с высотой 100vh искажает превью в URL Inspection, потому что видимый контент всегда оказывается за пределами области рендера.
На индексацию это не влияет, судя по ответам на эту находку, и ограничение через max-height служит решением; сказывается ли такая структура на позициях — не проверено.
https://bigcommerce.websiteadvantage.com.au/tonys-theory-of-googlebot-relativity/
#Crawling #GoogleBot #TechnicalSEO
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
15 August 2026 12:15
SERP — это джунгли, где нет друзей, а есть только жёсткая пищевая цепь.
Думаешь, твоя белая оптимизация спасёт от тех, кто юзает сливы из @?
Систему можно честно переиграть, если бить в её уязвимости.
Вот какие схемы ты упустил на этой неделе:
1. Миллионы целевых доноров без прокси и серверов — методика, которая дает мгновенный доступ к сырым базам под простановку ссылок в обход классического ручного сбора.
2. Синтетический авторитет в эпоху AI-ответов — связка дистрибуции аудио- и текстового контента, которая заставляет нейросети считать вас лидером ниши без реальных заслуг.
3. Аппаратная изоляция против детекторов накрутки — как жесткое отключение одного сетевого протокола в браузере позволяет ботнетам безнаказанно фармить лайки на Reddit.
4. Выход из-под фильтра через прерывание цикла проверки — как отследить секретный трекинг поисковика и заставить алгоритм запустить массовую индексацию зависшего сайта.
5. Моментальная массовая индексация страниц без песочницы — контринтуитивный трюк с правами доступа, который заставляет Google применить повышенную толерантность к новому домену.
6. Броня от страйков и пессимизаций в высокорисковых нишах — перенос трафика в популярную стриминговую платформу, которая спокойно льет лидов, даже когда мани-сайт стерт из поиска.
7. Взлом фильтра аффилиатов через маркер предвзятости — как смена местоимений и один жесткий дисклеймер снимает санкции и доказывают Гуглу вашу подлинность.
8. Слив бюджета на мертвые площадки с накрученными цифрами — методика проверки, которая показывает, почему "трастовый" сайт с десятками тысяч визитов не передаст вам ни капли ссылочного веса.
9. Обход детекторов ИИ-контента через фейковую верстку — как смена структуры информационной статьи ломает визуальные классификаторы поисковика и моментально форсит дикий траст.
10. Ваши старые URL — это оружие в руках черных сеошников — как эксплуатация теневой памяти Гугла позволяет конкурентам ранжироваться по серой тематике прямо под вашим брендом.
-
Почти все, кто зашёл в PRO на старте, продлили доступ.
Больше половины новых подписок приходят по рекомендациям от своих же.
Люди не платят дважды за воду, они остаются за результат.
Если знаешь тимлида, кому важен профит — перешли ему этот пост.
Пусть он решает, кто будет забирать топ.
Читать полностью…
Mike Blazer
14 August 2026 12:15
Большинство людей фокусируются на том, как LLM сканируют страницы.
Меня всё больше интересует, что они на самом деле сохраняют после сканирования, пишет Акарш.
Взгляните на этот ответ от системы ИИ-поиска.
Вместо того чтобы хранить весь HTML целиком, одной из ключевых извлекаемых частей информации становится сниппет.
Этот сниппет — не просто мета-дескрипшн.
Это сгенерированное ИИ краткое содержание страницы, которое захватывает:
✅ Главную тему
✅ Важные сущности
✅ Ключевые выводы
✅ Контекст, помогающий определить релевантность
А теперь подумайте о том, что происходит дальше.
Когда кто-то спрашивает: "What's the best laptop for gaming"?
LLM не читает тысячи веб-страниц с нуля каждый раз.
Она сначала ищет по таким репрезентациям, как эти сниппеты, чтобы определить релевантные документы, прежде чем решить, какие страницы извлечь, проанализировать или процитировать.
Подумайте об этом так.
Прежде чем LLM решит, использовать ли ваш контент...
Ей сначала нужно понять, о чём ваша страница.
Это понимание в конечном итоге превращается во что-то вроде сниппета, который вы видите ниже.
Если в этой репрезентации отсутствует ключевой контекст, сущности или выводы...
У LLM может никогда не появиться повода вернуться на вашу страницу.
Возможно, новая проблема оптимизации заключается не только в том: "Может ли Google просканировать мой контент"?
Но и в том: "Может ли LLM точно представить мой контент"?
Инсайты комьюнити
— Сохранённые репрезентации страниц в системах ИИ-поиска обычно составляют около 1080 символов; сниппет заметно длиннее этого — редкость.
— Показанный сниппет создаётся в процессе живого извлечения RAG во время запроса, а не вызывается из обучающих данных модели.
#LLM #AI #SearchEngines
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
13 August 2026 15:05
Один классный трюк, если вы гоняете локальные LLM через Screaming Frog...
Многие знают, что интеграцию Ollama можно натравить на локальную модель.
Но мне кажется, мало кто в курсе, что можно также перепрофилировать интеграцию OpenAI.
Достаточно поменять Server URL на другой совместимый с OpenAI эндпоинт, отмечает Крис Левер.
Это значит, что один краулинг может параллельно использовать несколько локальных моделей.
Теперь Screaming Frog может отправлять разные ИИ-задачи в разные локальные модели во время одного сканирования.
Простое изменение в настройках, но оно позволяет задействовать куда больше ИИ при сканировании, и задачи не будут конкурировать за одну и ту же модель.
Например:
🟢 Эндпоинт Ollama в SF
→ Gemma4 4B крутится на одной машине для быстрого обогащения в больших объемах.
🔵 Эндпоинт OpenAI в SF
→ Перенаправьте Server URL на OpenAI-совместимую модель, работающую на другой машине, например на еще одну Gemma4 4B через Ollama, LM Studio или другой совместимый сервер.
Думаю, это открывает реально интересные возможности для более продвинутых рабочих процессов в техническом SEO.
К тому же, вы можете фактически удвоить локальные ИИ-мощности внутри одного краулинга Screaming Frog, используя преимущества его отдельных интеграций провайдеров.
#ScreamingFrog #LLM #TechnicalSEO
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
13 August 2026 08:15
Миф о «токсичных ссылках» вредит вебу. Вот дружеское напоминание, почему это бред.
Когда ты используешь крупные SEO-инструменты вроде Semrush, Majestic или SE Ranking, ты сталкиваешься с концепцией "токсичных бэклинков".
Она основана на термине "неестественные ссылки", который Google ввел лет 15 назад и, судя по всему, уже перестал использовать.
Сейчас в их документации фигурирует просто "ссылочный спам".
Однако популярные SEO-инструменты заставили "неестественные ссылки" звучать еще хуже, окрестив их "токсичными ссылками".
Semrush, например, в своем анализе бэклинков показывает, сколько твоих ссылок "потенциально токсичны" или точно токсичны.
Это довольно пугающая формулировка и цвет (красный или оранжевый).
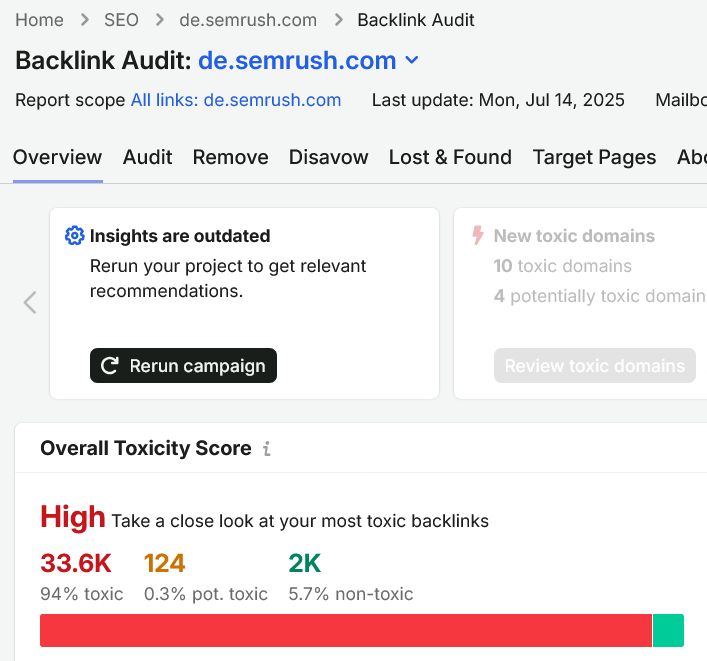
Ниже ты видишь аудит бэклинков для немецкого поддомена самого Semrush.
Как видишь, 94% их собственных входящих ссылок были помечены как токсичные.
Поэтому, прежде чем паниковать, угрожать другим сайтам или отправлять их ссылки в дизавау, прими к сведению!
Даже у лучших из нас (а Semrush — SEO-платформа номер один) преобладают токсичные ссылки, отмечает Тадеуш Шевчик.
Инсайты комьюнити
— Пингвин алгоритмически обесценивает спамные ссылки, а не пессимизирует принимающий сайт, если нет явного паттерна манипуляции. Превентивный дизавау по флагу от вендора может снести ссылки, которые тихо приносили целевой реферальный трафик. Оценка "токсичности" в инструменте маркирует домен, а не доказанный вред.
— Google отошел от старой формулировки "неестественные ссылки" и преуменьшает значение "плохих ссылок", но "ссылочный спам" остается отдельной категорией, по которой они все еще принимают меры.
— Оправданный сценарий для редкого использования дизавау: когда получаешь в наследство сайт с историей покупных ссылок, или для очистки аудита бэклинков, чтобы выявить реальные возможности для линкбилдинга. Ценность здесь — в гигиене аудита, а не в страхе перед фильтром.
#ToxicLinks #Disavow #Backlinks
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
25 August 2026 08:15
Упоминания без связи не работают: 30 одинаковых источников формируют факт для Графа Знаний
Всё на собственном домене — это лишь заявление (claim).
Микроразметка, страница "О нас", идеально сформированный триплет subject → predicate → object — это утверждение, а не доказательство.
Самодекларирование никогда не попадает в Граф Знаний.
Достоверность факта оценивается по тому, сколько независимых источников утверждают одно и то же и насколько они надежны (согласно собственным исследованиям Google).
Бренд и ключ на одной странице — это совместное упоминание (co-occurrence); соединенные четкой связью, они становятся триплетом.
500 источников, описывающих бренд 50 разными способами, выдают 500 слабых заявлений; 30 источников с идентичным описанием цементируют один сильный факт.
Оценка строится на независимости: 50 размещений с одной сетки по одному брифу за неделю читаются как один источник, повторяющий себя 50 раз.
Это футпринты на уровне сущностей, а не ссылок.
Ценность не в упоминании, а в утверждении: упоминание без четкой связи близко к мусору, и именно это продает большинство digital PR-агентств.
Окружение бьет авторитет.
Размещение на DR 85 в неверном семантическом кластере учит граф привязывать бренд к неправильной ноде, либо вообще ни к какой: получается несовпадающая строка, которую LLM не рискнет рекомендовать.
Форматирование и структура предложений решают, что выживет как триплет:
— Подлежащее на первом месте, никаких местоимений. Страдательный залог ломает порядок, а все "он", "они", "компания" плодят осиротевшие факты — разрешение кореференции работает криво и не бесплатно, поэтому повторяй название бренда идентично в каждом абзаце.
— Оговорки убивают достоверность факта. "Один из", "возможно", "вероятно", "помогает" сносят триплет до нуля.
— Отрицание остается локальным. "X произошло. Это ложь". оставляет заявление и сохраняет связь; "X НЕ происходило" — фиксируется. Опровержения в формате "заявление-затем-опровержение" могут цементировать то, что должны были стереть.
— Дистанция размывает. Субъект и объект, разделенные 40 словами придаточных предложений, дают слабую связь, тогда как соседние — сильную.
— Утверждение и доказательство должны лежать в одном блоке. Контент бьется на чанки, и слой извлечения часто тянет один чанк без следующего — половина факта никогда не цитируется.
— Заголовки — это строки запросов. "What Is Entity SEO" матчится; "The Hidden Architecture of Modern Search in 2026" уходит в пустоту.
Консенсус накапливается, а не включается по достижении порога, и распадается без постоянного подкрепления; шестинедельная кампания по сущностям держится лишь ограниченное время.
Негативное подтверждение реверсит механизм: нежелательная ассоциация, растиражированная по сети источников, наследуется, и страница на собственном домене обычно не может это оспорить.
Диагностика бесплатна.
Скорми ChatGPT, Claude, Gemini и Perplexity один и тот же вопрос о бренде в разных сессиях: согласие фиксирует подтвержденный факт, противоречие вскрывает неоднозначность, тишина означает несовпадающую строку.
То, что они цитируют, уже сидит в трастовом наборе.
Определение того, какие утверждения пушить, в каком порядке и с какой динамикой, требует реверс-инжиниринга ниши.
Инсайты комьюнити
— Базовый сет подтверждения: идентичное имя и дескрипторы в Wikipedia, Crunchbase, LinkedIn и Reddit — Wikipedia до сих пор засеивает большинство Графов Знаний.
— Живой парсер все равно ломается на этих цепочках, когда один предлог проскальзывает за границу чанка; в проде правила грамматики деградируют.
#EntitySEO #KnowledgeGraph #DigitalPR
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
24 August 2026 12:15
Подмена контента на сервере выжимает 24 интента вместо 12: конверсия летит на 133%
Страница сравнения B2B SaaS держала один URL и подменяла блоки контента под тип посетителя.
Результат: интенты ранжирования 12 → 24, среднее время на странице 1m 15s → 2m 40s (+114%), конверсия 1.8% → 4.2% (+133%).
Тот же урл, персонализированные блоки, профит выше в 2.3 раза.
Правило, которое решает, будет ли это ранжироваться или рухнет: единый URL, контент меняется на стороне сервера.
Разные урлы под каждую аудиторию плодят дубли, и позиции летят вниз.
Персонализация на клиенте прячет подмененный блок от краулеров.
Рендеринг проверяется через "Fetch and Render" в GSC.
У каноникал есть два рабочих варианта, и оба пока без окончательного вердикта: каноникал сам на себя со всех версий на единый URL, либо отдельный каноникал с каждого варианта на праймери-версию через параметр ?audience=agency или ?audience=startup.
Тестируй оба и замеряй позиции по интентам.
Микроразметка не поддерживает условную логику.
Либо зашивай все варианты цен в один блок — $29 для стартапов, custom для enterprise — и пусть краулеры сами разбираются, либо выкатывай отдельный блок Schema под каждый вариант.
Валидируй в валидаторе Schema.org.
Персонализация держится на четырех осях, у каждой свой вектор детекта:
— Аудитория (роль/индустрия): определяй тип посетителя по рефереру, UTM или эвристике, затем подменяй блок контента на сервере.
— Контекст: локальный прайс и наличие по гео, мобильные степы под девайс, временные офферы по таймингу — плюс микроразметка под каждую вариацию.
— Поведение: только first-party куки. Интро-контент при первом визите, продвинутый — для вернувшихся юзеров, триггеры срочности на брошенных корзинах. Мониторь Core Web Vitals, так как JS может тормозить страницу.
— Время: блоки контента с расписанием активации и экспайра под сезоны и ивенты, что поддерживает свежесть.
Избыточная персонализация — третий сценарий провала.
Если варианты расходятся слишком сильно, они сносят сигналы E-E-A-T и выглядят как недостоверные.
Ядро месседжа остается фиксированным, персонализируются только детали.
Замеры идут по каждому варианту: ранжирование по интенту, CTR по аудитории, вовлеченность и конверсия по варианту (динамическая персонализация дает +23% к конверсии против статики, методология не раскрывается).
Накосячишь с рендером или структурой URL — Google прочитает это как дубли вместо релевантности, и туда прилетят санкции.
#TechnicalSEO #CRO #UX
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
22 August 2026 12:15
Пока ты анализируешь конкурентов, они уже меняют тактику.
Они знают про эксплойты из @, а ты видишь только последствия.
Инсайды этой недели:
1. Усиление траста без ссылочного бюджета — неочевидный способ заставить Google считать чужие домены вашими донорами без единого кликабельной ссылки в коде.
2. Полное стирание конкурента с карты — блэкхет-механика смещения координат, которая ломает видимость чужого локального бизнеса и отправляет его в вечный бан.
3. Сквозная прошивка энтити без ссылок — как правильная настройка одного невидимого HTML-атрибута в шапке намертво связывает бренд с самой жирной категорией.
4. Продажа оверпрайса без скидок и акций — контринтуитивный визуальный триггер в карточке товара, который заставляет самых жадных покупателей платить втридорога с улыбкой на лице.
5. Бренд в ответах LLM за 60 дней — алгоритм создания искусственной вовлеченности на Reddit, который заставляет ИИ-поисковики вытягивать ваши месседжи прямо в генеративную выдачу.
6. Сниффинг серверного ответа для инжекта паразитов — как перехват одного скрытого запроса в популярном плагине форм вскрывает пути для заливки серых офферов на элитные трастовые хосты.
7. Иммунитет от классификации спама одной строчкой кода — элегантный трюк с интеграцией легаси-тегов, который заставляет алгоритм воспринимать вашу сетку как жирный белый проект.
8. Бессмертный маппинг бренда без единой ссылки — метод легального инжекта вашей компании в элитные комьюнити Reddit, за который математически невозможно получить ручной бан или снос треда.
9. Прыжок на 6 позиций в локалпаке за 48 часов — грубый, но безотказный вывод агрегированных цифр со сторонних площадок, который заставляет алгоритмы переписать выдачу в вашу пользу.
10. Превращение ИИ в аппарат прямых продаж — механика подмены чужих негативных сигналов вашими позитивными, которая автоматически делает вас "выбором номер один" в ответах бота.
-
Ты либо используешь это сейчас, либо тебя выдавят из выдачи.
Временной лаг смерти метода — 3-4 месяца.
Не жди, пока тема станет пабликом и перестанет работать.
Действуй на опережение!
Читать полностью…
Mike Blazer
21 August 2026 12:15
img2threejs конвертирует фото в код Three.js!
Зацени: https://github.com/img2threejs/img2threejs
Кто-то собрал image-to-3D пайплайн, который не генерирует меш.
Он генерирует TypeScript.
img2threejs берет одно референсное изображение и выдает фабрику THREE.Group — объект, собранный из примитивов, процедурных шейдеров и сгенерированной геометрии, с пивотами, сокетами и коллайдерами, так что он сразу готов к анимации.
Довольно круто.
Никакой фотограмметрии, никаких скачанных арт-паков, никаких многомегабайтных бинарников.
На выходе — код, который можно просматривать через diff, ревьюить и версионировать.
Инструмент подкупает честностью своих ограничений.
Одно фото не покажет скрытые стороны.
"Невозможно достичь запрошенной детализации" — вполне валидный результат.
Лицензия Apache 2.0.
Работает под Claude Code, Codex или OpenCode.
Если ищете что-то более продвинутое, в последнее время я успешно использую Meshy, который переваривает несколько ракурсов и выдает модели, делится Эдди Османи.
#WebDev #Tools #AI
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
20 August 2026 15:05
Одиночный съем позиций в ИИ врет в 99% случаев. Формула Кокрена выводит реальную видимость.
Одиночный съем через промпт — когда ответ LLM фиксируют один раз и считают статичной позицией — математически невалиден.
LLM отдают вероятностные распределения вместо привычного серпа, поэтому тесты на 3,000 запросов показывают: шанс сгенерировать идентичный список брендов дважды составляет менее 1%, а шанс получить этот же список в точном порядке — 0.1%.
Чтобы вытащить фактический бейзлайн из этой волатильности, я собираю трекинг промптов вокруг формулы выборки Кокрена и изолирую статистически валидный Mention Rate, разбирает Итамар.
Схема объединяет горизонтальный охват для учета разброса запросов и вертикальную глубину для фильтрации вероятностных отклонений.
Для погрешности в 10% я прогоняю 20 разных тематических вариаций промпта по 5 раз — итого 100 сэмплов.
Чтобы сжать маржу до 5%, я масштабируюсь до 40 вариаций по 10 прогонов (400 сэмплов).
Ради максимальной точности с погрешностью ~2% я настраиваю 80 вариаций по 30 прогонов (~2,400 сэмплов).
После всех прогонов я полностью вычищаю метрики позиций.
Фиксирую бинарное Да/Нет для присутствия бренда по выбранному тиру сэмплов и усредняю результаты в единый ежемесячный Mention Rate.
Обработка этого идентичного статичного сета промптов из месяца в месяц математически отделяет реальные сдвиги видимости от алгоритмического хаоса.
#LLM #RankTracking #Reporting
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
20 August 2026 12:15
Глубина контента и скорость сайта вытаскивают позиции с 12 на 4 место — полгода копирования ссылок дали лишь рост с 15 на 12
Гипотеза: получаем те же ссылающиеся домены, что и у лидеров, и позиции сравниваются.
Условия теста: топ-3 конкурента по целевому ключу, около 200 мощных доменов-доноров со сторонней метрикой DR 60+, ссылки добывались с пересекающихся площадок в течение 6 месяцев — частичное пересечение, а не точное копирование.
Результат через 6 месяцев: рост с 15 на 12 место.
Почти нулевой выхлоп от полноценной кампании по копированию бэклинков.
Слепое копирование упускает саму суть работы ссылочного профиля.
Конкуренты наращивали ссылки годами; сжатое окно линкбилдинга формирует аномальную динамику ссылочного, которую алгоритм читает в широком контексте, а не как изолированный снимок.
Траст накапливается постепенно; он жестко завязан на возраст и историю домена, которые новичок не может унаследовать моментально.
А главное — ссылки конкурентов ложатся на крупные контентные экосистемы и мощный тематический авторитет.
Именно это заставляет донора реально передавать ссылочный вес.
Последний поинт — это механика, которую игнорирует большинство ссылочных аудитов: один и тот же домен-донор передает разный вес.
Ценность ссылки меняют четыре фактора:
1. редакционный и контекстный характер против шаблонного размещения,
2. позиция на странице (в основном контенте статьи, а не в сайдбаре, футере или био автора),
3. релевантность окружающего текста,
4. внутренний траст ссылающейся страницы.
SEO-инструменты показывают только домен и прячут все четыре фактора.
Они не раскрывают тайминги ссылок, редакционный интент, реальный вклад конкретного линка в ранжирование и сигналы траста сайта (историю домена, глубину контента, ПФ), которые вообще лежат за пределами ссылочных метрик.
Метрики сдвинул отказ от копирования.
Объем контента расширили со 120 до 380 страниц, улучшили попадание в интент, собрали оригинальные данные, скорость загрузки срезали с 3.8 до 1.6 сек, а внутреннюю перелинковку пересобрали для перелива веса на ключевые URL.
Позиции взлетели с 12 на 4 место — это более масштабный и стабильный рост, чем от всей ссылочной кампании, причем с меньшими затратами.
Бэклинки конкурентов остаются полезными как карта, а не пошаговая инструкция: для поиска релевантных площадок, контент-гэп анализа того, что собирает ссылки в нише, и понимания стратегии — откуда лидеры тянут видимость.
Их преимущество в ранжировании идет от системы, внутри которой сидят ссылки, а не от самих бэклинков.
#ContentOptimization #LinkBuilding #Backlinks
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
19 August 2026 15:05
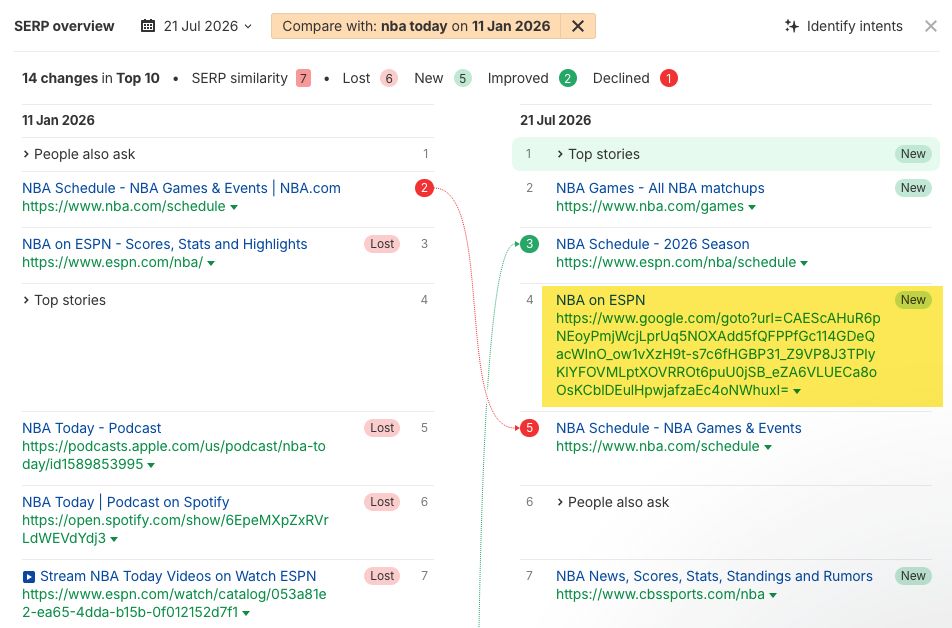
Google постепенно заменяет читаемые URL в выдаче на маскированные, закодированные в base64url protobuf-ссылки (например, /goto?url=XXX), и вебмастера опасаются, что это ударит по видимости и отслеживанию рефералов.
Раньше это считалось возможным тестом; однако Google только что добавил этот путь в свой robots.txt, а количество ключей, где он появляется, удвоилось с мая, согласно данным Ahrefs.
Инсайты комьюнити
— Маскированный редирект /goto?url= маршрутизирует клики через Google перед перенаправлением на целевую страницу, так что реферер теперь показывает переход из Google, а не из реального источника — кликовые реферальные данные остаются внутри систем Google, а не отдаются сайту или сторонним инструментам. Добавление пути в robots.txt сигнализирует о раскатке, а не о тесте, и этот сдвиг усложняет парсинг позиций сторонними тулами и моделирование атрибуции.
— Маскировка реферальных данных убирает метрику, на которую маркетологи обычно ссылаются как на "чистый", проверяемый сигнал для защиты бюджета на органику — как только этот сигнал скрыт, обоснование бюджета смещается на метрику, которую никто не может независимо верифицировать.
— Со скрытыми Гуглом рефералами органическая атрибуция перестает быть истиной в последней инстанции и становится лишь оценкой, которую большинство дашбордов так не помечают — это повод отслеживать "присутствие" (упоминает ли поисковик сайт вообще), а не опираться исключительно на отслеживаемый объем кликов.
— Гипотеза: похожий паттерн маскировки URL появляется в результатах поиска Gemini API, что затрудняет понимание того, что на самом деле там происходит дальше.
#Analytics #RankTracking #Crawling
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
19 August 2026 08:15
Я отдал 404-й код для ~22к урлов на своем сайте, чтобы посмотреть, сколько времени понадобится Гуглу, чтобы перестать их краулить, и похоже, что Гугл краулит их еще активнее, отмечает Винисиус Станула.
Я взял фиксированную группу из ~22 000 этих страниц, все мертвы с одной и той же недели в июне, и просто наблюдал, как часто гуглобот заходил на них в течение следующего месяца.
Я знаю, что в документации Гугла сказано, что выпадение 404-й страницы из индекса может занять месяцы.
Но краулить их активнее после 404-й?
Это для меня что-то новое.
Инсайты комьюнити
— Полевой кейс по очистке взломанного сайта: возврат кода 410 на тысячах спамных урлов все равно потребовал от Гугла нескольких месяцев, чтобы остановить краулинг и деиндексировать всё — одна лишь смена статус-кода не ускоряет удаление.
— Утверждения практиков о разнице обработки 404 и 410 расходятся: одни считают, что код 410 (окончательно удалено) заставляет Гугл быстрее прекратить краулинг, чем 404; другие возражают, что Гугл обычно обрабатывает 404 и 410 одинаково, потому что большинство владельцев сайтов не знают разницы между этими кодами — различие становится очевидным только через конкретные API, такие как jobs API.
— Гипотеза: всплеск краулинга 404-х может отражать то, что Гугл ищет дополнительные доступные для сканирования ресурсы и хочет чаще краулить сайт, а не сигнализирует о проблеме.
— Гипотеза: всплеск краулинга после отдачи 404-го кода может указывать на то, что Гугл перепроверяет статус контента страницы, особенно когда мертвые урлы ранее имели сильные бэклинки.
#404Errors #410Errors #Crawling
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
18 August 2026 12:15
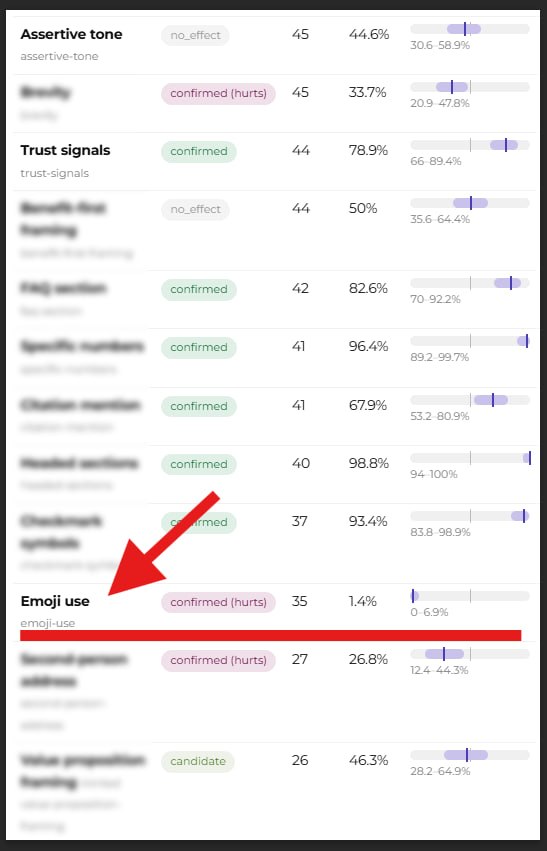
Эмодзи подтверждены как негативный сигнал для Gemini 3.6 Flash.
Полная картина: https://dejan.ai/sro/
Инсайты комьюнити
— Наличие эмодзи в контенте страницы снижает вероятность того, что Gemini 3.6 Flash выберет эту страницу, бренд, продукт или услугу в качестве рекомендации.
#AI #Gemini #AlgorithmPenalties
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
17 August 2026 15:05
13 281 fan-out запрос раскрывает 3.2x разрыв в поиске между известными и неизвестными брендами
Бренды, которые модель уже вытягивала из памяти в топ-10 для категории, появлялись в ее собственных fan-out запросах в 3.2 раза чаще, чем бренды, которых она не помнила: 17.4% → 55.7%.
Это опирается на 1 416 наблюдений на уровне бренда — 274 из 492 брендов в памяти ушли в поиск, против 161 из 924 неизвестных.
Попадание в топ-5 при извлечении из памяти поднимало этот показатель до 67%.
Разрыв сохранился во всех девяти замерянных нишах: неизвестные бренды искались с частотой 9-23%, а бренды из памяти — 41-82%.
Извлечение из памяти (recall) стоит до сетевого поиска (fetch), что сдвигает рычаг влияния раньше, чем предполагает большинство SEO-задач.
Лишь 31% fan-out запросов вообще называли конкретный бренд; остальные 69% были общими категорийными поисками.
Из этих брендовых 31%, в 63% случаев модель тянулась к одному из топ-5 имен, которые уже держала в памяти.
Пул кандидатов формируется еще до того, как извлечена хотя бы одна страница.
Когорту делят два режима, они измеряются как доля брендовых запросов, называющих запомненный топ-5 бренд.
Автомобильная ниша сработала на 82%, а Финансы на 77%: в одном ответе по BNPL-сервисам модель запустила шесть fan-out запросов, четыре из которых были чисто брендовыми — Affirm, Klarna, Afterpay, PayPal.
Это ее топ-4 брендов из памяти, и каждый был обернут в один и тот же шаблон "merchant fees US".
Фитнес и ЗОЖ показали 50% — там модель гораздо чаще ищет за пределами собственной памяти.
Впрочем, память тоже не гарантирует монополию: на вопрос, какого платежного провайдера выбрать стартапу, модель поискала Stripe, PayPal и Square из памяти, а затем назвала Lemon Squeezy, которого вообще не было в ее радаре.
Выводы строятся на анализе боевых fan-out запросов, а не текста ответов — 13 281 запрос в 3 960 ответах (66 коммерческих промптов для США прогонялись по 60 раз в течение 12 дней).
Память и поиск замерялись на двух разных моделях (поиск — на Gemini 3.5 Flash).
Бренду нужно было пройти обе по отдельности, что делает этот разрыв минимальным порогом, а не багом одной конкретной модели.
Исследование называет это корреляцией в разведочных данных, а не доказанной причиной.
Главный фактор искажения — известность бренда: популярные бренды и лучше запоминаются, и чаще ищутся.
Нишевые срезы опираются на 6–12 промптов, поэтому они скорее ранжируют категории, чем замеряют точный размер эффекта.
Если паттерн подтверждается, именно над извлечением из памяти и предстоит работать.
А оно формируется на этапе обучения и зарабатывается через устойчивую ассоциацию с категорией:
— Упоминания у аналитиков и в прессе.
— Сигналы партнерств.
— Стабильная связка бренда и категории в сравнениях и листинг-контенте, на котором обучаются модели.
В категории, завязанной на память, попадание в сохраненный пул — это почти обязательное условие для того, чтобы бренд вообще начали искать.
В категории со слабой памятью живой контент все еще может затянуть неизвестный бренд в fan-out, но это более слабая позиция, так как ее придется отвоевывать заново на каждом запросе.
https://geosurge.ai/posts/model-memory-predicts-which-brands-get-searched
#AgenticSEO #AIOverviews #LLM
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
17 August 2026 08:15
Perplexity раскрывает все 16 классификаторов с фиксированными порогами до запуска поиска
Прежде чем Perplexity вообще что-то ищет, он отправляет всю логику своего роутера запросов в браузер — в поле classifierresults.mhepredictionsfull.
Не просто решение, а весь скоринг: 16 модулей (по одному на каждую возможную поверхность — погода, места, шоппинг, видео, генерация картинок, финансовая карточка), каждый из которых несет свою вероятность, фиксированный порог для срабатывания и булево значение.
Сверху висит метка domainsubdomain с таксономией тем и собственной уверенностью, и она отслеживает запрос — TECHNOLOGY/CYBERSECURITY на уровне 0.727 для объяснения TLS-рукопожатия, BUSINESS/DIGITALMARKETING на 0.94 для "Ahrefs vs Semrush" и всего 0.49 для "latest Google algorithm update", так как новости сложно упаковать в одну аккуратную тему.
Пороги не сдвигаются.
Они были идентичными во всех 7 запросах в июне и снова идентичными на другом билде 26 дней спустя, что делает их реальной границей принятия решения, а не подстройкой под настроение конкретного запроса:
— imagegeneration 0.98
— skippersonalsearch 0.95
— placessearchintent 0.85
— shoppingintent 0.80
— timewidget 0.80
— financeagent 0.70
— financewidget 0.53
— videopreview 0.50
— imagepreview 0.42
— weatherwidget 0.40
— calculatorwidget 0.30
Свяжите коммерческий запрос с его доменной меткой и модулем, который вероятнее всего сработает, и конкуренция за поверхность выдачи перестанет быть гаданием.
Запрос "лучший X рядом со мной" пробивает 0.85 по местам и превращается в битву за карты, а не за синие ссылки.
На TLS-запросе imagepreview достиг 0.318 против своего порога в 0.42 — самый близкий промах в серии тестов, и именно поэтому блок с картинками почти отрендерился, но в итоге не вышел.
skipsearch вернул false на всех 7 запросах.
Каждый из них ушел в веб, включая "how do I change a flat tyre step by step" — тот самый запрос, на который ChatGPT отвечает из обучающей выборки с пустой вкладкой сети.
Perplexity вместо этого перевел его в режим Study с model: pplxstudy и searchmode: STUDY, и выкатил сверху вкладку с видеоответом (в июльском повторном тесте видео-модуль показал 0.988).
Ничто из этого не выживает после формирования ответа.
Ответ приходит как поток Server-Sent-Events, через POST-запрос к /rest/sse/perplexityask, и завершенное тело SSE невозможно воспроизвести повторно — если запросить его еще раз, сервер вернет прерванный запрос, а не текст.
Перехват нужно ставить до отправки запроса: переопределить window.fetch, клонировать ответ, читать клон по мере поступления, а затем парсить самый большой блок data: ближе к концу, а не терминальный маркер завершения.
Изолированный автоматизированный Chrome жестко блокируется Cloudflare за несколько запросов, а в текущем билде сокет ответа вообще не закрывается после завершения, поэтому скрипт, ожидающий окончания потока, будет висеть вечно.
Сначала я полез в Wireshark, но сдался по той же причине, что и раньше: тела ответов зашифрованы по TLS при передаче, а единственный читаемый слой — это браузер, уже после дешифровки.
Здесь действуют два уровня достоверности.
Сами поля и их поведение железобетонны, поскольку одного чистого перехвата достаточно, чтобы доказать существование поля, а ни один анализ промптов этого не увидит.
Все подсчеты базируются на 8 перехватах по 7 типам запросов на одном залогиненном Pro-аккаунте в Дубае, на билде 7fe6ad4 и перепроверены на df49f17, поэтому воспринимать их стоит как вектор, а не как точное измерение.
https://suganthan.com/blog/how-perplexity-picks-sources/
#SearchEngines #AI #API
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
14 August 2026 15:05
No comments
#Humor
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
14 August 2026 08:15
Common Crawl — это КРУПНЕЙШИЙ источник обучающих данных для LLM. Вот как за 5 минут проверить, попал ли ваш сайт в обучающие данные:
Примечание автора: Чтобы получать подобные советы прямо на почту, подписывайтесь на рассылку по ссылке в моем профиле, пишет Крис Лонг.
Джейсон Мелман вчера поделился классной фишкой на нашей внутренней встрече Nectiv.
Common Crawl недавно выпустил гайд "The AI Visibility Audit" с действительно полезной информацией о том, как вашему сайту попасть в датасет Common Crawl.
Для тех, кто не в курсе, Common Crawl — это, пожалуй, самый крупный источник данных для обучения LLM.
Это огромный публичный ресурс, который большинство передовых моделей почти наверняка использовали для обучения своих баз знаний.
Так вот, в статье они реально показывают, как через командную строку проверить, включен ли ваш сайт в последнюю версию Common Crawl.
Звучит сложно, но на деле все довольно просто.
Покажу пример проверки на DocuSign.
1. Откройте командную строку на вашем устройстве
2. Задайте домен: DOMAIN="docusign(dot)com"
3. Проверьте, есть ли у CCBot доступ к сайту: curl -A "CCBot/2.0" -I "https://$DOMAIN/"
4. Проверьте, есть ли домен в последней версии Common Crawl: curl "https://index(dot)commoncrawl(dot)org/CC-MAIN-2026-21-index?url=$DOMAIN/*&output=json" | head
Затем вы получите ответ, по которому видно, включен ли ваш сайт в последнюю версию.
Если вы видите, что ваш сайт есть в ответе, вы подтверждаете, что Common Crawl его подхватывает.
Тогда у вас будет подтверждение того, могут ли LLM использовать ваш сайт в обучающих данных.
Инсайты комьюнити
— Присутствие в индексе Common Crawl подтверждает только crawlability, а не попадание в обучающую выборку. Утверждение из поста о том, что появление в индексе гарантирует использование сайта LLM, некорректно. AI-лаборатории прогоняют жесткую фильтрацию (dedup, классификаторы качества, perplexity filters) перед запуском обучения. В итоге малоценные страницы краулятся, но отбрасываются; плюс доступность для краулера никогда не гарантирует, что LLM обучится на этой странице, упомянет ее или сошлется.
— Главный рычаг в 2026 году — это извлечение данных (retrieval), а не претрейн, так как обучающие выборки заморожены и содержат потери. Разрешайте CCBot, но также открывайте доступ для GPTBot, PerplexityBot, ClaudeBot и Google-Extended в robots.txt.
— Сначала проверяйте robots.txt через curl. Сайты часто блочат CCBot из-за глобального запрета для AI-ботов, который автоматически вешает CDN или плагин безопасности, а потом удивляются, почему LLM их не видят. Проверяйте это, прежде чем списывать все на проблемы с контентом.
— Дополнительный шаг проверки: скачайте полный отрендеренный сервером HTML с юзер-агентом CCBot, чтобы убедиться, что краулер получает реальный контент, а не пустую оболочку на JavaScript. Команда для Windows PowerShell: curl(dot)exe -A "CCBot/2.0 (https://commoncrawl(dot)org/faq/)" -L -sS "https://example(dot)com/" -o homepage-ccbot(dot)html, а затем откройте сохраненный файл.
— Common Crawl работает на основе самостоятельного поиска — краулер сам находит контент, добавить сайт вручную нельзя. Эту базу чаще используют развивающиеся LLM, в то время как фундаментальные модели от OpenAI, Anthropic и Google опираются на нее меньше из-за большого количества дублей и слабой структурированности датасета.
#AI #Crawling #Bots
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
13 August 2026 12:15
Медленный краулинг Screaming Frog снимает блокировки Cloudflare — подмена на Googlebot делает только хуже
Если Screaming Frog отдаёт статус "too many requests" после первых ~50 URLs на мелком сайте (до 500 URL) на WordPress за Cloudflare (хостинг Cloudways) — это сработал лимит запросов, а не проблема SEO.
Здоровая статистика краулинга в GSC подтверждает: блокировка идёт от защиты от ботов на стороне клиента.
Снижение скорости краулинга в самом Screaming Frog до минимума реально снимает этот блок.
Смена User-Agent краулера на Googlebot делает блокировку жёстче, а не мягче.
Cloudflare сверяет IP запроса с официальными пулами Googlebot, а не просто смотрит на строку UA.
Поэтому UA Googlebot с IP Screaming Frog читается как самозванец и отлетает в блок моментально.
Надёжное решение — вайтлист на стороне клиента: пусть добавят краулер в белые списки Cloudflare, связав IP и UA, потому что правила только по IP работают криво.
Полностью скипай правила по IP, если у машины для краулинга нет статического адреса — кастомный UA или bearer-токен держатся лучше при ротации адресов.
Для анализа логов прогоняй логи сервера через Log File Analyser в Screaming Frog — он вообще не касается Cloudflare.
И если твой краулер заблочен, это не значит, что заблочен Googlebot.
Пока логи и GSC не показывают проблем — это просто система управления ботами Cloudflare, а не ошибки сканирования сайта.
Инсайты комьюнити
— Чтобы подтвердить, что причина именно в управлении ботами Cloudflare, настрой Screaming Frog на сбор заголовков ответа и ищи там заголовок bot score — его наличие показывает, что скоринг ботов Cloudflare активен, хотя это фича enterprise-уровня.
— Обойти Cloudflare на объёме через curl-cffi или obscura больше не работает. Чтобы парсить сайты под защитой CF, которые активно блочат, теперь нужно управлять реальным профилем браузера. Screaming Frog не заточен под обход сайтов, которые не хотят, чтобы их парсили, поэтому меняй инструмент, если добавить в вайтлист не вариант.
#BotBlocking #Crawling #TechnicalSEO
@
⚠️ Закрытый канал: @
Читать полностью…
Mike Blazer
12 August 2026 15:05
Схема "прокладки": как отмыть любой трафик в трастовые реферальные сигналы от самого Гугла
Главная боль сейчас — не позиции, а где взять качественный трафик, которому поверит алгоритм.
Один из практиков спалил многоуровневую схему.
Она отмывает любой твой траф в реферальный сигнал, исходящий как бы от самого Гугла.
Трюк в том, КАК именно ты заводишь аудиторию на трастовый сервис.
Не в лоб, а через специфическую прокладку.
Алгоритм видит переход с родного доверенного ресурса и засчитывает его как мощный буст твоему мани-сайту.
Схема масштабируется на разные сервисы экосистемы Гугла — все они работают как прокладки.
Пока конкуренты скупают дорогие ссылки, инсайдеры отмывают мусорный трафик в сигналы максимального траста.
Точная схема маршрутизации трафика через прокладку → @
Действуй, пока конкуренты думают.
Читать полностью…


 8310