Data Science | Machinelearning [ru]
19 October 2023 19:07
👤Каталог данных — почему без него непросто и как всё организовать с максимальной пользой
В этой статье автор расскажет о проблематике работы с данными (и о доверии), и о плюсах, которые даст вам каталог данных.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
18 October 2023 19:07
🦙Как «воспитать ламу» и ускорить ML-эксперименты
В этой статье мы рассмотрели проведение ML-экспериментов от подготовки данных до деплоя инференс-инстансов.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
18 October 2023 11:37
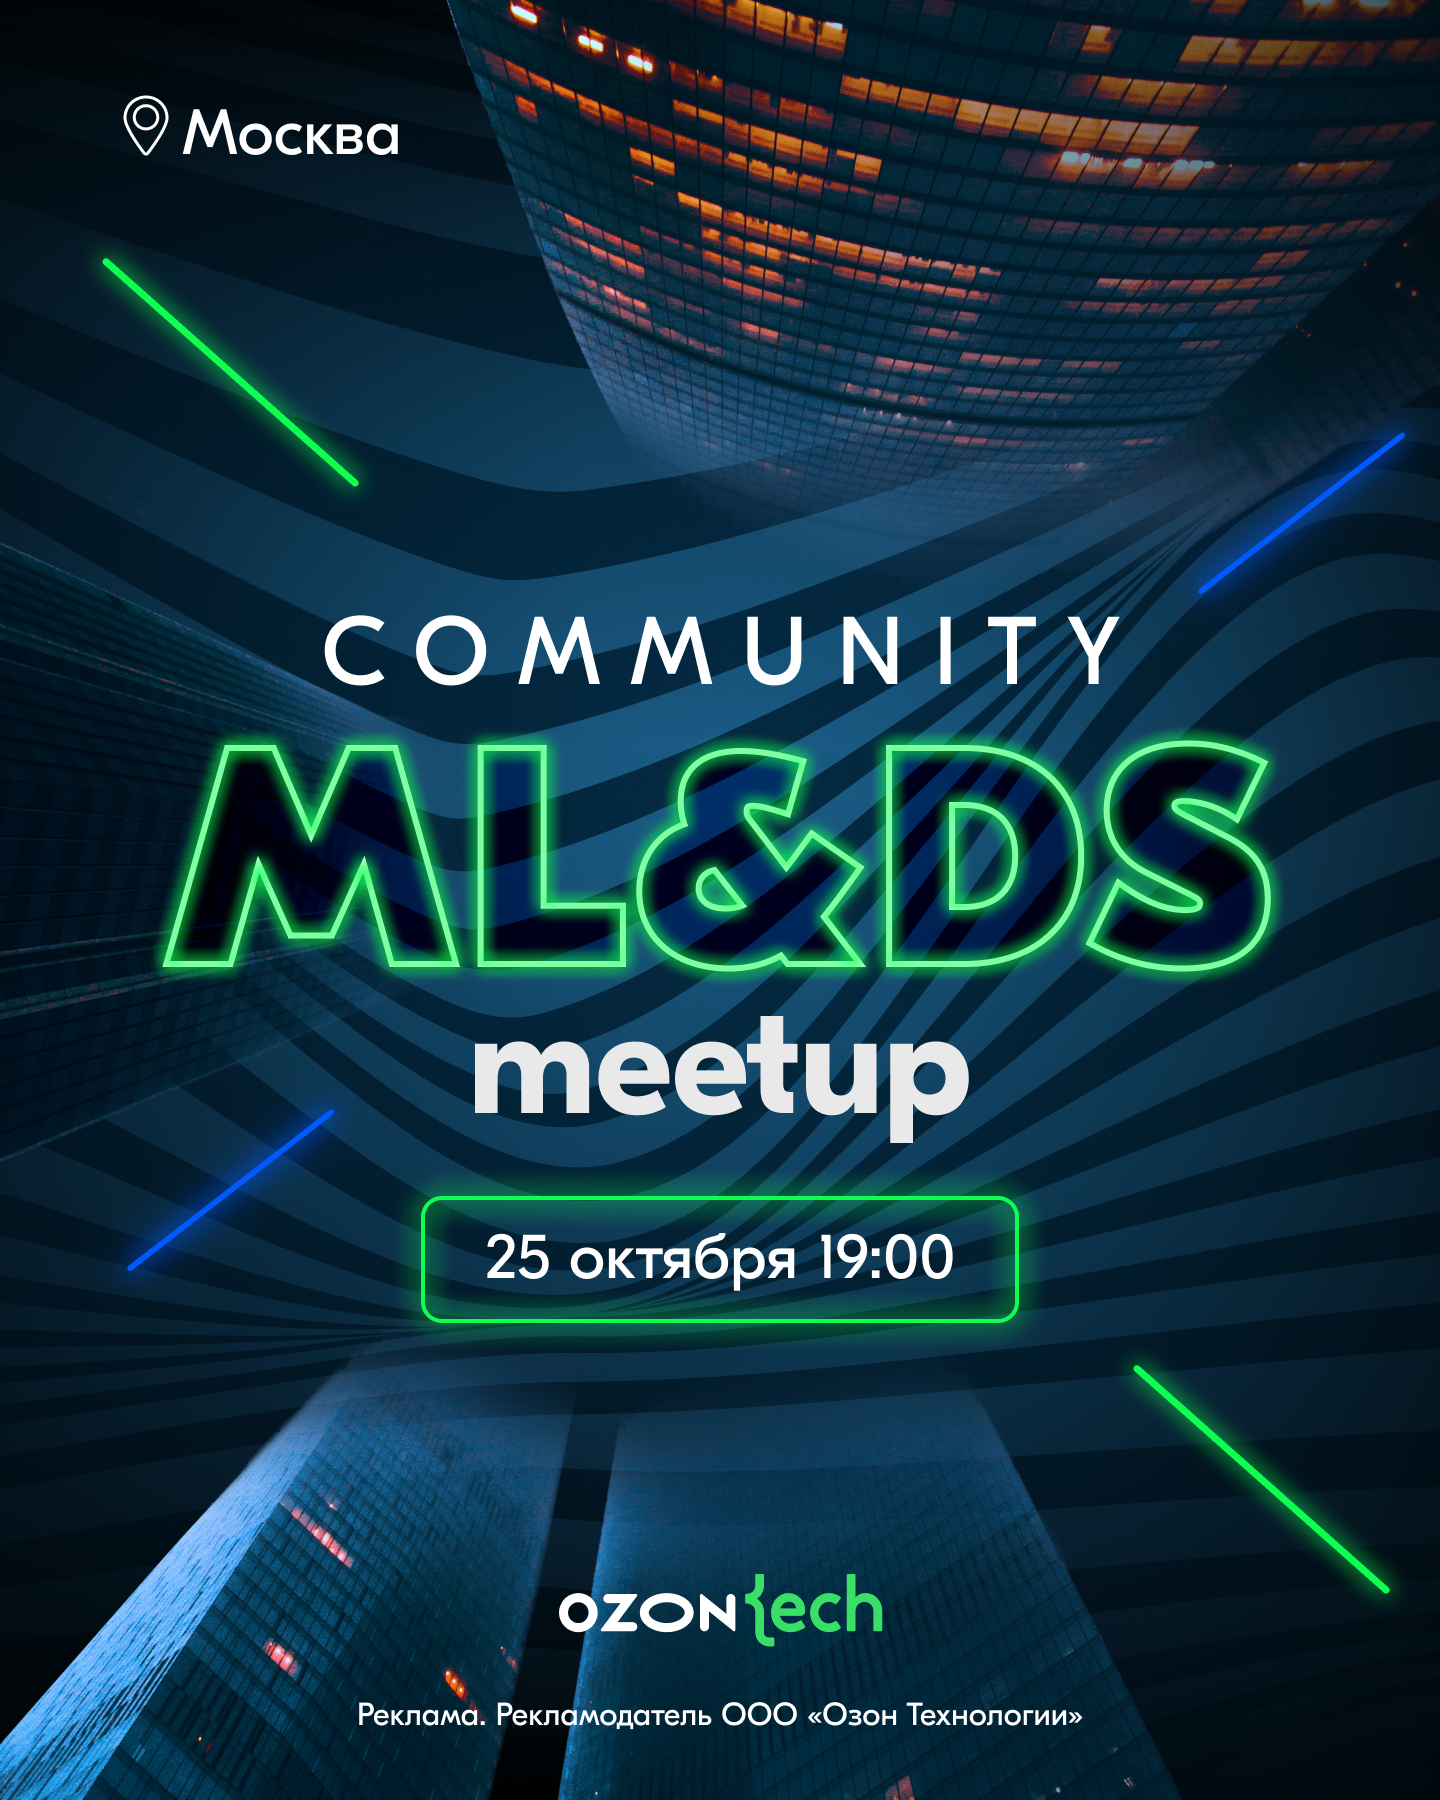
ML&DS митап от Ozon Tech
25 октября | 19:00 мск
онлайн и офлайн
Ozon собрал экспертов по машинному обучению и data science, чтобы устроить оверполезный вечер.
Что обсудят:
1. Общую логику обучения нейросетей, выкатку DeepFM в прод и подводные камни в процессе.
2. Компоненты ML-инфраструктуры Ozon, результаты и планы её развития.
3. Какие алгоритмы оптимизации и машинного обучения используют команды для управления ставками в рекламных кампаниях.
4. Устройство поисковых подсказок в Ozon и процесс внедрения в них персонализации.
5. Любую важную для вас тему со спецами Ozon Tech в перерывах между докладами за пиццей🍕
Бронируйте себе место в офисе для живого общения или регистрируйтесь на онлайн.
Зарегистрироваться
Читать полностью…
Data Science | Machinelearning [ru]
17 October 2023 14:07
👤Как PaaS решил проблемы стандартизации разработки сервиса одной утилитой
В этой статье автор расскажет, почему этот инструмент так важен для разработчика и что он умеет, а что нет.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
16 October 2023 19:07
🖥Построение ML-пайплайна для рекомендательной системы с помощью Google Cloud Platform
В этой статье автор рассмотрит опыт по построению end-to-end рекомендательной ML-системы визуального поиска похожих товаров с помощью инструментов, предоставляемых облачной платформой.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
16 October 2023 11:37
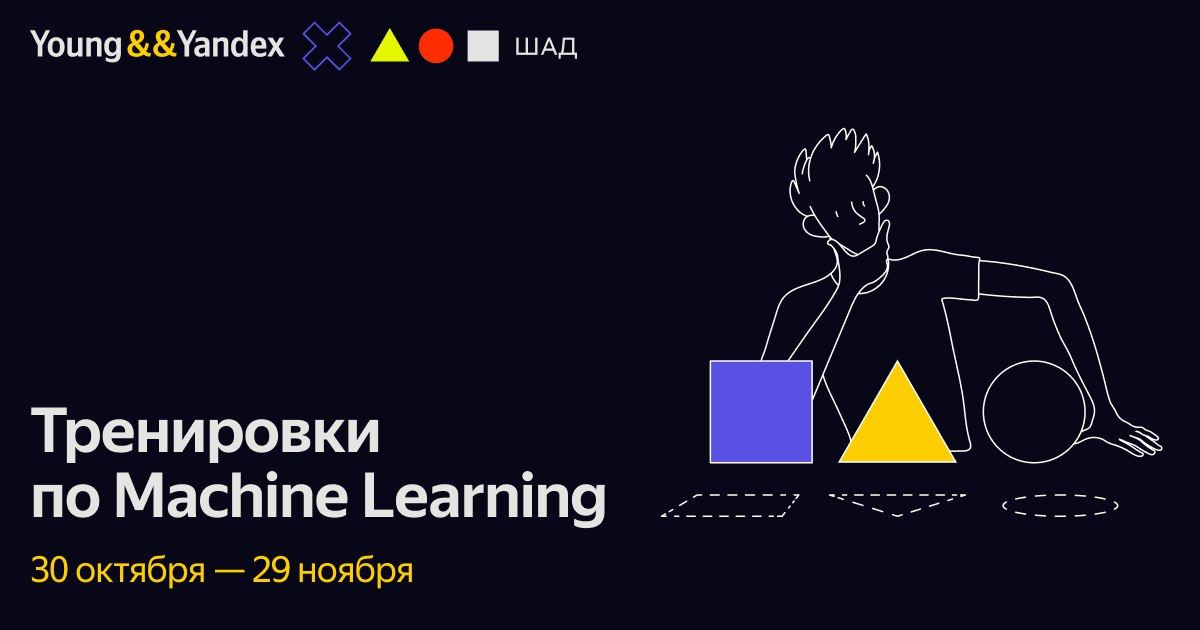
💥Прокачайтесь бесплатно в машинном обучении на бесплатных Тренировках по ML от Яндекса
ML — новое направление Тренировок от Яндекса, которое посвящено классическому машинному обучению. Курс разработан совместно со Школой анализа данных и подойдёт для выпускников технических вузов и начинающих ML-специалистов.
Тренировки пройдут с 30 октября по 29 ноября.
Тренировки по ML — это отличная возможность прокачаться в теме, закрепить знания и подготовиться к отбору в IT-компанию. Здесь вас ждут лекции от экспертов Яндекса, домашние задания и еженедельные онлайн-разборы.
🏆 Участники, которые проявят себя лучше других, получат фаст-трек в Яндекс, а те, кто пройдёт больше половины курса — сертификат о прохождении, который украсит портфолио.
Как проходят Тренировки по ML
1️⃣ Регистрируетесь: участвовать могут все желающие бесплатно и без конкурсного отбора. Старт Тренировок 30 октября.
2️⃣ Смотрите лекции и самостоятельно решаете задачи, которые определяют ваше место в рейтинге участников
3️⃣ Проверяете себя на еженедельных онлайн-разборах
4️⃣ Получаете награды от Яндекса
Я в деле!
Если вы уже чувствуете себя уверенно в направлении ML, то скорее подавайте заявку к нам на стажировку.
Читать полностью…
Data Science | Machinelearning [ru]
15 October 2023 14:07
📚Введение в библиотеку Diffusers и диффузионные модели
В этой статье автор расскажет как работать с сотнями предобученных моделей класса Stable Diffusion для создания изображений и аудио.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
14 October 2023 14:07
🧐Airflow vs NiFi: исследуем оркестратор для формирования витрин данных
В этой статье мы рассмотрим два известных инструмента: Airflow и NiFi, а также постараемся выявить их сильные и слабые стороны.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
13 October 2023 14:08
❄️Контроль за дрейфами предсказательных моделей и Popmon
В данной статье я расскажу, что такое дрейф моделей, почему важно следить за ними, и как это можно сделать с помощью библиотеки Popmon.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
12 October 2023 14:07
💾Полезные методы работы с данными в Pandas. Часть 1
В этой статье мы рассмотрим различные функции и техники для таких задач, как разделение данных на интервалы, квантильное разделение, применение скользящих окон для вычислений, смещение данных для временных рядов, преобразование вложенных структур данных, нормализация сложных JSON-структур и управление многоуровневыми индексами при работе с DataFrame и Series.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
11 October 2023 14:07
📖Apache Spark и PySpark для аналитика. Учимся читать и понимать план запроса в SparkUI
В этой статье мы расскажем, что такое план запроса, как его смотреть, и что делать, чтобы уточнить узкие места в расчётах.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
10 October 2023 14:07
🛣Детекция дефектов дорожного покрытия без размеченных данных: Хакатон, LiDAR, RANSAC, ICP и 44 бесcонных часов
В этой статье я расскажу о том, как мы использовали данные с LiDAR, применяли различные алгоритмы для обработки и анализа информации
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
09 October 2023 14:07
👀Анализ и визуализация данных с помощью библиотеки Altair
В этой статье автор расскажет как с ее помощью вы можете создавать информативные и интерактивные визуализации для вашего анализа данных и проектов.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
08 October 2023 19:12
👁Руководство по масштабированию MLOps
В этом руководстве автор рассмотрит структуру и этапы развития для своей команды.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
07 October 2023 19:07
😶🌫Построение пайплайна анализа данных в реальном времени с помощью Airbyte, Kafka и Pinot
В этой статье рассматриваются три популярных продукта с открытым исходным кодом в области данных: Airbyte, Apache Kafka и Apache Pinot, для создания пользовательского дашборда электронной коммерции, который обновляется в режиме реального времени.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
19 October 2023 13:07
Бизнес, данные и кибер-футуризм: Alfa Data Science Meetup #3 🪩
27 октября в Екатеринбурге пройдет хардовый Alfa DS Meetup #3 Business. Участникам предложат посмотреть на ценности, метрики и особенности CLTV через призму бизнеса и аналитики.
Ребята из Альфы расскажут о том, как успешно справляются с рутиной с помощью машинного обучения, а также всех гостей ждет два отдельных трека докладов.
Только для очных зрителей будет доступна закрытая панельная дискуссия с приглашенными спикерами из билайна и СберМаркета про особенности разработки и применения моделей CLTV и Networking Party.
Когда: 27 октября в 19:00 (по местному времени)
Где: г. Екатеринбург, ул. Горького, д. 7А (офис Альфа-Банка) + онлайн-трансляция
Успейте зарегистрироваться на митап по ссылке — количество мест ограничено!
Реклама. АО "АЛЬФА-БАНК" erid: 2Vtzqxm7VW4
Читать полностью…
Data Science | Machinelearning [ru]
18 October 2023 14:07
🧠Потоковая обработка данных: анализ альтернативных решений
В этой статья я хочу сделать краткое сравнение между двумя opensource-продуктами Apache Spark и Flink, а также рассказать об одной интересной особенности Spark, которую мы реализовали в коннекторе.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
17 October 2023 19:07
😶🌫MLOps в билайн: как катить машинное обучение в production без ML-инженеров. Часть I
В этой статье речь пойдет о нашем опыте создания ML-платформы, которая помогает дата-сайентистам самостоятельно управлять всем жизненным циклом ML-моделей — от разработки до постановки в production.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
17 October 2023 09:07
Erid: Kra23aR2o
28 октября стриминг выйдет за пределы ваших экранов на конференции PlayButton 2023
Спикеры из команд разработки соберутся на большой конференции Кинопоиска о стриминге и обсудят, как из смелых идей появляются фичи и продукты будущего.
Ребята поделятся решениями, которые создают и развивают на контентных сервисах, расскажут про умные рекомендации и работу с платформами.
Приходите, чтобы узнать, как из мира фантазий создаётся реальность. В программе доклады про нейросети, генеративные технологии и другие решения, которые уже сейчас упрощают жизнь разработчикам.
Мероприятие пройдёт онлайн и оффлайн в Москве. Чтобы стать участником, нужно заполнить анкету и пройти модерацию. Количество мест ограничено.
Реклама. ООО «КИНОПОИСК» ИНН 7710688352
Читать полностью…
Data Science | Machinelearning [ru]
16 October 2023 14:07
🥸Kornia — библиотека компьютерного зрения
В этой статье я расскажу о библиотеке для решения задач компьютерного зрения.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
15 October 2023 19:07
😵💫О точности вычислений: как не потерять данные в цифровом шуме
В этой статье я рассмотрю процесс потери точности вычислений, а также расскажу в чём же причина ошибок, если железо работает исправно, а в софте нет багов, влияющих на вычисления.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
14 October 2023 19:07
📊MLOps на примере прогноза движений акций с помощью MLRun
В этой статье автор расскажет о применении MLRun в качестве инструмента MLOps.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
13 October 2023 19:07
🤖Опенсорс-библиотеки для Python: 40+ вариантов, как упростить жизнь начинающего дата-сайентиста
В этой статье автор рассмотрит опенсорсные библиотеки Python, сгруппированные по областям практического применения.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
12 October 2023 19:07
💾Полезные методы работы с данными в Pandas. Часть 2
В этой статье мы погрузимся в применение скользящих окон для вычислений и смещение данных для анализа временных рядов.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
11 October 2023 19:07
📈Как выбрать свое направление в аналитике?
В данной статье мы рассмотрим различные виды аналитических направлений, и какое из них может быть наиболее подходящим для вас.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
10 October 2023 19:07
🧳Аналог Tableau LOD в FineBI: 15 типичных кейсов
В этой статье рассмотрел решение 15 типичных кейсов в Tableau и FineBI, провел сравнение инструментов, а также сделал вывод относительно их преимуществ и недостатков.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
09 October 2023 19:08
✍️Пишем приложение на Python для интерактивной визуализации графов с NetworkX, Plotly и Dash
В этой статье автор расскажет как написать приложения на Python для интерактивной визуализации графов.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
09 October 2023 10:37
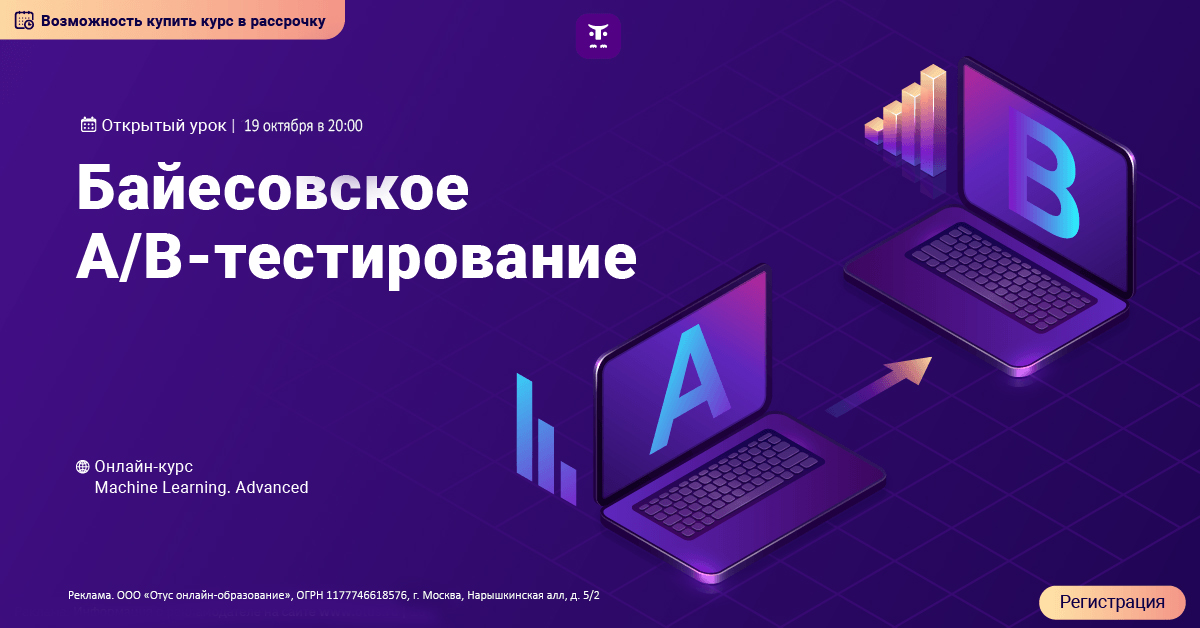
💪 Что такое Байесовское А/B-тестирование и как его провести?
Подробно обсудим 19 октября в 20:00 мск на открытом уроке в OTUS. Занятие приурочено к старту онлайн-курса «Machine Learning. Advanced».
🔹 На вебинаре мы разберем, какие преимущества дают Байесовские A/B тесты по сравнению с обычными, как проводить Байесовские A/B тесты и как работать с Байесовскми моделями в PyMC3.
📌 Результаты урока:
Познакомитесь с основами A/B тестирования и получите новый, простой и эффективный инструмент для A/B тестирования
👉 РЕГИСТРАЦИЯ
Реклама. ООО «Отус онлайн-образование», ОГРН 1177746618576, www.otus.ru, erid: LjN8KJ5cw
Читать полностью…
Data Science | Machinelearning [ru]
08 October 2023 14:07
😵💫Платформа для анализа данных за вечер
В этой статье я расскажу, как всего за час (или почти) подготовить облачное окружение, создать свою небольшую платформу для анализа данных и спарсить весь Hugging Face.
Читать...
Читать полностью…
Data Science | Machinelearning [ru]
07 October 2023 14:07
⏳Построение пайплайна обработки данных в реальном времени с использованием Python
В этой статье мы рассмотрим как построить пайплайн обработки данных в реальном времени с использованием Python.
Читать...
Читать полностью…


 19745