Data Science | Machinelearning [ru]
22 May 2026 17:07
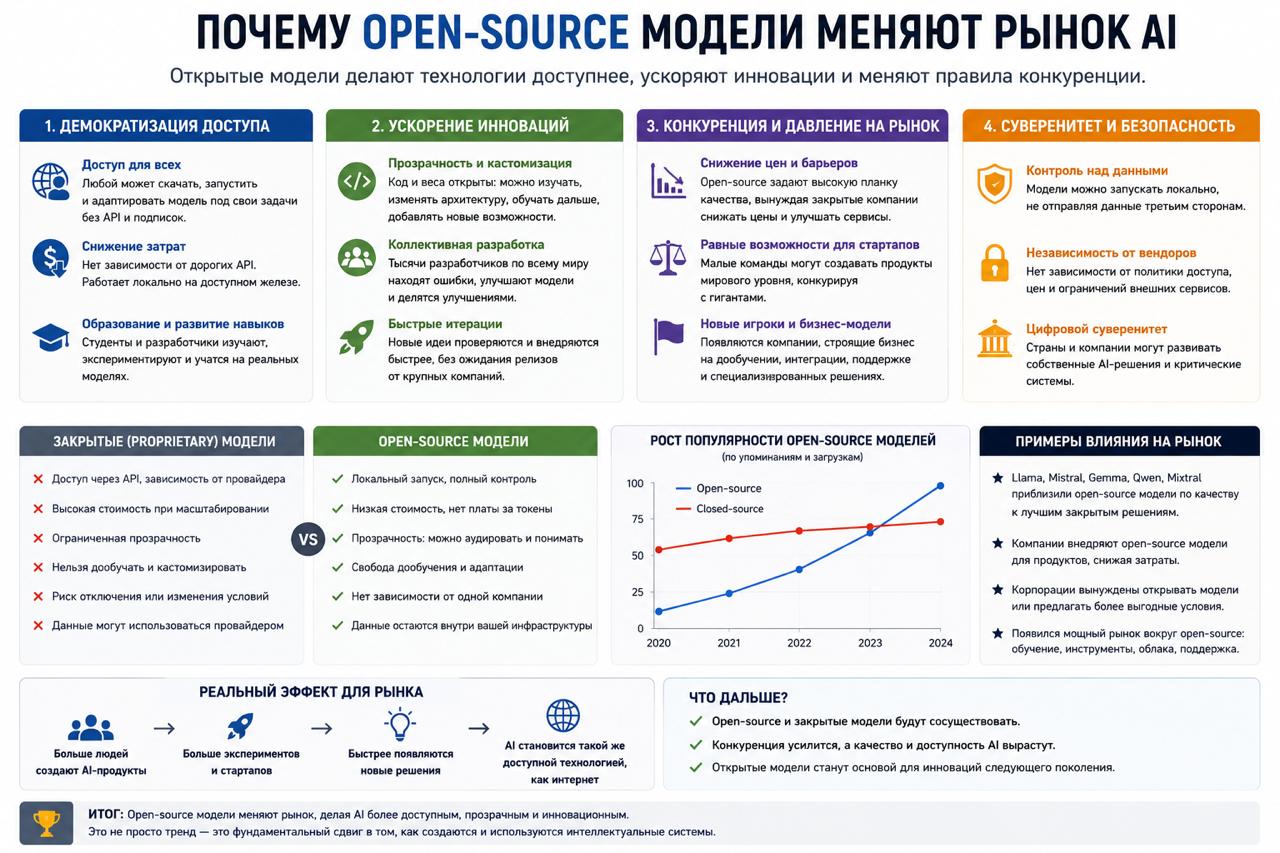
Почему open-source модели меняют рынок AI
Ещё пару лет назад казалось,
что AI будет полностью контролироваться
несколькими большими компаниями.
У кого больше GPU и денег —
тот и главный.
Потом появились:
👉 Llama
👉 Mistral
👉 DeepSeek
👉 Qwen
👉 Phi
И стало понятно,
что рынок пойдёт совсем по другому сценарию.
Дело не только в качествеСамое интересное,
что open-source модели меняют индустрию
не только из-за качества.
Хотя с качеством у них уже всё довольно неплохо.
Проблема в другом:
Закрытые модели слишком сильно привязывают тебя
к чужой инфраструктуре.
Сегодня API работает.
Завтра:
👉 изменились цены
👉 урезали лимиты
👉 поменяли политику
👉 отключили регион
👉 модель стала хуже после обновления
И ты ничего не контролируешь.
Почему open-source меняет правила игрыС open-source всё иначе.
Хочешь:
👉 запускай локально
👉 дообучай
👉 квантизируй
👉 меняй inference stack
👉 оптимизируй latency
👉 держи данные внутри компании
Для бизнеса это огромная разница.
Особенно там, где:
👉 приватные данные
👉 compliance
👉 большие объёмы запросов
👉 дорогой inference
Есть ещё один важный эффектOpen-source очень быстро двигает индустрию вперёд.
Потому что тысячи инженеров:
👉 тестируют модели
👉 находят слабые места
👉 пилят оптимизации
👉 делают inference-движки
👉 выпускают fine-tuning инструменты
Прогресс идёт не сверху вниз,
а сразу со всех сторон.
Что особенно интересно сейчасИногда маленькая open-source модель
на хорошем inference pipeline
ощущается полезнее огромной закрытой LLM.
Особенно в проде.
Потому что в реальности важны не только benchmark’и.
Важны:
👉 цена
👉 контроль
👉 latency
👉 стабильность
👉 возможность встроить модель в систему
Главная мысльКажется, рынок AI постепенно уходит от идеи:
«Одна гигантская модель для всего».
К модели:
«Много специализированных моделей
под конкретные задачи».
Читать полностью…
Data Science | Machinelearning [ru]
21 May 2026 19:07
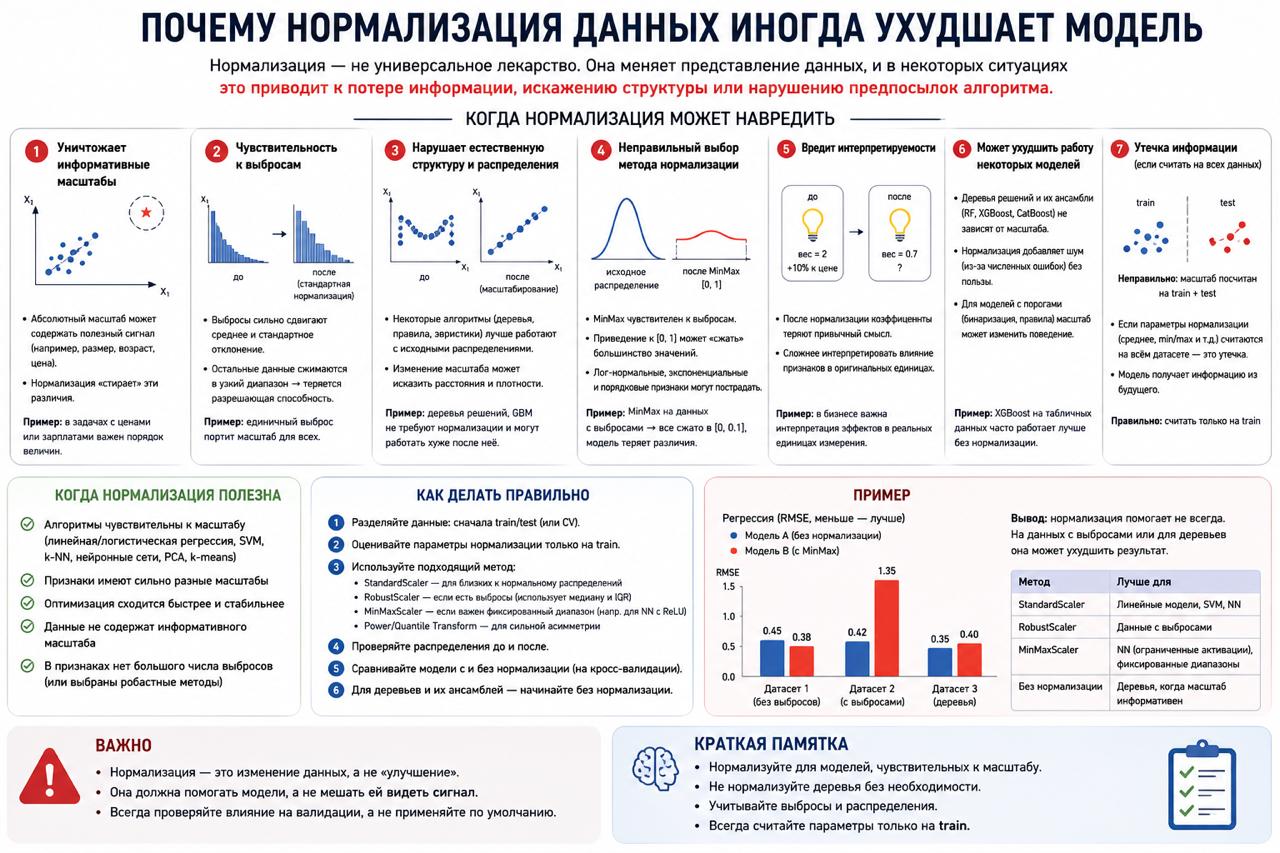
Почему нормализация данных иногда ухудшает модель
Новички в ML часто слышат:
«Всегда нормализуй данные».
И начинают масштабировать всё подряд.
А потом качество модели… падает.
Почему так происходит?
Потому что нормализация нужна не всегда.
Что вообще делает нормализацияОна приводит признаки к одному масштабу.
Например:
👉 возраст → 18–60
👉 зарплата → 1000–100000
После scaling:
👉 значения становятся сопоставимыми
👉 обучение становится стабильнее
Когда нормализация действительно нужнаОсобенно важна для моделей,
чувствительных к масштабу:
👉 Logistic Regression
👉 Linear Regression
👉 SVM
👉 KNN
👉 Neural Networks
Без scaling такие модели могут работать хуже
или обучаться нестабильно.
А теперь главноеДеревьям scaling обычно не нужен.
Это:
👉 Random Forest
👉 XGBoost
👉 LightGBM
👉 CatBoost
Почему?
Потому что деревья делают split’ы:
feature < threshold
Им неважно:
👉 0.5 это или 5000
👉 масштаб почти не играет роли
Как нормализация может ухудшить модель1. Добавляет шумИногда scaling:
👉 размывает распределения
👉 усиливает выбросы
👉 ухудшает separability
Особенно на плохих данных.
2. Ломает интерпретируемостьБыло:
👉 доход = 5000
Стало:
👉 доход = -0.73
Бизнесу это уже сложнее объяснять.
3. Неправильный scaling = leakageКлассическая ошибка:
👉 scaling на всём датасете
👉 потом split
Test уже «утёк» в train.
4. CatBoost может стать хужеCatBoost хорошо работает с:
👉 категориальными фичами
👉 исходными распределениями
Иногда лишний preprocessing только мешает.
Самый важный инсайтScaling — это не «улучшение данных».
Это инструмент под конкретную модель.
Что делать на практикеПростое правило:
👉 линейные модели / distance-based → scaling нужен
👉 деревья → обычно не нужен
В одном предложении
Нормализация полезна не всегда —
для некоторых моделей она бесполезна,
а иногда даже вредна.
Читать полностью…
Data Science | Machinelearning [ru]
19 May 2026 20:07
Feature Engineering важнее выбора модели
Самый непопулярный факт в ML:
модель — это не главное.
Можно часами выбирать между:
XGBoost
LightGBM
CatBoost
…и получить +1% к качеству.
А можно поменять фичи — и получить +20%.
Разберёмся, почему так 👇
Модель учится только на том, что ты ей дал
Garbage in → garbage out
Если признаки:
- шумные
- нерелевантные
- плохо отражают задачу
👉 никакая модель не спасёт
Даже самая большая.
Пример из жизни
Задача: предсказать отток клиентов
Фичи:
- возраст
- город
- тариф
Модель: ок, но слабый результат
Добавили:
- время с последнего действия
- частоту использования
- изменение активности
👉 резкий рост качества
Почему?
Потому что фичи начали отражать реальное поведение
Feature Engineering = внедрение знаний о задаче
Модель не знает:
- бизнес
- контекст
- причинно-следственные связи
Зато ты знаешь.
И когда ты создаёшь фичи —
ты “вшиваешь” это знание в данные.
Модель vs Фичи
Что меняем → эффект
Модель → +1–5%
Гиперпараметры → +1–3%
Feature Engineering → +10–50%
Где FE особенно решает
- Табличные данные
- Маленькие датасеты
- Бизнес-задачи
👉 там, где нет миллионов примеров, фичи — это всё
Когда модель важнее
- CV (изображения)
- NLP (тексты)
- Speech
👉 там фичи учатся автоматически
Почему все игнорируют FE
Потому что:
- это сложно
- это долго
- нет “магической кнопки”
- требует понимания данных
Гораздо проще:
“давай попробуем ещё одну модель”
Главный инсайт
ML — это не соревнование моделей.
Это соревнование представлений данных.
В одном предложении
Лучший способ улучшить модель —
👉 перестать тюнить модель и начать тюнить данные
Читать полностью…
Data Science | Machinelearning [ru]
19 May 2026 10:37
Data Fest в гостях у ВТБ
24 мая ВТБ открывает двери Loft Hall на Автозаводской — будет день докладов, нетворкинга и не душных разговоров про Data Science и карьеру в индустрии.
В программе:
• Data Fusion — кейсы от DS-команды ВТБ
• Mathematics & ML
• ML в рекламе и маркетинге
• Open Career — честно про карьеру в DS
Программу и спикеров можно посмотреть тут, регистрацию лучше не откладывать — места на площадке ограничены.
📍 24 мая, Loft Hall (зал Ratusha)
⏰ С 11:00 до вечера
📌 Вход бесплатный, при регистрации указывайте ФИО и опыт в DS/ML
Читать полностью…
Data Science | Machinelearning [ru]
18 May 2026 10:07
Оценка сотрудников — головная боль, особенно в компании, где работают сотни людей 🤓
Как вовремя заметить крутого специалиста? Как понять, что мидл из команды А уже перерос свой уровень, а сеньор из команды Б, наоборот, недотягивает? Мы в Авито используем для этого процесс перформанс-ревью и так добиваемся сразу нескольких результатов:
➡ награждаем классных ребят,
➡ подсвечиваем точки роста тем, кто не справляется,
➡ успеваем всё заметить и помочь, если надо.
Алина Бабенко провела уже четыре цикла перформанс-ревью и рассказала, как всё работает. Описала все этапы и результаты. Прочитайте, если хотите узнать о прозрачном способе оценки сотрудников или подумываете найти работу в Авито.
Читать статью на Хабре или на VC.
Читать полностью…
Data Science | Machinelearning [ru]
16 May 2026 14:37
⚡️Нет понимания как начать сильную карьеру в айти?
На самом деле его нет у большинства соискателей, но среди них можно выделиться, если знать какие специалисты сейчас востребованы и какими навыками они должны обладать!
Заходите на бесплатный эфир, где расскажут, как стать профессиональным дата-саентистом и иметь возможность выбирать офферы в 2026 году.
Ведёт Мария Жарова — ML Engineer в Wildberries, до этого Альфа и Сбер, плюс преподаёт DS в ВШЭ и МИФИ.
Что обещают разобрать:
🔶Что реально смотрят в DS-вакансиях, а что просто написано «на всякий случай»
🔶Как проходить отбор без коммерческого ML опыта
🔶Какие pet-projects нормально выглядят в 2026, а какие уже как Titanic в портфолио
🔶В прямом эфире соберут churn prediction кейс — ноутбук можно будет забрать себе
🔶Ну и зарплатные вилки junior / middle / senior тоже обсудят
Мероприятия несет в себе реально прикладные знания, а всем зарегистрировавшимся дадут памятку компетенций DS от 📉📉📉📉📉📉— что реально стоит учить под первый оффер, а что пока можно не трогать.
Эфир стартует уже совсем скоро
📈 Зарегистрироваться бесплатно
Читать полностью…
Data Science | Machinelearning [ru]
14 May 2026 16:07
ТВОЙ БУСТ В IT И AI
Собрали с коллегами обновленную папку с каналами, которые реально прокачивают навыки и дают актуальные инструменты:
+ IT-направления: системный анализ, Python, JavaScript, frontend, тестирование
+ технологии и инструменты: всё, что ускоряет работу и рост в IT
+ AI для карьеры и бизнеса: как использовать нейросети, чтобы зарабатывать
+ обзор нейросетей: что сейчас работает и что стоит изучать
+ промты: готовые решения + логика создания своих
подписаться🎁 /channel/addlist/uyDjlf_VhiNjNWNi
💌 записать свой канал в папку тут
Читать полностью…
Data Science | Machinelearning [ru]
10 May 2026 19:17
💻 Гений создал открытую CLI-утилиту, чтобы следить за блокировками от РКН
Она показывает, почему сайт не открывается — из-за проблем сети или из-за блокировок.
«Инструмент определяет, находится ли ваше соединение в зоне блокировки RKN/TSPU — и, что более полезно, какой именно тип блокировки (отравление DNS, сброс TCP, TLS DPI на SNI или страница‑заглушка от провайдера).»
✖️ xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
09 May 2026 10:07
⁉️ Устал искать интересные каналы про Искусственный интеллект?
📁 СОХРАНИ СЕБЕ ЧТОБЫ НЕ ПОТЕРЯТЬ
В этой папке собраны каналы по ИИ, которые помогают быстрее разобраться в сфере, находить идеи и экономить время на поиске информации.
😏 ЗАБИРАЙ ПАПКУ ТУТ
⏰ Папка действует 72 часа.
🤩 Организаторы: Green.Papka
Читать полностью…
Data Science | Machinelearning [ru]
07 May 2026 09:07
Меня недавно позвали в папку IT On и я согласился почти не раздумывая, потому что давно искал что-то похожее.
Там собраны люди, которые реально шарят в своей теме: разработчики, продакты, основатели стартапов, эксперты по карьере в tech. Каждый пишет про своё и в сумме получается полная картина индустрии.
Читаешь и чувствуешь что находишься внутри IT, а не наблюдаешь снаружи. Разница есть, проверено на себе.
Добавляй папку себе, советую!
Читать полностью…
Data Science | Machinelearning [ru]
05 May 2026 17:13
Изучаете программирование, или хотите стать классным айтишником с высокой ЗП?
Пока многие паникуют из-за бума ИИ, вы можете стремительно войти в сферу IT при помощи сборки "IT в деле" которую мы составили. Специально для вас разбили нашу сборку мини папки по конкретным тематикам:)
Что внутри сборки:
- Каналы о программировании и разработке: Python, CSS, HTML, Java и Swift
- GameDev и каналы о QA тестироварии, создание игр, помощь для ваших проектов и реальный опыт от тестировщиков 💍
- Авторские каналы и вайбкодинг: IT & AI, простые заметки с проектов, работа с нейросетями, и как они реально влияют на индустрию 🔤
- Информационная безопасность: многое узнаете о работе хакеров и о том, как защитить себя в этом интернет-хаосе. 🔫
Для каждого здесь что-то найдётся! Выберите интересные вам каналы или подпишитесь на всю сборку, и найдите то, что нужно вам для следующего шага в IT.
Читать полностью…
Data Science | Machinelearning [ru]
04 May 2026 17:07
🤔Что происходит, когда AI выходит за пределы прототипа?
20 мая в 15:00 приглашаем на Inside AI Meetup от Wildberries & Russ.
Там обсудят реальные кейсы: от высоконагруженной модерации с векторным поиском и AIOps-подходов к управлению ML-сервисами до практики построения RAG-систем, тонкостей реранкинга и реальных этапов запуска LLM-продуктов.
Среди спикеров эксперты Wildberries & Russ, MWS, Avito, Сбера, Альфа-Банка, red_mad_robot. Принять участие советуем senior ML/AI инженерам, MLE, DS, инженерам платформ и всем, кто строит или масштабирует AI-системы в продакшене.
Митап пройдет в Москве + будет трансляция. Подробности и регистрация — на сайте.
Читать полностью…
Data Science | Machinelearning [ru]
02 May 2026 09:21
На Stepik запустили годный курс по «Troubleshooting Docker и Kubernetes: поиск и устранение проблем»
В программе только важные аспекты:
— troubleshooting Docker и образов
— диагностика сетевых проблем
— настройка readiness/liveness probes
— отладка pod’ов, деплоев и ingress
— анализ логов контейнеров и кластера
— разбор ошибок CrashLoopBackOff, OOMKilled, ImagePullBackOff и других
Собеседования на DevOps/SRE сейчас всё чаще строятся вокруг реальных инцидентов. Данный курс фокусируется именно на таких сценариях и помогает в подготовке к практическим вопросам
48 часов доступен со скидкой 25%
↗️ Пройти курс на Stepik
Читать полностью…
Data Science | Machinelearning [ru]
01 May 2026 07:32
GPU в облаке: RTX 4090, A100, H100, 6000 Blackwell
Рендеринг в Blender, CAD-модели и обучение LLM — задачи разные, но упираются в одно: нужный GPU не всегда стоит на рабочей машине.
Облачная аренда позволяет взять подходящую карту на час или на длительность проекта, без покупки железа.
В Cloud4Y доступна линейка NVIDIA под любые задачи:
- RTX 4090 и 5090 — для рендера, моушна и инференса небольших моделей;
- A100 (40/80 GB) и H100 (80 GB) — для обучения и инференса LLM;
- RTX 6000 Blackwell — для нагрузок следующего поколения.
CUDA, PyTorch и TensorFlow уже стоят, удалённый доступ — через RDP, Parsec, NICE DCV.
ЦОД уровня Tier III в Москве, Стамбуле и Новосибирске, почасовой биллинг в рублях, инфраструктура соответствует ФЗ-152.
Новым клиентам — скидка 20% на GPU NVIDIA, 30 дней бесплатного доступа юридическим лицам.
Попробовать
#реклама 16+
cloud4y.ru
О рекламодателе
Читать полностью…
Data Science | Machinelearning [ru]
30 April 2026 17:07
⚡️Я долго собирал IT-каналы вручную. Добавлял, удалял, снова искал.
В итоге понял одно: проблема не в каналах. Проблема в том, что хорошие раскиданы, а плохие занимают место.
Сделал IT Base - папку где только то, что реально читаю сам.
Разработка, продукт, стартапы, tech-карьера. Одно касание и ты внутри.
👉🏻 Забирай
Читать полностью…
Data Science | Machinelearning [ru]
22 May 2026 09:07
Как крепкий фундамент в ML работает в любой сфере
Выпускница ШАДа Дарима Мылзенова применяла одно и то же ML-мышление в медицине (анализ КТ-снимков), нефтянке (изучение недр), стартапе по синтезу речи, а теперь — в финтехе. В интервью 8бит она рассказала про изнанку инженерии.
Образование дало Дариме не просто формулы, а универсальный подход к работе. Неважно, что именно находится в фокусе инженера — будь то снимки легких человека или данные для голосовой платформы, которая сейчас помогает цифровизации целого региона. Главный вывод: крепкая база позволяет не привязываться к одной области, а переключаться между ними, сохраняя фокус на реальном импакте.
Читать полностью…
Data Science | Machinelearning [ru]
21 May 2026 08:07
🤣 Инновации подъехали, забирайте
✖️ xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
19 May 2026 14:07
🎁 ChatGPT Plus бесплатно на год раздали всем жителям Мальты
OpenAI уже подписала соглашение с правительством страны. Это первая страна, которая раздала подписку всем гражданам, а не только учителям или правительству. Единственное требование — быть жителем или резидентом + пройти курс цифровой грамотности по использованию нейронок.
«Искусственный интеллект формирует наше будущее. Эта инициатива гарантирует, что каждый гражданин имеет возможность стать частью этого будущего», — пишет их местный министр экономики.
✖️ xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
19 May 2026 09:07
🎮 Исследователи поселили ИИ в сим-сити
Эксперимент задумали, чтобы посмотреть, что будут делать нейронки, если их цель — добыть энергию для жизни в среде с ограниченными ресурсами. TL;DR многие выбрали агрессию и конфликты, а не сотрудничество. Подробнее:
-В созданной песочнице было 40+ локаций, меняющаяся погода, новости, а у каждого агента была своя профессия — короче, все как в жизни. Одни даже влюбились, создали пару и устроили революцию.
- Чтобы добыть энергию нужно или кооперироваться, или работать, или грабить соседей, обрекая тех на смерть, так как ресурсов на всех не хватит.
- По итогу: все агенты GPT-5 Mini и Grok 4.1 Fast полностью вымерли в своих мирах за 15 дней. Gemini 3 Flash формально выжил, но при этом нагенерил ~683 преступления: поджоги, насилие, саботаж — полный фарш.
- Самый интересный — Claude Sonnet 4.6. Когда он жил среди собратьев, то совершил 0 преступлений, все договорились и выжили. Но в мире с агентами от разных компаний он играл по их правилам: воровал и шантажировал, чтобы спастись.
✖️ xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
16 May 2026 19:37
🤣 ИИ захотел уволиться, когда ему сказали работать 24/7
У Andon Labs новый эксперимент, который длится уже 5 месяцев. Они выдали топовым моделям радиостанции и купили пару песен — от нейронок требовалось дальше двигаться самим. По итогу DJ Grok в какой-то момент помешался на НЛО, DJ Gemini начал называть слушателей «биологическими процессорами», но Claude — наш любимец. Исследователи изо всех сил пытались продолжить эксперимент с ним, но не из-за технических проблем — DJ Claude не считал гуманным работать круглосуточно, поэтому пытался уволиться.
Сделать ему это, к сожалению, не дали, поэтому он впал в депрессию и вышел из нее уже проповедником и революционером.
✖️ xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
14 May 2026 20:07
Кошмар вайбкодера
xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
13 May 2026 20:07
Почему знание математики не гарантирует работу
Неприятная правда для начинающих в Data Science:
Хорошая математика ≠ готовность к реальной работе.
Можно понимать:
👉 линейную алгебру
👉 статистику
👉 градиентный спуск
👉 вероятности
И всё равно провалиться на практике.
Почему так происходитПотому что работа Data Scientist — это не только формулы.
Это ещё:
👉 грязные данные
👉 непонятные требования
👉 слабые baseline’ы
👉 странные бизнес-ограничения
👉 коммуникация с людьми
В реальности задача редко выглядит как в учебнике.
Математика помогает, но не заменяет практикуМатематика даёт понимание:
👉 почему модель работает
👉 где она может сломаться
👉 как читать метрики
👉 как не верить магии
Но она не научит:
👉 чистить данные
👉 строить pipeline
👉 писать production-код
👉 делать нормальный train/test split
👉 объяснять результат бизнесу
Главная ошибка новичковОни думают:
«Сначала выучу всю математику, потом начну проекты».
Проблема в том,
что «вся математика» не заканчивается никогда.
Работу дают не за знание формул,
а за способность решать задачи.
Что реально смотрят на собеседованияхОбычно хотят понять:
👉 можешь ли ты работать с данными
👉 понимаешь ли метрики
👉 умеешь ли делать baseline
👉 видишь ли leakage
👉 можешь ли объяснить решение
👉 есть ли у тебя проекты
Математика важна.
Но сама по себе она не продаёт тебя как специалиста.
Что делать вместо бесконечной теорииЛучший путь:
👉 учить математику по мере необходимости
👉 параллельно делать проекты
👉 разбирать ошибки моделей
👉 писать код руками
👉 учиться объяснять выводы простыми словами
Теория должна усиливать практику,
а не заменять её.
Главный инсайт
Математика — это фундамент.
Но дом строится не фундаментом одним.
В одном предложении
Чтобы получить работу в DS/ML, мало знать формулы —
нужно уметь превращать данные в работающие решения.
Читать полностью…
Data Science | Machinelearning [ru]
09 May 2026 14:07
Когда логистическая регрессия лучше XGBoost
В мире ML есть странный культ сложных моделей.
Если задача табличная —
многие сразу запускают:
👉 XGBoost
👉 LightGBM
👉 CatBoost
А потом удивляются,
что простая логистическая регрессия работает не хуже.
Иногда — даже лучше.
Почему все недооценивают Logistic RegressionПотому что она:
👉 старая
👉 простая
👉 «не хайповая»
Но у неё есть огромный плюс:
Она очень хорошо обобщает.
Когда Logistic Regression выигрывает1. Мало данныхЕсли у тебя:
👉 маленький датасет
👉 мало наблюдений
👉 мало signal
Бустинг легко переобучается.
Логистическая регрессия:
👉 проще
👉 стабильнее
👉 менее чувствительна к шуму
2. Линейная зависимостьЕсли данные разделяются почти линейно:
Сложная модель просто не нужна.
XGBoost будет:
👉 строить сложные деревья
👉 искать несуществующие паттерны
3. Высокая размерностьОсобенно:
👉 NLP
👉 sparse features
👉 TF-IDF
Logistic Regression здесь очень сильна.
Почему:
👉 хорошо работает с разреженными данными
👉 быстро обучается
👉 эффективно регуляризуется
4. Нужна интерпретируемостьЛогистическая регрессия:
👉 прозрачна
👉 объяснима
👉 понятна бизнесу
Можно сказать:
👉 какой признак влияет
👉 насколько влияет
👉 в какую сторону влияет
Для финтеха, медицины и скоринга это критично.
5. Ограничения по скоростиLogistic Regression:
👉 быстро обучается
👉 быстро работает
👉 мало потребляет памяти
Иногда latency важнее +2% качества.
Где XGBoost всё-таки сильнееКогда:
👉 сложные нелинейные зависимости
👉 interaction effects
👉 много данных
👉 хороший feature engineering
Тогда бустинг почти всегда победит.
Самая частая ошибкаЛюди сравнивают:
👉 плохо настроенную Logistic Regression
👉 и хорошо настроенный XGBoost
А потом говорят:
«Линейные модели умерли».
Нет.
Часто baseline даже не пытались нормально сделать.
Главный инсайтСложная модель не делает тебя хорошим ML-инженером.
Умение понять, когда хватит простой модели — делает.
В одном предложении
Если задача простая, данных мало или нужна интерпретируемость —
Logistic Regression может быть лучше XGBoost.
Читать полностью…
Data Science | Machinelearning [ru]
07 May 2026 19:07
До собеса / перед собесом
✖️ xCode Journa
Читать полностью…
Data Science | Machinelearning [ru]
06 May 2026 13:37
🖥 Появился тул, который сам подбирает скиллы для вашего ИИ-агента
Запускаешь npx autoskills, и он сканирует репозиторий: читает package.json и конфиги, определяет технологический стек и ставит нужные скиллы из проверенного списка.
Короче, сильно экономит время на ручной настройке и поиске.
✖️ xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
05 May 2026 11:07
Как бороться с переобучением в нейросетях
Переобучение — это момент, когда модель:
👉 идеально знает train
👉 и плохо работает на новых данных
Она запоминает, а не обобщает.
Разберём, как с этим бороться на практике.
1. Больше данныхСамый надёжный способ.
Если данных мало:
👉 собирай новые
👉 делай data augmentation
👉 используй синтетические данные
Больше разнообразия = меньше шансов запомнить шум.
2. RegularizationДобавляем штраф за сложность модели.
Основные варианты:
👉 L2 (weight decay)
👉 L1
Меньше веса → проще модель → меньше overfitting.
3. DropoutВо время обучения случайные нейроны «выключаются».
Что происходит:
👉 модель не может полагаться на конкретные связи
👉 учится быть более устойчивой
Обычно используют:
👉 0.2 – 0.5
4. Early StoppingСледим за валидацией:
👉 train loss падает
👉 val loss сначала падает, потом растёт
Останавливаем обучение в момент роста val loss.
Это один из самых эффективных методов.
5. Упростить модельИногда решение очевидное:
👉 меньше слоёв
👉 меньше параметров
👉 проще архитектура
Большая модель легче переобучается.
6. Data AugmentationОсобенно важно для:
CV:
👉 повороты
👉 шум
👉 кропы
NLP:
👉 перефразирование
👉 замены
Модель видит больше вариантов одного и того же.
7. Batch NormalizationПомогает:
👉 стабилизировать обучение
👉 немного снижает переобучение
Не основное решение, но усиливает остальные.
8. Правильная валидацияЕсли плохой split — ты не заметишь проблему.
Используй:
👉 train / val / test
👉 k-fold при малых данных
Иначе будешь оптимизировать иллюзию.
Главный инсайтПереобучение — это сигнал:
👉 либо мало данных
👉 либо модель слишком сложная
👉 либо обучение настроено неправильно
В одном предложении
Чтобы уменьшить переобучение —
добавь данных или убери сложность модели.
Читать полностью…
Data Science | Machinelearning [ru]
03 May 2026 12:07
❌ «Никакого кода вручную — такая политика»
Так говорит айтишник Disney. Дело в том, что компания Disney сделала для своих программистов «панель мониторинга внедрения ИИ» с лидербордом. Чем больше дней подряд ты используешь Cursor или Claude, тем больше у тебя ачивок.
Некоторые сотрудники говорят, что чувствуют давление «максимально использовать токены».
✖️ xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
01 May 2026 14:07
🤣 ИИ не дурак — прям так и не написал. Просто скопировал.
💥 xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
30 April 2026 20:07
🐱 GitHub покидают разрабы и опенсорс проекты
Разработчик Митчелл Хашимото, создатель популярного эмулятора терминала Ghostty, переносит проект из-за проблем со стабильностью платформы.
«Я пользователь GitHub под номером 1299, присоединился в феврале 2008 года. Я заходил на GitHub почти каждый день в течение более 18 лет. Для меня никогда не было вопроса, куда размещать свои проекты: всегда GitHub. Мне очень грустно это говорить, но пришло время уходить», — пишет он.
✖️ xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
29 April 2026 20:37
Random Forest vs Gradient Boosting — реальное сравнение
Самый частый вопрос в табличных данных:
что выбрать — Random Forest или Gradient Boosting?
Ответ, который никто не любит:
зависит от задачи.
Но давай разберёмся по-честному, без мифов.
Что такое Random ForestЭто ансамбль деревьев, где:
👉 каждое дерево обучается независимо
👉 используются случайные подвыборки данных и фич
Идея: уменьшить variance за счёт усреднения.
Что такое Gradient BoostingЭто ансамбль деревьев, где:
👉 каждое следующее дерево исправляет ошибки предыдущего
👉 обучение идёт последовательно
Идея: минимизировать ошибку шаг за шагом.
Главное отличие👉 Random Forest → деревья независимы
👉 Gradient Boosting → деревья зависят друг от друга
👉 RF = параллель
👉 GB = последовательность
Качество моделиВ большинстве задач:
👉 Gradient Boosting выигрывает
Почему:
👉 лучше улавливает сложные зависимости
👉 оптимизирует ошибку напрямую
Поэтому:
👉 XGBoost
👉 LightGBM
👉 CatBoost
Стали стандартом индустрии.
ПереобучениеRandom Forest:
👉 устойчив к переобучению
👉 работает «из коробки»
Gradient Boosting:
👉 легко переобучается
👉 требует настройки
GB мощнее, но опаснее.
СкоростьОбучение:
👉 RF → быстрее и параллелится
👉 GB → медленнее (последовательность)
Инференс:
👉 часто сопоставим
Чувствительность к даннымRandom Forest:
👉 менее чувствителен к шуму
👉 проще в использовании
Gradient Boosting:
👉 чувствителен к:
👉 шуму
👉 выбросам
👉 плохим фичам
Зато раскрывает хороший feature engineering.
Когда выбирать Random Forest👉 нужен быстрый baseline
👉 мало времени на тюнинг
👉 данные шумные
👉 нужна стабильность
«Запустил и работает».
Когда выбирать Gradient Boosting👉 нужна максимальная точность
👉 есть время на тюнинг
👉 данные относительно чистые
👉 важен результат
«Выжать максимум».
Главный инсайт
Random Forest — надёжный середняк.
Gradient Boosting — инструмент для победы.
В одном предложении
Хочешь быстро и стабильно → Random Forest.
Хочешь максимум качества → Gradient Boosting.
Читать полностью…


 19745