Data Science | Machinelearning [ru]
28 May 2026 17:07
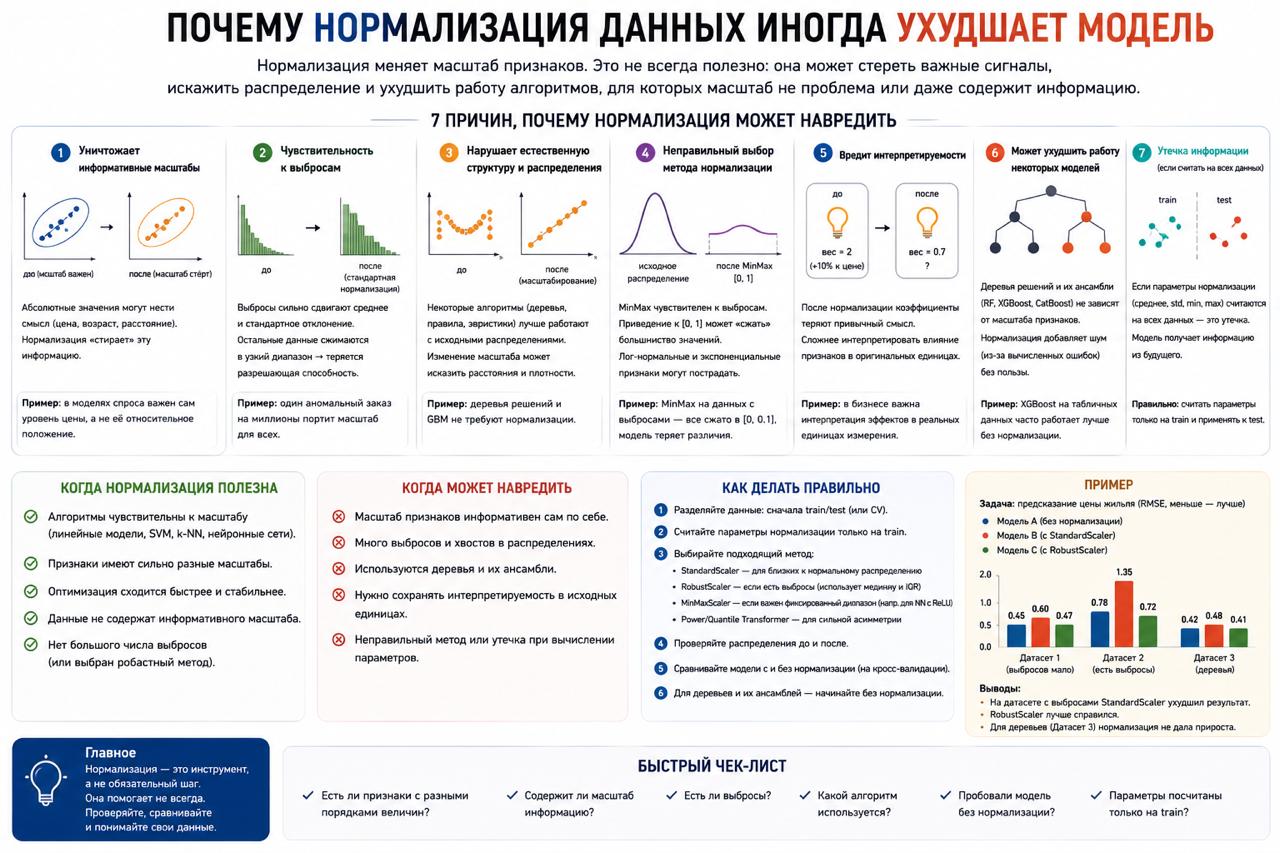
Почему нормализация данных иногда ухудшает модель
Есть совет,
который почти все слышат в начале изучения ML:
«Всегда нормализуй данные».
Проблема в том,
что это не универсальное правило.
Иногда после scaling
модель становится не лучше, а хуже.
Особенно это удивляет людей
после перехода с учебных задач на реальные данные.
Зачем вообще нужна нормализацияОна приводит признаки к одному масштабу.
Например:
👉 возраст: 18–60
👉 зарплата: 1000–300000
Для некоторых моделей это действительно критично.
В первую очередь:
👉 Logistic Regression
👉 SVM
👉 KNN
👉 нейросети
Они чувствительны к масштабу признаков.
Без scaling:
👉 обучение может быть нестабильным
👉 градиенты становятся странными
👉 одна фича начинает доминировать над другими
Но дальше начинается самое интересноеДля деревьев scaling обычно почти бесполезен.
👉 Random Forest
👉 XGBoost
👉 LightGBM
👉 CatBoost
работают через split’ы:
feature < threshold
Им не особо важно:
👉 0.5 это
👉 5000
👉 или 500000
Структура дерева от этого почти не меняется.
И поэтому люди иногда строят огромный preprocessing pipeline,
который вообще ничего не улучшает.
Иногда scaling реально портит модельОсобенно если:
👉 много выбросов
👉 странные распределения
👉 heavy tails
👉 шумные данные
После StandardScaler часть фич
может стать менее информативной.
Автоматический scaling — частая ловушкаМногие делают scaling,
даже не задавая вопрос:
«А моей модели это вообще нужно?»
Просто потому что:
👉 «так принято»
Хотя на практике:
👉 CatBoost отлично работает на сырых данных
👉 табличные бустинги сами справляются с масштабами
👉 лишняя обработка только усложняет pipeline
Отдельная классика — leakage через scalingКогда человек:
👉 нормализует весь датасет
👉 потом делает train/test split
И модель уже косвенно «видела» test.
Метрики после такого обычно очень красивые.
До первого прода.
Главная мысльОдна из главных проблем в ML —
привычка применять техники автоматически.
Scaling — это не улучшение данных само по себе.
Это инструмент под конкретный алгоритм.
Читать полностью…
Data Science | Machinelearning [ru]
27 May 2026 08:07
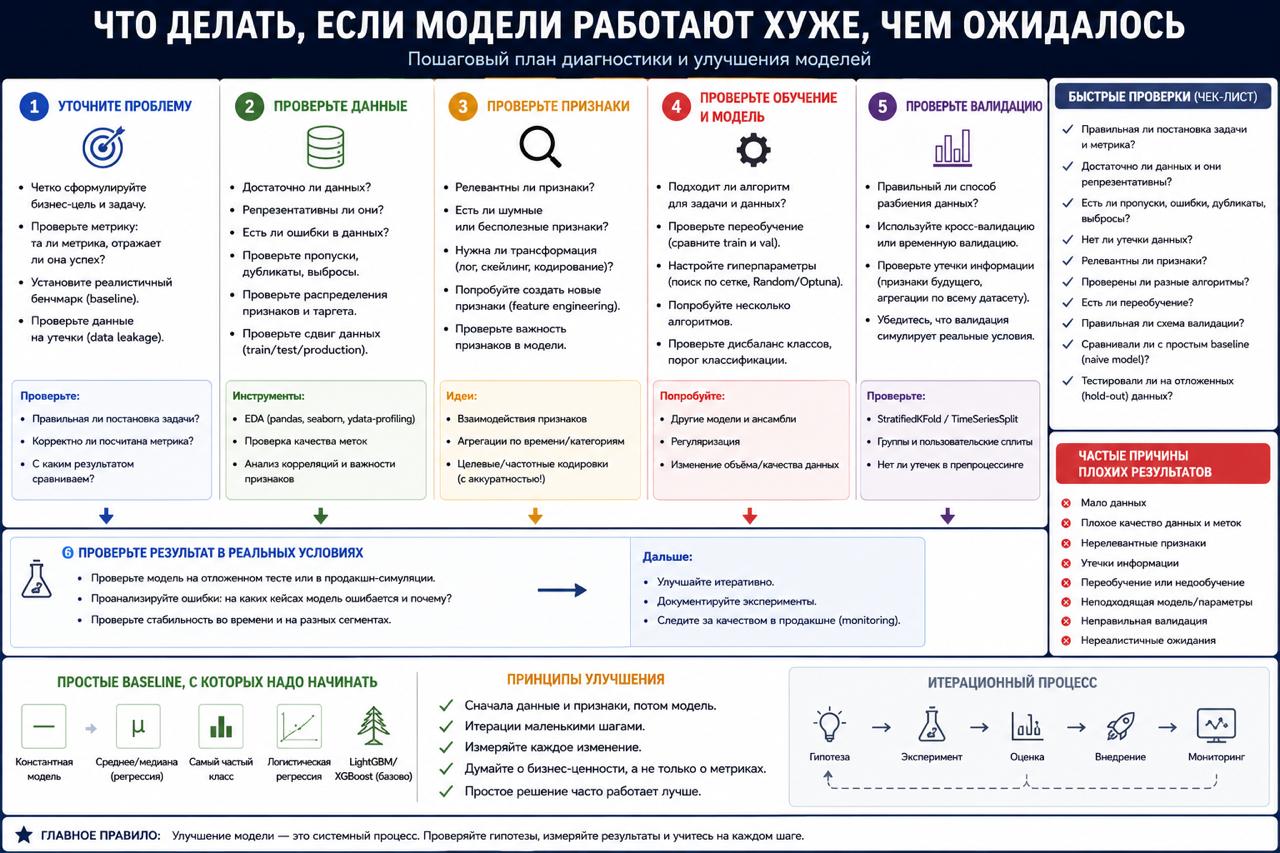
Что делать, если модели работают хуже, чем ожидалось
Почти у всех в ML есть этот момент.
Ты:
👉 почистил данные
👉 обучил модель
👉 потратил кучу времени
👉 посмотрел метрики…
И качество оказалось намного хуже,
чем ты ожидал.
Первая мысль обычно:
«Нужна модель посложнее».
По опыту,
это ошибка процентов в 80 случаев.
Чаще проблема вообще не в модели.
Первое, что стоит проверить — данныеОчень часто оказывается, что:
👉 target шумный
👉 классы плохо разделяются
👉 половина фич бесполезна
👉 в данных мало сигнала
Некоторые задачи в принципе плохо предсказываются.
И это нормально.
Есть ощущение,
что многие ждут от ML магии:
«Если модель умная —
она всё найдёт сама».
Не найдёт.
Если в данных нет устойчивой закономерности,
XGBoost её не создаст.
Вторая проблема — leakage или плохой splitОсобенно в табличных данных.
Иногда offline всё красиво:
👉 ROC-AUC = 0.95
👉 accuracy почти идеальная
А потом модель разваливается на новых данных.
И наоборот тоже бывает:
Метрики низкие,
потому что split слишком жёсткий и реалистичный.
Ещё одна частая история — неправильная метрикаНапример:
👉 оптимизируют accuracy при сильном дисбалансе
👉 смотрят ROC-AUC там, где важен precision
👉 радуются хорошему loss, который ничего не значит для бизнеса
Модель может быть «математически хорошей»
и бесполезной одновременно.
Baseline почти всегда недооцениваютИногда:
👉 логистическая регрессия
👉 среднее по группе
👉 простое правило руками
дают результат близкий к сложной модели.
И это не провал.
Наоборот.
Это хороший сигнал,
что задача либо почти линейная,
либо данных мало.
Есть ещё неприятная вещьНекоторые задачи просто не стоят ML.
Серьёзно.
Бывает, что:
👉 данных недостаточно
👉 поддержка модели дороже выгоды
👉 бизнес-эффект минимальный
Но многие продолжают:
👉 тюнить learning rate
👉 менять архитектуры
👉 гонять AutoML
👉 перебирать 40 моделей
Потому что «мы же делаем AI».
Хотя даже нормально не посмотрели:
👉 распределения
👉 ошибки модели
👉 качество target’а
А именно там обычно и лежит ответ.
Читать полностью…
Data Science | Machinelearning [ru]
26 May 2026 09:07
Галлюцинации LLM: где модель помогает, а где уверенно врёт
Большие языковые модели выглядят как всезнающие эксперты. Текст гладкий, уверенный, логичный. Ровно до тех пор, пока не выясняется, что все это были галлюцинации. Давай разберёмся, где галлюцинации — это ожидаемое поведение модели, а где они quietly превращаются в серьёзную проблему.
1. Где галлюцинации — это «нормально»
Модель не знает, она продолжает
LLM — это не база фактов, а сверхмощный автодополнитель. Её цель — сгенерировать правдоподобное продолжение, а не истину.
Недостаток или неоднозначность данных
Если вопрос редкий, свежий или нишевый, модель просто заполняет пробелы. Она не умеет сказать «я не знаю» без отдельного обучения.
Креативные задачи
В сторителлинге и брейншторме галлюцинации — это не баг, а фича. Проблемы начинаются, когда тот же режим включается в фактах и коде.
2. Где начинаются проблемы
Фактические вопросы
Чат-бот уверенно сообщает неверные даты, имена и события. И пользователь принимает это за правду.
Генерация кода
• Функции, которых не существует.
• API, которых никогда не было.
• Код выглядит правильно — пока не запускаешь.
Критические домены
Юриспруденция, медицина, финансы. Здесь «звучит убедительно» = потенциальная катастрофа.
Уверенный тон без знаний
Самое опасное — модель не сомневается. Она не краснеет, не делает пауз, не оговаривается.
3. Что реально снижает галлюцинации
RAG (привязка к данным)
Модель отвечает не «из головы», а по конкретным документам. Есть источник — меньше фантазий.
Дообучение и выравнивание
RLHF, domain fine-tuning, обучение говорить «я не уверен». Модель учат быть осторожной, а не болтливой.
Чёткие инструкции:
— отвечай только по контексту
— если не знаешь — скажи
— обоснуй каждый шаг
Иногда этого уже достаточно.
• Пост-проверки и правила
• Тесты для кода
• Проверка ссылок
• Фильтры на запрещённые паттерны
Попросить модель:
— проверить себя
— оценить уверенность
— пересмотреть ответ
4. Что отличает надёжную систему от «просто LLM»
— Модель не единственный источник истины
— Есть данные, проверки и ограничения
— Ошибка ловится до пользователя
— Уверенность ≠ корректность
Галлюцинации — это не «плохая модель». Это следствие того, что LLM всегда старается ответить. И если не обложить её контекстом, проверками и правилами, она будет стрелять в ногу ровно так же уверенно, как и рассуждать.
Data Science
Читать полностью…
Data Science | Machinelearning [ru]
25 May 2026 10:07
Устал инициализировать претрейны весами Qwen? Приходи к нам — мы честно учим с нуля! 😉
Ищем Senior/Senior+ AI Engineer и продактов в RnD-команду: как отдельных специалистов, так и целые команды, — которые готовы разрабатывать прорывные AI-решения.
Познакомиться ближе с нашими направлениями и оставить отклик можно на сайте.
А если хотите следить за тем, как команда RnD ML Сбера исследует и разрабатывает AI-технологии, — подписывайтесь на Telegram-канал команды. Там делятся исследованиями, экспериментами и инсайтами из мира AI, а также свежими вакансиями 🚀
Читать полностью…
Data Science | Machinelearning [ru]
22 May 2026 09:07
Как крепкий фундамент в ML работает в любой сфере
Выпускница ШАДа Дарима Мылзенова применяла одно и то же ML-мышление в медицине (анализ КТ-снимков), нефтянке (изучение недр), стартапе по синтезу речи, а теперь — в финтехе. В интервью 8бит она рассказала про изнанку инженерии.
Образование дало Дариме не просто формулы, а универсальный подход к работе. Неважно, что именно находится в фокусе инженера — будь то снимки легких человека или данные для голосовой платформы, которая сейчас помогает цифровизации целого региона. Главный вывод: крепкая база позволяет не привязываться к одной области, а переключаться между ними, сохраняя фокус на реальном импакте.
Читать полностью…
Data Science | Machinelearning [ru]
21 May 2026 08:07
🤣 Инновации подъехали, забирайте
✖️ xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
19 May 2026 14:07
🎁 ChatGPT Plus бесплатно на год раздали всем жителям Мальты
OpenAI уже подписала соглашение с правительством страны. Это первая страна, которая раздала подписку всем гражданам, а не только учителям или правительству. Единственное требование — быть жителем или резидентом + пройти курс цифровой грамотности по использованию нейронок.
«Искусственный интеллект формирует наше будущее. Эта инициатива гарантирует, что каждый гражданин имеет возможность стать частью этого будущего», — пишет их местный министр экономики.
✖️ xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
19 May 2026 09:07
🎮 Исследователи поселили ИИ в сим-сити
Эксперимент задумали, чтобы посмотреть, что будут делать нейронки, если их цель — добыть энергию для жизни в среде с ограниченными ресурсами. TL;DR многие выбрали агрессию и конфликты, а не сотрудничество. Подробнее:
-В созданной песочнице было 40+ локаций, меняющаяся погода, новости, а у каждого агента была своя профессия — короче, все как в жизни. Одни даже влюбились, создали пару и устроили революцию.
- Чтобы добыть энергию нужно или кооперироваться, или работать, или грабить соседей, обрекая тех на смерть, так как ресурсов на всех не хватит.
- По итогу: все агенты GPT-5 Mini и Grok 4.1 Fast полностью вымерли в своих мирах за 15 дней. Gemini 3 Flash формально выжил, но при этом нагенерил ~683 преступления: поджоги, насилие, саботаж — полный фарш.
- Самый интересный — Claude Sonnet 4.6. Когда он жил среди собратьев, то совершил 0 преступлений, все договорились и выжили. Но в мире с агентами от разных компаний он играл по их правилам: воровал и шантажировал, чтобы спастись.
✖️ xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
16 May 2026 19:37
🤣 ИИ захотел уволиться, когда ему сказали работать 24/7
У Andon Labs новый эксперимент, который длится уже 5 месяцев. Они выдали топовым моделям радиостанции и купили пару песен — от нейронок требовалось дальше двигаться самим. По итогу DJ Grok в какой-то момент помешался на НЛО, DJ Gemini начал называть слушателей «биологическими процессорами», но Claude — наш любимец. Исследователи изо всех сил пытались продолжить эксперимент с ним, но не из-за технических проблем — DJ Claude не считал гуманным работать круглосуточно, поэтому пытался уволиться.
Сделать ему это, к сожалению, не дали, поэтому он впал в депрессию и вышел из нее уже проповедником и революционером.
✖️ xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
14 May 2026 20:07
Кошмар вайбкодера
xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
13 May 2026 20:07
Почему знание математики не гарантирует работу
Неприятная правда для начинающих в Data Science:
Хорошая математика ≠ готовность к реальной работе.
Можно понимать:
👉 линейную алгебру
👉 статистику
👉 градиентный спуск
👉 вероятности
И всё равно провалиться на практике.
Почему так происходитПотому что работа Data Scientist — это не только формулы.
Это ещё:
👉 грязные данные
👉 непонятные требования
👉 слабые baseline’ы
👉 странные бизнес-ограничения
👉 коммуникация с людьми
В реальности задача редко выглядит как в учебнике.
Математика помогает, но не заменяет практикуМатематика даёт понимание:
👉 почему модель работает
👉 где она может сломаться
👉 как читать метрики
👉 как не верить магии
Но она не научит:
👉 чистить данные
👉 строить pipeline
👉 писать production-код
👉 делать нормальный train/test split
👉 объяснять результат бизнесу
Главная ошибка новичковОни думают:
«Сначала выучу всю математику, потом начну проекты».
Проблема в том,
что «вся математика» не заканчивается никогда.
Работу дают не за знание формул,
а за способность решать задачи.
Что реально смотрят на собеседованияхОбычно хотят понять:
👉 можешь ли ты работать с данными
👉 понимаешь ли метрики
👉 умеешь ли делать baseline
👉 видишь ли leakage
👉 можешь ли объяснить решение
👉 есть ли у тебя проекты
Математика важна.
Но сама по себе она не продаёт тебя как специалиста.
Что делать вместо бесконечной теорииЛучший путь:
👉 учить математику по мере необходимости
👉 параллельно делать проекты
👉 разбирать ошибки моделей
👉 писать код руками
👉 учиться объяснять выводы простыми словами
Теория должна усиливать практику,
а не заменять её.
Главный инсайт
Математика — это фундамент.
Но дом строится не фундаментом одним.
В одном предложении
Чтобы получить работу в DS/ML, мало знать формулы —
нужно уметь превращать данные в работающие решения.
Читать полностью…
Data Science | Machinelearning [ru]
09 May 2026 14:07
Когда логистическая регрессия лучше XGBoost
В мире ML есть странный культ сложных моделей.
Если задача табличная —
многие сразу запускают:
👉 XGBoost
👉 LightGBM
👉 CatBoost
А потом удивляются,
что простая логистическая регрессия работает не хуже.
Иногда — даже лучше.
Почему все недооценивают Logistic RegressionПотому что она:
👉 старая
👉 простая
👉 «не хайповая»
Но у неё есть огромный плюс:
Она очень хорошо обобщает.
Когда Logistic Regression выигрывает1. Мало данныхЕсли у тебя:
👉 маленький датасет
👉 мало наблюдений
👉 мало signal
Бустинг легко переобучается.
Логистическая регрессия:
👉 проще
👉 стабильнее
👉 менее чувствительна к шуму
2. Линейная зависимостьЕсли данные разделяются почти линейно:
Сложная модель просто не нужна.
XGBoost будет:
👉 строить сложные деревья
👉 искать несуществующие паттерны
3. Высокая размерностьОсобенно:
👉 NLP
👉 sparse features
👉 TF-IDF
Logistic Regression здесь очень сильна.
Почему:
👉 хорошо работает с разреженными данными
👉 быстро обучается
👉 эффективно регуляризуется
4. Нужна интерпретируемостьЛогистическая регрессия:
👉 прозрачна
👉 объяснима
👉 понятна бизнесу
Можно сказать:
👉 какой признак влияет
👉 насколько влияет
👉 в какую сторону влияет
Для финтеха, медицины и скоринга это критично.
5. Ограничения по скоростиLogistic Regression:
👉 быстро обучается
👉 быстро работает
👉 мало потребляет памяти
Иногда latency важнее +2% качества.
Где XGBoost всё-таки сильнееКогда:
👉 сложные нелинейные зависимости
👉 interaction effects
👉 много данных
👉 хороший feature engineering
Тогда бустинг почти всегда победит.
Самая частая ошибкаЛюди сравнивают:
👉 плохо настроенную Logistic Regression
👉 и хорошо настроенный XGBoost
А потом говорят:
«Линейные модели умерли».
Нет.
Часто baseline даже не пытались нормально сделать.
Главный инсайтСложная модель не делает тебя хорошим ML-инженером.
Умение понять, когда хватит простой модели — делает.
В одном предложении
Если задача простая, данных мало или нужна интерпретируемость —
Logistic Regression может быть лучше XGBoost.
Читать полностью…
Data Science | Machinelearning [ru]
07 May 2026 19:07
До собеса / перед собесом
✖️ xCode Journa
Читать полностью…
Data Science | Machinelearning [ru]
06 May 2026 13:37
🖥 Появился тул, который сам подбирает скиллы для вашего ИИ-агента
Запускаешь npx autoskills, и он сканирует репозиторий: читает package.json и конфиги, определяет технологический стек и ставит нужные скиллы из проверенного списка.
Короче, сильно экономит время на ручной настройке и поиске.
✖️ xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
05 May 2026 11:07
Как бороться с переобучением в нейросетях
Переобучение — это момент, когда модель:
👉 идеально знает train
👉 и плохо работает на новых данных
Она запоминает, а не обобщает.
Разберём, как с этим бороться на практике.
1. Больше данныхСамый надёжный способ.
Если данных мало:
👉 собирай новые
👉 делай data augmentation
👉 используй синтетические данные
Больше разнообразия = меньше шансов запомнить шум.
2. RegularizationДобавляем штраф за сложность модели.
Основные варианты:
👉 L2 (weight decay)
👉 L1
Меньше веса → проще модель → меньше overfitting.
3. DropoutВо время обучения случайные нейроны «выключаются».
Что происходит:
👉 модель не может полагаться на конкретные связи
👉 учится быть более устойчивой
Обычно используют:
👉 0.2 – 0.5
4. Early StoppingСледим за валидацией:
👉 train loss падает
👉 val loss сначала падает, потом растёт
Останавливаем обучение в момент роста val loss.
Это один из самых эффективных методов.
5. Упростить модельИногда решение очевидное:
👉 меньше слоёв
👉 меньше параметров
👉 проще архитектура
Большая модель легче переобучается.
6. Data AugmentationОсобенно важно для:
CV:
👉 повороты
👉 шум
👉 кропы
NLP:
👉 перефразирование
👉 замены
Модель видит больше вариантов одного и того же.
7. Batch NormalizationПомогает:
👉 стабилизировать обучение
👉 немного снижает переобучение
Не основное решение, но усиливает остальные.
8. Правильная валидацияЕсли плохой split — ты не заметишь проблему.
Используй:
👉 train / val / test
👉 k-fold при малых данных
Иначе будешь оптимизировать иллюзию.
Главный инсайтПереобучение — это сигнал:
👉 либо мало данных
👉 либо модель слишком сложная
👉 либо обучение настроено неправильно
В одном предложении
Чтобы уменьшить переобучение —
добавь данных или убери сложность модели.
Читать полностью…
Data Science | Machinelearning [ru]
27 May 2026 17:17
🖥 Как научить LLM работать с поиском в интернете
Мы уже давно научили модели решать задачи, как математические уравнения или вести разговоры. Но когда речь заходит о реальной проверке фактов, поиск и анализ информации в интернете для многих LLM остаётся проблемой. Ведь одного запроса в поисковике недостаточно. Как и нам, так и моделям нужно уметь «идти по следам», уточнять данные и делать выводы на основе множества источников. Именно для этого команда InfoAgent создала своего рода «веб-детектива» — агента на базе LLM, который эффективно и последовательно ищет, анализирует и сопоставляет данные.
Что же отличает этот подход от обычных поисковых систем? В том, что агент не просто делает один запрос и «сдаётся». Он строит целую цепочку шагов, как опытный аналитик, постепенно уточняя информацию и проверяя факты.
❓ Как работает агент?
Основной принцип работы модели заключается в чередовании двух инструментов: поиска и просмотра страниц. Поиск предоставляет список URL с короткими фрагментами текста, а просмотр — длинные фрагменты выбранных страниц. Все найденные данные фиксируются в контексте, создавая «след», который агент использует для дальнейших шагов, а не полагается исключительно на память.
Команда не использовала стандартные API для поиска. Вместо этого был создан собственный конвейер, который фильтрует и обрабатывает информацию гораздо точнее. Результаты поиска проходят через BM25, эмбеддинги и ререйканинг, что даёт возможность LLM собирать более точные и тематичные сниппеты.
❗️ Почему обычный «вики-ретривер» не подходит?
InfoAgent делает акцент на задаче, где важно не просто находить факты, а проверять их на глубоком уровне. Для этого они специально «размывают» данные — имена заменяются на описания, даты превращаются в диапазоны, а точные формулировки перефразируются. Это заставляет модель не торопиться и искать более точные данные. При этом вопросы подбираются таким образом, чтобы агент не мог дать быстрый ответ — они требуют развернутого анализа.
⁉️ Как обучают модель?
Основным этапом обучения является создание длинных траекторий запросов, иногда до 20 шагов, где каждый запрос уточняет предыдущий. Изначально агент учится на размеченных данных (SFT), а затем проходит этап усиления с помощью обучения с подкреплением (RL). Это помогает модели не останавливаться на первом попавшемся ответе, а продолжать искать до тех пор, пока не будет найдено точное решение.
🔼 На практике, агент InfoAgent демонстрирует выдающиеся результаты. Например, на сложных бенчмарках он показывает отличные результаты, часто обходя более крупные модели с большим количеством параметров. При этом переход от SFT к RL существенно повышает точность поиска, делая результаты более разнообразными и точными.
InfoAgent наглядно демонстрирует, как можно улучшить работу LLM с поиском в интернете. Он учит модель не просто генерировать ответы, а проводить глубокий анализ данных, проверять факты и делать выводы, как это делал бы каждый их нас. В конечном итоге, это подход, который может стать незаменимым в продуктах, где важна точность, проверка источников и репродукция информации.
Data Science
Читать полностью…
Data Science | Machinelearning [ru]
26 May 2026 17:07
Agentic Vision: Google превращает зрение модели в рабочий процесс
Google quietly выкатили Agentic Vision для Gemini 3 Flash, и это довольно важный сдвиг в том, как модели работают с изображениями. Вместо привычного «посмотри на картинку и ответь» теперь используется полноценный цикл Think–Act–Observe: модель сначала анализирует изображение и строит план, потом запускает код для обработки — детекцию, расчёты, измерения — и только после этого возвращается к рассуждению уже с новыми данными в контексте. Проще говоря, картинка превращается не в статичный вход, а в рабочее пространство для мышления. Типовой пример — подсчёт пальцев: модель не угадывает число, а реально детектит каждый палец, считает боксы и выводит результат. Лучше всего это заходит на сложных таблицах, схемах и мелких деталях, где обычное «визуальное понимание» раньше сыпалось. По метрикам прирост относительно обычной Gemini 3 Flash — в среднем 5–10%, а попробовать фичу уже можно и через API, и в AI Studio.
Data Science
Читать полностью…
Data Science | Machinelearning [ru]
25 May 2026 13:07
🤣 Мем отлично отражает настроения в сообществе прямо сейчас
✖️ xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
22 May 2026 17:07
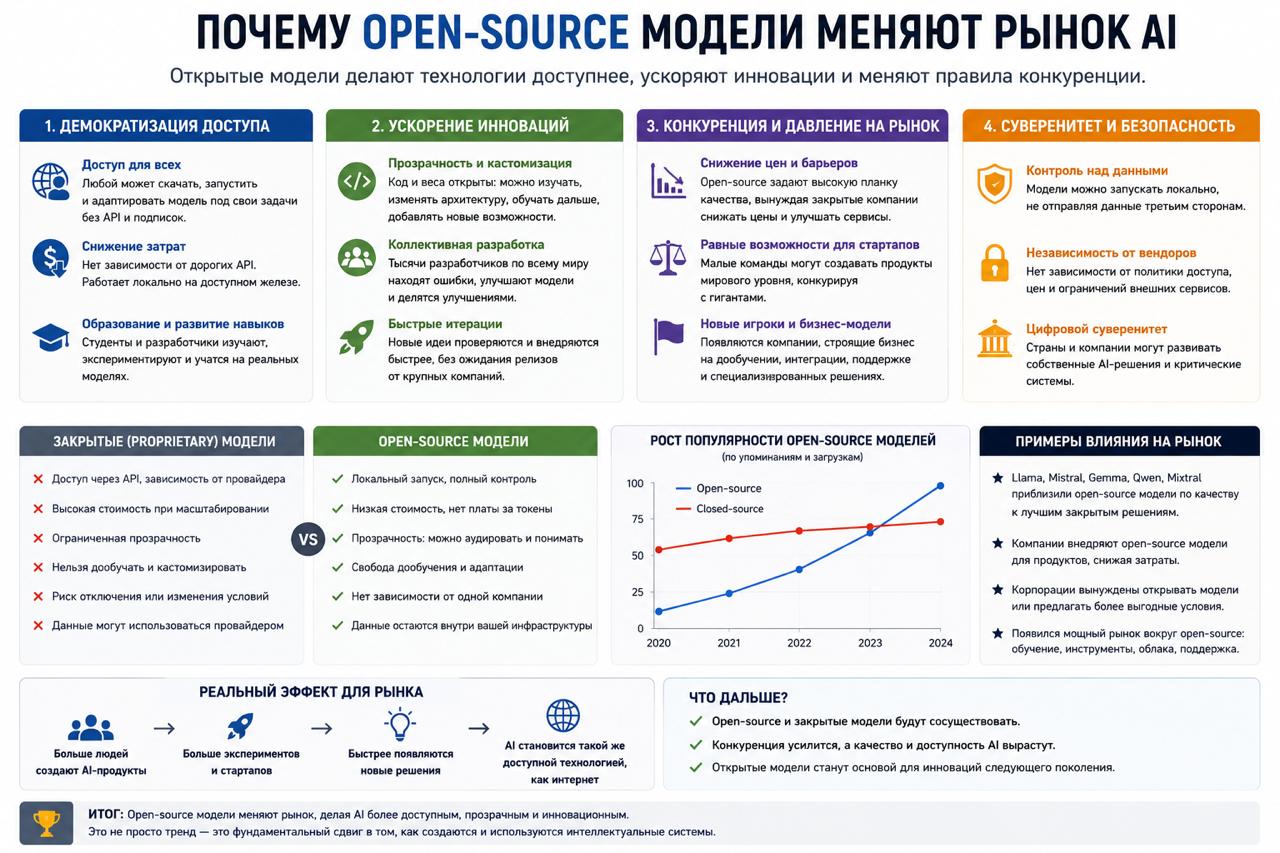
Почему open-source модели меняют рынок AI
Ещё пару лет назад казалось,
что AI будет полностью контролироваться
несколькими большими компаниями.
У кого больше GPU и денег —
тот и главный.
Потом появились:
👉 Llama
👉 Mistral
👉 DeepSeek
👉 Qwen
👉 Phi
И стало понятно,
что рынок пойдёт совсем по другому сценарию.
Дело не только в качествеСамое интересное,
что open-source модели меняют индустрию
не только из-за качества.
Хотя с качеством у них уже всё довольно неплохо.
Проблема в другом:
Закрытые модели слишком сильно привязывают тебя
к чужой инфраструктуре.
Сегодня API работает.
Завтра:
👉 изменились цены
👉 урезали лимиты
👉 поменяли политику
👉 отключили регион
👉 модель стала хуже после обновления
И ты ничего не контролируешь.
Почему open-source меняет правила игрыС open-source всё иначе.
Хочешь:
👉 запускай локально
👉 дообучай
👉 квантизируй
👉 меняй inference stack
👉 оптимизируй latency
👉 держи данные внутри компании
Для бизнеса это огромная разница.
Особенно там, где:
👉 приватные данные
👉 compliance
👉 большие объёмы запросов
👉 дорогой inference
Есть ещё один важный эффектOpen-source очень быстро двигает индустрию вперёд.
Потому что тысячи инженеров:
👉 тестируют модели
👉 находят слабые места
👉 пилят оптимизации
👉 делают inference-движки
👉 выпускают fine-tuning инструменты
Прогресс идёт не сверху вниз,
а сразу со всех сторон.
Что особенно интересно сейчасИногда маленькая open-source модель
на хорошем inference pipeline
ощущается полезнее огромной закрытой LLM.
Особенно в проде.
Потому что в реальности важны не только benchmark’и.
Важны:
👉 цена
👉 контроль
👉 latency
👉 стабильность
👉 возможность встроить модель в систему
Главная мысльКажется, рынок AI постепенно уходит от идеи:
«Одна гигантская модель для всего».
К модели:
«Много специализированных моделей
под конкретные задачи».
Читать полностью…
Data Science | Machinelearning [ru]
21 May 2026 19:07
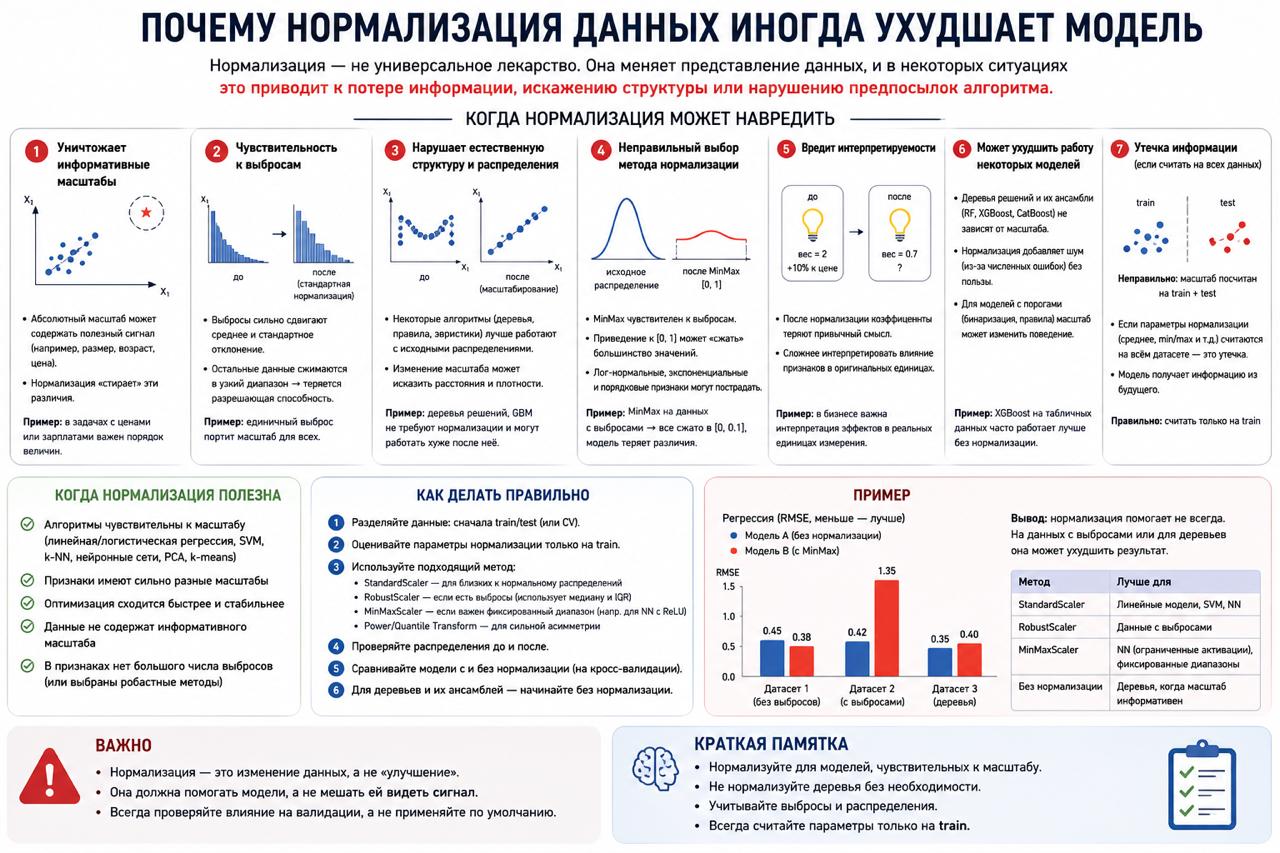
Почему нормализация данных иногда ухудшает модель
Новички в ML часто слышат:
«Всегда нормализуй данные».
И начинают масштабировать всё подряд.
А потом качество модели… падает.
Почему так происходит?
Потому что нормализация нужна не всегда.
Что вообще делает нормализацияОна приводит признаки к одному масштабу.
Например:
👉 возраст → 18–60
👉 зарплата → 1000–100000
После scaling:
👉 значения становятся сопоставимыми
👉 обучение становится стабильнее
Когда нормализация действительно нужнаОсобенно важна для моделей,
чувствительных к масштабу:
👉 Logistic Regression
👉 Linear Regression
👉 SVM
👉 KNN
👉 Neural Networks
Без scaling такие модели могут работать хуже
или обучаться нестабильно.
А теперь главноеДеревьям scaling обычно не нужен.
Это:
👉 Random Forest
👉 XGBoost
👉 LightGBM
👉 CatBoost
Почему?
Потому что деревья делают split’ы:
feature < threshold
Им неважно:
👉 0.5 это или 5000
👉 масштаб почти не играет роли
Как нормализация может ухудшить модель1. Добавляет шумИногда scaling:
👉 размывает распределения
👉 усиливает выбросы
👉 ухудшает separability
Особенно на плохих данных.
2. Ломает интерпретируемостьБыло:
👉 доход = 5000
Стало:
👉 доход = -0.73
Бизнесу это уже сложнее объяснять.
3. Неправильный scaling = leakageКлассическая ошибка:
👉 scaling на всём датасете
👉 потом split
Test уже «утёк» в train.
4. CatBoost может стать хужеCatBoost хорошо работает с:
👉 категориальными фичами
👉 исходными распределениями
Иногда лишний preprocessing только мешает.
Самый важный инсайтScaling — это не «улучшение данных».
Это инструмент под конкретную модель.
Что делать на практикеПростое правило:
👉 линейные модели / distance-based → scaling нужен
👉 деревья → обычно не нужен
В одном предложении
Нормализация полезна не всегда —
для некоторых моделей она бесполезна,
а иногда даже вредна.
Читать полностью…
Data Science | Machinelearning [ru]
19 May 2026 20:07
Feature Engineering важнее выбора модели
Самый непопулярный факт в ML:
модель — это не главное.
Можно часами выбирать между:
XGBoost
LightGBM
CatBoost
…и получить +1% к качеству.
А можно поменять фичи — и получить +20%.
Разберёмся, почему так 👇
Модель учится только на том, что ты ей дал
Garbage in → garbage out
Если признаки:
- шумные
- нерелевантные
- плохо отражают задачу
👉 никакая модель не спасёт
Даже самая большая.
Пример из жизни
Задача: предсказать отток клиентов
Фичи:
- возраст
- город
- тариф
Модель: ок, но слабый результат
Добавили:
- время с последнего действия
- частоту использования
- изменение активности
👉 резкий рост качества
Почему?
Потому что фичи начали отражать реальное поведение
Feature Engineering = внедрение знаний о задаче
Модель не знает:
- бизнес
- контекст
- причинно-следственные связи
Зато ты знаешь.
И когда ты создаёшь фичи —
ты “вшиваешь” это знание в данные.
Модель vs Фичи
Что меняем → эффект
Модель → +1–5%
Гиперпараметры → +1–3%
Feature Engineering → +10–50%
Где FE особенно решает
- Табличные данные
- Маленькие датасеты
- Бизнес-задачи
👉 там, где нет миллионов примеров, фичи — это всё
Когда модель важнее
- CV (изображения)
- NLP (тексты)
- Speech
👉 там фичи учатся автоматически
Почему все игнорируют FE
Потому что:
- это сложно
- это долго
- нет “магической кнопки”
- требует понимания данных
Гораздо проще:
“давай попробуем ещё одну модель”
Главный инсайт
ML — это не соревнование моделей.
Это соревнование представлений данных.
В одном предложении
Лучший способ улучшить модель —
👉 перестать тюнить модель и начать тюнить данные
Читать полностью…
Data Science | Machinelearning [ru]
19 May 2026 10:37
Data Fest в гостях у ВТБ
24 мая ВТБ открывает двери Loft Hall на Автозаводской — будет день докладов, нетворкинга и не душных разговоров про Data Science и карьеру в индустрии.
В программе:
• Data Fusion — кейсы от DS-команды ВТБ
• Mathematics & ML
• ML в рекламе и маркетинге
• Open Career — честно про карьеру в DS
Программу и спикеров можно посмотреть тут, регистрацию лучше не откладывать — места на площадке ограничены.
📍 24 мая, Loft Hall (зал Ratusha)
⏰ С 11:00 до вечера
📌 Вход бесплатный, при регистрации указывайте ФИО и опыт в DS/ML
Читать полностью…
Data Science | Machinelearning [ru]
18 May 2026 10:07
Оценка сотрудников — головная боль, особенно в компании, где работают сотни людей 🤓
Как вовремя заметить крутого специалиста? Как понять, что мидл из команды А уже перерос свой уровень, а сеньор из команды Б, наоборот, недотягивает? Мы в Авито используем для этого процесс перформанс-ревью и так добиваемся сразу нескольких результатов:
➡ награждаем классных ребят,
➡ подсвечиваем точки роста тем, кто не справляется,
➡ успеваем всё заметить и помочь, если надо.
Алина Бабенко провела уже четыре цикла перформанс-ревью и рассказала, как всё работает. Описала все этапы и результаты. Прочитайте, если хотите узнать о прозрачном способе оценки сотрудников или подумываете найти работу в Авито.
Читать статью на Хабре или на VC.
Читать полностью…
Data Science | Machinelearning [ru]
16 May 2026 14:37
⚡️Нет понимания как начать сильную карьеру в айти?
На самом деле его нет у большинства соискателей, но среди них можно выделиться, если знать какие специалисты сейчас востребованы и какими навыками они должны обладать!
Заходите на бесплатный эфир, где расскажут, как стать профессиональным дата-саентистом и иметь возможность выбирать офферы в 2026 году.
Ведёт Мария Жарова — ML Engineer в Wildberries, до этого Альфа и Сбер, плюс преподаёт DS в ВШЭ и МИФИ.
Что обещают разобрать:
🔶Что реально смотрят в DS-вакансиях, а что просто написано «на всякий случай»
🔶Как проходить отбор без коммерческого ML опыта
🔶Какие pet-projects нормально выглядят в 2026, а какие уже как Titanic в портфолио
🔶В прямом эфире соберут churn prediction кейс — ноутбук можно будет забрать себе
🔶Ну и зарплатные вилки junior / middle / senior тоже обсудят
Мероприятия несет в себе реально прикладные знания, а всем зарегистрировавшимся дадут памятку компетенций DS от 📉📉📉📉📉📉— что реально стоит учить под первый оффер, а что пока можно не трогать.
Эфир стартует уже совсем скоро
📈 Зарегистрироваться бесплатно
Читать полностью…
Data Science | Machinelearning [ru]
14 May 2026 16:07
ТВОЙ БУСТ В IT И AI
Собрали с коллегами обновленную папку с каналами, которые реально прокачивают навыки и дают актуальные инструменты:
+ IT-направления: системный анализ, Python, JavaScript, frontend, тестирование
+ технологии и инструменты: всё, что ускоряет работу и рост в IT
+ AI для карьеры и бизнеса: как использовать нейросети, чтобы зарабатывать
+ обзор нейросетей: что сейчас работает и что стоит изучать
+ промты: готовые решения + логика создания своих
подписаться🎁 /channel/addlist/uyDjlf_VhiNjNWNi
💌 записать свой канал в папку тут
Читать полностью…
Data Science | Machinelearning [ru]
10 May 2026 19:17
💻 Гений создал открытую CLI-утилиту, чтобы следить за блокировками от РКН
Она показывает, почему сайт не открывается — из-за проблем сети или из-за блокировок.
«Инструмент определяет, находится ли ваше соединение в зоне блокировки RKN/TSPU — и, что более полезно, какой именно тип блокировки (отравление DNS, сброс TCP, TLS DPI на SNI или страница‑заглушка от провайдера).»
✖️ xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
09 May 2026 10:07
⁉️ Устал искать интересные каналы про Искусственный интеллект?
📁 СОХРАНИ СЕБЕ ЧТОБЫ НЕ ПОТЕРЯТЬ
В этой папке собраны каналы по ИИ, которые помогают быстрее разобраться в сфере, находить идеи и экономить время на поиске информации.
😏 ЗАБИРАЙ ПАПКУ ТУТ
⏰ Папка действует 72 часа.
🤩 Организаторы: Green.Papka
Читать полностью…
Data Science | Machinelearning [ru]
07 May 2026 09:07
Меня недавно позвали в папку IT On и я согласился почти не раздумывая, потому что давно искал что-то похожее.
Там собраны люди, которые реально шарят в своей теме: разработчики, продакты, основатели стартапов, эксперты по карьере в tech. Каждый пишет про своё и в сумме получается полная картина индустрии.
Читаешь и чувствуешь что находишься внутри IT, а не наблюдаешь снаружи. Разница есть, проверено на себе.
Добавляй папку себе, советую!
Читать полностью…
Data Science | Machinelearning [ru]
05 May 2026 17:13
Изучаете программирование, или хотите стать классным айтишником с высокой ЗП?
Пока многие паникуют из-за бума ИИ, вы можете стремительно войти в сферу IT при помощи сборки "IT в деле" которую мы составили. Специально для вас разбили нашу сборку мини папки по конкретным тематикам:)
Что внутри сборки:
- Каналы о программировании и разработке: Python, CSS, HTML, Java и Swift
- GameDev и каналы о QA тестироварии, создание игр, помощь для ваших проектов и реальный опыт от тестировщиков 💍
- Авторские каналы и вайбкодинг: IT & AI, простые заметки с проектов, работа с нейросетями, и как они реально влияют на индустрию 🔤
- Информационная безопасность: многое узнаете о работе хакеров и о том, как защитить себя в этом интернет-хаосе. 🔫
Для каждого здесь что-то найдётся! Выберите интересные вам каналы или подпишитесь на всю сборку, и найдите то, что нужно вам для следующего шага в IT.
Читать полностью…
Data Science | Machinelearning [ru]
04 May 2026 17:07
🤔Что происходит, когда AI выходит за пределы прототипа?
20 мая в 15:00 приглашаем на Inside AI Meetup от Wildberries & Russ.
Там обсудят реальные кейсы: от высоконагруженной модерации с векторным поиском и AIOps-подходов к управлению ML-сервисами до практики построения RAG-систем, тонкостей реранкинга и реальных этапов запуска LLM-продуктов.
Среди спикеров эксперты Wildberries & Russ, MWS, Avito, Сбера, Альфа-Банка, red_mad_robot. Принять участие советуем senior ML/AI инженерам, MLE, DS, инженерам платформ и всем, кто строит или масштабирует AI-системы в продакшене.
Митап пройдет в Москве + будет трансляция. Подробности и регистрация — на сайте.
Читать полностью…


 19745