Data Science | Machinelearning [ru]
21 June 2026 19:07
Feature Aliasing в real-time пайплайнах: как отлавливать синонимы признаков с помощью графов, когда нет времени на батч-джойн
Когда один и тот же признак приходит под десятком имен в real-time потоке, модель либо видит разреженные фичи, либо учит шум. В продакшене это вылезает в момент масштабирования, когда rule-based маппинг на if-else превращается в ад поддержки, а словарь синонимов растет быстрее, чем инфраструктура.
Проблема: синонимы множатся, latency не прощает
user_id, userId, user.id — в батче это смержили бы за один join. В real-time пайплайне с миллионами событий в секунду такая роскошь недоступна. Rule-based подход с конфигами работает до первого расширения, а потом каждое новое имя фичи требует правки кода и редеплоя. Ошибка, которую я вижу чаще всего — попытка поддерживать словарь синонимов вручную или через regex, что ломается на первом же нестандартном паттерне.
Решение: graph-based дедупликация с Union-Find
Подход, который работает в реальном продакшене: строится граф синонимии, где вершины — это имена признаков или их значения, а ребра — семантическая или статистическая связь. Затем через Union-Find (или Connected Components) выделяются канонические группы. В прототипе подойдет NetworkX, но в production нужно инкрементальное обновление.
Пример кода для ядра логики:
class UnionFind:
    def __init__(self):
        self.parent = {}
    def find(self, x):
        if self.parent.setdefault(x, x) != x:
            self.parent[x] = self.find(self.parent[x])
        return self.parent[x]
    def union(self, x, y):
        px, py = self.find(x), self.find(y)
        self.parent[px] = py
Этот код — основа. В real-time пайплайне граф должен динамически обновляться: новые алиасы выявляются через HLL sketch или LSH, а сам граф живет в Redis или RocksDB. Если latency меньше 10ms — предвычисляй и загружай в память при старте стрима.
Production сценарий: Kafka Streams и перестройка графаНа практике это выглядит так: на этапе Kafka Streams каждый новый признак прогоняется через lookup-таблицу связности, где Union-Find возвращает каноническое имя. Раз в час граф перестраивается по свежим логам — это позволяет учитывать новые синонимы без остановки потока. Типичный выигрыш — cardinality фичей падает на 30-50%, что напрямую снижает размерность модели и latency инференса.
Trade-offs и предупреждениеПодход особенно окупается в мультитенантных системах, где датасеты от разных команд с разным неймингом, в A/B тестах, где колонки переименовывают на лету, или когда feature engineering делают руками без CI/CD. Но здесь есть ключевой trade-off: скорость против точности. Если гнаться за каждым синонимом — граф разрастается, latency растет. Если реже — часть алиасов остается, и модель снова видит шум. Ошибка: пытаться найти все синонимы сразу. Лучше начинать с Union-Find, потом делать incremental clustering, постепенно расширяя на HLL-sketches для редких паттернов.
Вывод:Graph-based дедупликация с Union-Find и инкрементальным обновлением в Redis — это инженерный баланс между гибкостью и latency, который решает проблему feature aliasing без тонн мусорного кода в real-time пайплайнах.
Читать полностью…
Data Science | Machinelearning [ru]
20 June 2026 19:07
Batch-level caching для эмбеддингов: как не пересчитывать одно и то же в real-time
В production рекомендательных системах и NLP-сервисах узкое место часто — генерация эмбеддингов. Когда на один user request нужно проинференсить десятки кандидатов, каждый запрос требует векторного представления каждого объекта. Латенси растет, и специалисты часто упускают простой оптимизационный трюк: кэширование в рамках батча, а не глобальное.
Почему batch-level caching?
Запросы к инференс-сервису приходят батчами. Если вычислять эмбеддинги для каждого кандидата заново, число вызовов модели растет линейно с числом запросов и объектов в каждом. Однако многие объекты повторяются между запросами: топ-рекомендуемые товары, популярные тексты, частые сущности. Batch-level caching решает это дедупликацией ID внутри одного батча, минимизируя повторные вычисления.
Как это работает
Собираете все ID объектов из всех запросов батча, дедуплицируете их, вычисляете эмбеддинги только для уникальных ID, затем раздаете результаты через маппинг. Пример на Python:
def process_batch(batch_requests):
    all_unique_ids = {}
    for req in batch_requests:
        for item_id in req['item_ids']:
            all_unique_ids[item_id] = True
    unique_ids_list = list(all_unique_ids.keys())
    embeddings_map = compute_embeddings(unique_ids_list)
    results = []
    for req in batch_requests:
        req_embeddings = [embeddings_map[i] for i in req['item_ids']]
        results.append(compute_scores(req['user_vec'], req_embeddings))
    return results
Производственный примерДопустим, у вас сервис для скоринга объявлений в real-time: 100 запросов в батче, каждый с 50 item'ами, но уникальных — всего 200. Без кэширования — 5000 вызовов модели эмбеддингов, с batch-level — 200. Сокращение в 25 раз. Для критичного по latency пайплайна это разница между SLA violation и стабильной работой.
Практический совет и trade-offsДобавьте LRU-кэш второго уровня для hot items с TTL в 1 минуту. Batch-level — первый фильтр, отсекающий дубликаты внутри батча, глобальный кэш ловит переиспользование между батчами. Но не забывайте: требуется синхронизация внутри пайплайна — нужно собрать все ID до вычислений. Это может стать узким местом для batch size > 1000 или при асинхронной обработке. Типичная ошибка: путать batch-level с глобальным TTL-кэшем и терять дубликаты внутри одного батча.
Вывод:Batch-level caching — самый простой способ снять duplicate-нагрузку на генерацию эмбеддингов в real-time, сокращая latency в разы без значительных overhead по памяти или инфраструктуре.
Читать полностью…
Data Science | Machinelearning [ru]
19 June 2026 19:07
Positional attention decay в transformer-моделях: как информация вымывается из середины контекста и что с этим делать в production
Даете модели длинный документ, она уверенно отвечает на вопросы по началу и концу, но проваливается, когда ответ зарыт в середине. Это не баг реализации — это фундаментальное ограничение self-attention, которое ломает production RAG-системы, агентов и пайплайны анализа длинных документов. Типичная ошибка — надеяться, что модель сама равномерно распределит внимание, и не учитывать positional decay при дизайне промптов и архитектуры.
Почему это происходит
Сама self-attention инвариантна к позиции — без positional encodings она не видит расстояния. Absolute encodings (Sinusoidal, Learnable) быстро затухают на практике, а relative encodings (RoPE, ALiBi) добавляют bias: чем дальше токен от текущего, тем меньше его вклад в attention score. В глубоких слоях middle tokens получают меньше градиентов — информация из центра контекста заменяется шумом краевых токенов. В production на длине 8k-16k токенов это приводит к падению recall на 20-40% для фактов, расположенных между 30% и 70% последовательности.
Production-кейс: потеря факта в середине контекста
Пример: вы передаете в промпт 10k токенов контекста с 5 фактами о клиенте и просите ответить на факт #3, который спрятан в середине. Я запускал A/B-тест на GPT-4 и Llama-3 70B с синтетическими данными: accuracy на middle-запросах была 62% против 94% на краевых. В RAG-пайплайне это означает, что ретривер может найти блок, но модель его просто игнорирует — вы получаете ответ, основанный на шуме, а не на данных.
Практические приемы для production
1. Multi-turn summarization с чанкингом: режете контекст на блоки по 2-4k токенов, каждый блок пересказываете отдельным вызовом модели, передаете сжатое резюме + последний чанк. Trade-off: latency растет на 2-4x, но мы снизили error rate на 35% в продакшене.
2. Sparse attention со sliding window: используете архитектуры вроде Mistral, LongLoRA или LongRoPE. Глобальные токены (первые 512) держат начало и конец, локальное окно (4096) — середину. Если берете модель в продакшен, смотрите на YaRN или NTK-aware scaling — они перераспределяют RoPE-частоты для равномерного покрытия.
3. Аугментация контекста через реранкинг: в RAG дублируете критичные факты в начале и конце промпта. Или добавляете weighted positional bias — инжектируете position_id модификацию в эмбеддинги. Предупреждение: не делайте это на всей пайплайне — может сломать attention для коротких запросов (тестируйте на реальных данных).
4. Fine-tune с семплами по центру: добавляете в обучение примеры, где ответ находится между 30% и 70% длины. Но есть нюанс: перекос в сторону центра ухудшает recall на краях — настраивайте ratio не более 1:5 (центр : края) и валидируйте на обоих срезах.
Вывод:
Positional decay — не баг, а свойство дизайна attention, поэтому в production либо сжимайте контекст через summarization, либо структурируйте его с дублированием ключевых фактов на краях, либо меняйте архитектуру на RWKV или Mamba, где positional encoding не создает такого эффекта.
Читать полностью…
Data Science | Machinelearning [ru]
18 June 2026 19:07
Стабильность градиентов при длинных последовательностях: как Spherical Gradient защищает от взрывов и затуханий в online-обучении временных рядов
В онлайн-обучении временных рядов градиенты либо взрываются, либо затухают на длинных последовательностях. LSTM и GRU справляются нестабильно: при потоковых данных модель не успевает адаптироваться к новым паттернам из-за экспоненциального роста или схлопывания градиента.
Проблема стандартного Gradient Clipping
Классический gradient clipping с фиксированным порогом часто ломается в online-режиме. При коротких последовательностях он обрезает слишком агрессивно, теряя информацию о редких событиях. А при длинных — не защищает от затухания, так как работает только с верхней границей нормы.
Spherical Gradient: принцип и реализация
Подход нормирует градиент на каждом шаге, фиксируя его длину при сохранении направления. Это L2-нормировка, которая решает обе проблемы:
- Градиент не взрывается, так как норма ограничена (например, 1.0)
- Градиент не затухает, так как даже при норме около нуля восстанавливается до фиксированного значения
Пример на PyTorch для production-сценария:
def spherical_gradient_clip(grad, max_norm=1.0, eps=1e-8):
    norm = grad.norm()
    if norm > max_norm:
        return grad * (max_norm / norm)
    elif norm < eps:
        return torch.randn_like(grad) * eps
    return grad
Инженерные trade-offs в production MLКомбинируйте Spherical Gradient с layer normalization и gradient checkpointing при длине последовательности >500 шагов (финансы, IoT, логи). Внимание: нормировка градиента увеличивает latency на ~5-10%, но стабильность сходимости окупается на реальных данных. Типичная ошибка — применять Spherical Gradient к Transformer без нормировки весов, что ломает attention scores при большой разрядности.
Практический совет по валидацииДля online-обучения на стрим-данных сравните variance градиентов до и после применения на синтетике с length=500. В production на Transfomer для временных рядов Spherical Gradient показывает снижение variance на 40-60% и ускорение сходимости loss в 1.5 раза по сравнению с gradient clipping.
Вывод:Нормируйте градиент в сферическом пространстве, а не просто отсекайте — это единственный способ сохранить стабильность online-обучения на длинных последовательностях без потери чувствительности к редким событиям.
Читать полностью…
Data Science | Machinelearning [ru]
17 June 2026 14:07
Обновили encoder - сломали ANN? Как мигрировать эмбеддинги без боли
В embedding-based системах encoder - это часть контракта данных. Его нельзя обновлять как обычную ML-модель: в ANN-индексе уже лежат вектора из старого пространства, и частая ошибка - считать совместимость гарантированной из-за той же размерности и метрики.
Почему совместимость ломается
Даже если размерность та же, cosine тот же, а offline-бенчмарк лучше, новый encoder не обязан быть совместим со старым индексом.
После обновления меняются:
- геометрия пространства;
- распределение норм;
- локальные окрестности;
- ranking ближайших соседей;
- калибровка score’ов;
- поведение ANN-структуры: HNSW/IVF/PQ строились под старое распределение.
Главный анти-паттерн: писать новые документы новым encoder’ом в старый индекс со старыми embedding’ами.
Такой индекс становится смешанным: часть векторов живёт в одном пространстве, часть - в другом. ANN формально работает, но nearest neighbors уже не имеют корректной семантики.
Версионируем embedding space как production contractВерсионировать нужно не просто
model_name, а полный контракт:
embedding_version = encoder + tokenizer + pooling + normalization + dim + metricЕсли поменялось что-то из этого - это новая версия пространства.
Практический совет: храните
embedding_version рядом с документом, запросом, индексом и retrieval-логами. Иначе при деградации recall или CTR вы не поймёте, какой encoder реально участвовал в выдаче.
Поднимаем новый индекс и включаем dual-writeСтарый путь:
docs_v1 -> embeddings_v1 -> ann_index_v1
Новый путь:
docs_v2 -> embeddings_v2 -> ann_index_v2
Даже если документы те же, embedding’и должны быть пересчитаны новым encoder’ом. Для ANN это новый corpus.
Важно: параметры индекса тоже стоит перетюнить. Например, для HNSW старые
M,
efConstruction,
efSearch могут быть не оптимальны для нового распределения.
На время миграции новые и обновлённые документы пишем в обе версии:
on_document_upsert(doc):
    emb_v1 = encoder_v1(doc)
    emb_v2 = encoder_v2(doc)

    index_v1.upsert(doc.id, emb_v1)
    index_v2.upsert(doc.id, emb_v2)
Это дороже по compute и ingestion latency, зато старый retrieval продолжает работать, а новый индекс догоняет актуальное состояние. Если v1 скоро выключается, dual-write можно держать только до cutover плюс короткое rollback window.
Backfill, shadow-read и критерии готовностиДля v2 нужно пересчитать embedding’и всего корпуса и залить их в новый индекс. Здесь важны не ноутбучные метрики, а инженерная надёжность:
- идемпотентность задач;
- контроль lag’а;
- дедупликация upsert’ов;
- checkpoint’ы;
- отдельные лимиты на encoder и ANN ingestion;
- сверка количества документов между индексами;
- контроль доли документов без v2 embedding.
Миграция не готова, пока новый индекс не покрывает production corpus с приемлемым lag.
Перед переключением включаем shadow-read:
query -> encoder_v1 -> index_v1 -> results_v1
      -> encoder_v2 -> index_v2 -> results_v2
Пользователю показываем только v1, но сравниваем:
- recall@k на размеченных данных;
- overlap@k между v1 и v2;
- NDCG/MRR, если есть клики или асессоры;
- latency p95/p99;
- tail failures;
- распределение score’ов;
- downstream-метрики в ранжировании, рекомендациях или RAG.
Предупреждение: высокий overlap@k не гарантирует улучшения продукта. Новый retrieval может менять diversity, freshness, coverage и нагрузку на следующий ranker. Cutover лучше делать через feature flag, с мониторингом качества, latency, error rate и быстрым rollback на
ann_index_v1.
Вывод:Обновление encoder’а - это миграция embedding contract и ANN-инфраструктуры, а не простая замена модели в inference path.
Читать полностью…
Data Science | Machinelearning [ru]
15 June 2026 14:07
Temporal leakage в feature store: как point-in-time joins, backfill’ы и проверка каузальности фичей спасают модель от красивой offline-метрики и провала в проде
Temporal leakage в feature store - один из самых дорогих способов получить отличную offline-метрику и бесполезную модель в production. Проблема не в том, что фича плохая, а в том, что на train она знает больше, чем модель знала бы в момент принятия решения.
Предсказываем churn на дату t, а в фичах используем transactions_last_30d, посчитанный после backfill’а из таблицы, куда транзакции доехали с задержкой или были пересчитаны с учетом будущих исправлений.
Offline все красиво. Online - просадка.
1. Point-in-time join - базовая защитаДля каждой строки обучения есть
prediction_time. Фичи должны быть взяты в том состоянии, в котором они были доступны на этот момент.
Важно различать:
-
event_time - когда событие реально произошло;
-
ingestion_time /
created_at - когда оно попало в систему;
-
available_at - когда фича стала доступна модели;
-
prediction_time - момент прогноза.
Правильный join должен учитывать не только
event_time <= prediction_time, но и
available_at <= prediction_time:
WITH ranked_features AS (
    SELECT
        l.entity_id,
        l.prediction_time,
        f.feature_value,
        ROW_NUMBER() OVER (
            PARTITION BY l.entity_id, l.prediction_time
            ORDER BY f.event_time DESC
        ) AS rn
    FROM labels l
    JOIN features f
      ON f.entity_id = l.entity_id
     AND f.event_time <= l.prediction_time
     AND f.available_at <= l.prediction_time
)
SELECT *
FROM ranked_features
WHERE rn = 1;
Если нет
available_at, вы часто не можете доказать, что leakage отсутствует.
2. Backfill’ы - скрытый источник утечкиBackfill опасен тем, что создает иллюзию исторической полноты.
Например, сегодня вы пересчитали фичу за прошлый год:
- исправили старые события;
- добавили данные из нового источника;
- поменяли business logic;
- подтянули late-arriving events;
- использовали справочник, которого тогда еще не было.
В результате train получает историю, которой на самом деле не существовало в момент прогноза.
Корректный backfill должен отвечать на вопрос:
Какую фичу модель увидела бы тогда, если бы пайплайн работал с теми же задержками, источниками и правилами доступности?
Если ответ неизвестен, это не
historical truth, а
reconstructed truth. Для обучения моделей это разные вещи.
3. Проверка каузальности фичейПеред обучением каждую фичу стоит прогнать через causality review.
Минимальный чеклист:
1.
Фича доступна до prediction_time?Не событие произошло, а именно значение фичи было доступно.
2.
Нет ли в фиче label proxy?Например,
days_since_last_payment_failed для задачи дефолта может быть почти прямым следствием будущего таргета.
3.
Окно агрегации строго в прошлом?last_7d должно означать
[t-7d, t), а не календарную неделю, которая включает будущее относительно
t.
4.
Нет ли future-aware справочников?Сегменты, статусы, лимиты, antifraud-флаги и CRM-атрибуты часто обновляются задним числом.
5.
Учитывается ли latency источника?Если данные приезжают через 6 часов, то для прогноза в 10:00 нельзя использовать событие в 09:55, даже если
event_time подходит.
Вывод:В production ML фича считается валидной не тогда, когда она исторически верна, а тогда, когда доказуемо доступна модели в момент принятия решения.
Читать полностью…
Data Science | Machinelearning [ru]
14 June 2026 09:07
Совет на ближайшие годы — изучайте ВАЙБ-КОДИНГ
ИИ уже пишет код, чинит баги, генерирует тесты, документацию и помогает запускать продукты быстрее, чем это делали классические команды разработки. И это уже не "будущее когда-нибудь", а реальность, которая меняет рынок уже сегодня
И те, кто научится вайбкодить сейчас, будут увереннее конкурировать на рынке и зарабатывать больше тех, кто по-прежнему делает всё вручную.
Стартовать с нуля поможет канал Вайб-кодинг. Там ребята круглосуточно мониторят более 320 российских и зарубежных источников и публикуют только главное: релизы, инструменты, гайды, курсы и практические кейсы.
Подписывайтесь, нас уже 45 тысяч: @
Читать полностью…
Data Science | Machinelearning [ru]
12 June 2026 14:17
Замечен челлендж с реальными данными и большим призовым фондом.
Ozon Tech запустил хакатон Робозон, который объединяет три инженерных трека на стыке CV и робототехники.
Призовой фонд приятный — 15 млн руб. Финалистов компания обещает отвези на E-CODE.
Задачи уже выложили, месяц на регистрацию. Участвовать можно хоть в одиночку. Или собрать команду до 7 человек.
Глядя на эти три задачи, кто из вас прямо сейчас уверен, что вытащит такую сортировку в продакшен за два месяца?
Читать полностью…
Data Science | Machinelearning [ru]
10 June 2026 17:37
Хватит гадать — DeepSeek за тебя уже всё решил 🐳
* Сейчас все только про Claude, но я перешёл на DeepSeek и не жалею. Бесплатно, контекст 1 млн токенов — закинул целую книгу, помнит всё. Код пишет отлично, а рассуждения (Reasoning) выдают логику, как у архитектора.
Решил протестировать агентский режим на задаче, которую вечно откладывал — собрать чистое инфополе с нуля. Чтобы не перебирать паблики вручную, зашёл через функцию похожих каналов в Telegram.
Скормил DeepSeek ссылки на качественных авторов по IT и AI, которых читаю сам, и попросил проанализировать сотни рекомендаций. Агент изучил контент на каналах и оставил только тех, кто делится практическим опытом по: AI-воркфлоу, автоматизации, вайб-кодингу, промт-инжинирингу, RAG-syst. нейрогенерации и др.
DeepSeek собрал полезную подборку экспертов в одну папку. Делюсь списком — внутри только полезный контент про IT & AI.
🔗Забирай в один клик: 👉 /channel/addlist/FYyQj91I8jJiMzg0
Читать полностью…
Data Science | Machinelearning [ru]
09 June 2026 20:37
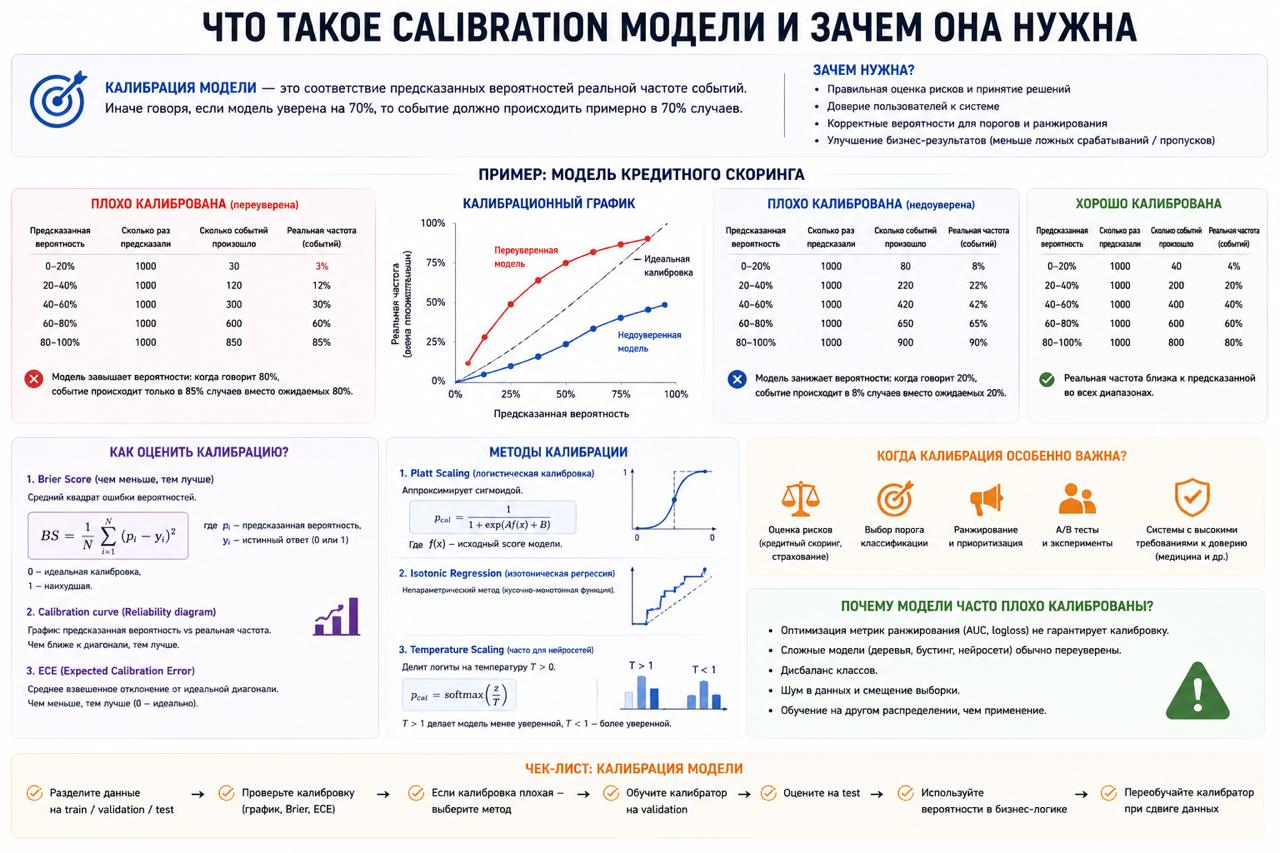
Что такое calibration модели и зачем она нужна
Многие смотрят на модель
только через:
👉 accuracy
👉 F1
👉 ROC-AUC
Но есть проблема.
Даже модель с хорошими метриками
может очень плохо оценивать вероятности.
И иногда это критичнее самой классификации.
Интуитивный примерПредставь две модели.
Обе предсказывают одинаково хорошо.
Но первая говорит:
👉 «вероятность дефолта 95%»
и оказывается права только в половине случаев.
А вторая:
👉 «вероятность дефолта 95%»
и реально попадает примерно в 95 случаях из 100.
Вторая модель calibrated.
Первая — нет.
Что вообще означает calibrationCalibration отвечает на простой вопрос:
«Можно ли доверять вероятностям модели?»
Если модель говорит:
👉 0.8 probability
то примерно в 80% таких случаев
событие действительно должно происходить.
Почему это важноОсобенно там,
где решение зависит именно от вероятности.
Например:
👉 кредитный скоринг
👉 медицина
👉 fraud detection
👉 ranking
👉 ad systems
Бизнес часто работает не с классом,
а с risk score.
Какие модели calibrated хужеНекоторые модели
по природе оценивают вероятности хуже других.
Например:
👉 Logistic Regression обычно калибрована неплохо
👉 Gradient Boosting часто слишком overconfident
👉 deep learning любит завышенную уверенность
Почему ROC-AUC тут не спасаетОчень частая история:
👉 ROC-AUC отличный
👉 а вероятности мусорные
Почему?
ROC-AUC оценивает ranking,
а не качество probability estimates.
Модель может:
👉 идеально ранжировать объекты
👉 и ужасно оценивать сами вероятности
одновременно.
Как проверяют calibrationОбычно используют:
👉 calibration curve
👉 reliability diagram
👉 Brier score
Если calibration плохой,
применяют:
👉 Platt Scaling
👉 Isotonic Regression
👉 temperature scaling для нейросетей
Почему это недооцениваютНа Kaggle calibration почти никого не волнует.
Там главное — leaderboard.
Но в реальном проде вероятность:
👉 0.97
👉 0.12
👉 0.83
часто становится бизнес-решением.
Например:
👉 выдать кредит
👉 заблокировать транзакцию
👉 отправить на ручную проверку
Главная мысль
В какой-то момент оказывается,
что качество вероятностей
важнее красивого ROC-AUC.
Читать полностью…
Data Science | Machinelearning [ru]
04 June 2026 09:07
Reinforce.fi Challenge: Market-Action Arena
Хакатон по reinforcement learning в трейдинге с призами до $2,500 от Reinforce.fi (ex-Overnight.fi)
Задача:
построить модель, которая на каждом шаге выбирает оптимальное действие (A1–A10) и максимизирует суммарный PnL.
Что внутри:
— анонимизированные market-like признаки
— последовательности по 1000 шагов
— частично наблюдаемая среда
— скоринг = суммарный PnL
Почему это интересно с engineering стороны:
— задача на policy optimization, а не классический supervised ML
— длинные эпизоды (1000 steps)
— важно устойчивое поведение модели, а не single-step accuracy
— приближено к реальному execution / trading loop
Призы:
1 место — $2,500
2 место — $1,500
3 место — $1,000
Старт: конец июня
Длительность: ~1.5–2 месяца
Регистрация:
https://forms.gle/UB71QuyUvp8mSBRo9
Чат хакатона:
/channel/+R6lMJ10VXP5hOTI0
Читать полностью…
Data Science | Machinelearning [ru]
01 June 2026 15:37
Российские ученые представили более быстрый и дешевый метод дообучения VLM
Команда исследователей из Т-Банка проверила, можно ли прокачивать визуально-языковые модели не в настоящих интерфейсах и средах, а в синтетических симуляторах — и переносить эти навыки на реальные задачи. И оказалось, что да: ученые представили метод VL-DAC, который учит модели совершать последовательность действий
Почему существующих методов недостаточно?
Современные VLM-модели неплохо понимают картинки, но начинают теряться, когда нужно действовать последовательно: открыть нужный раздел, выбрать объект, применить фильтр, построить маршрут или выполнить инструкцию шаг за шагом. И обучение таким сценариям в реальном мире дорогое и времязатратное. Можно тренировать модели в симуляторах, но существующие подходы требуют либо постоянного подбора коэффициентов вручную, либо большего количества памяти для хранения результатов о предыдущих шагах, либо смешивают обучение действию и оценке пользы выполненного действия. 🗒
Так был разработан метод VL-DAC. Модель обучалась сразу в нескольких средах для развития отдельных навыков:
•MiniWorld — навигация и маршруты
•Gym-Cards — выбор объекта по заданным условиям
•ALFWorld — выполнение инструкций и взаимодействие с внешними объектами
•WebShop — работа с веб-интерфейсами
Что получилось на практике?
После обучения модель Qwen2-VL-7B стала более чем на 50% лучше справляться с интерактивными задачами, улучшила пространственную ориентацию и веб-навигацию
Самое интересное — модель учится не только совершать действия, но и понимать, были ли они полезны для достижения цели. Это делает перенос навыков из симуляции в реальные задачи намного стабильнее 😐
Такой подход может пригодиться везде, где ИИ должен не просто видеть, а действовать: от банковских интерфейсов и ритейла до робототехники и логистики.
Data Science
Читать полностью…
Data Science | Machinelearning [ru]
27 May 2026 17:17
🖥 Как научить LLM работать с поиском в интернете
Мы уже давно научили модели решать задачи, как математические уравнения или вести разговоры. Но когда речь заходит о реальной проверке фактов, поиск и анализ информации в интернете для многих LLM остаётся проблемой. Ведь одного запроса в поисковике недостаточно. Как и нам, так и моделям нужно уметь «идти по следам», уточнять данные и делать выводы на основе множества источников. Именно для этого команда InfoAgent создала своего рода «веб-детектива» — агента на базе LLM, который эффективно и последовательно ищет, анализирует и сопоставляет данные.
Что же отличает этот подход от обычных поисковых систем? В том, что агент не просто делает один запрос и «сдаётся». Он строит целую цепочку шагов, как опытный аналитик, постепенно уточняя информацию и проверяя факты.
❓ Как работает агент?
Основной принцип работы модели заключается в чередовании двух инструментов: поиска и просмотра страниц. Поиск предоставляет список URL с короткими фрагментами текста, а просмотр — длинные фрагменты выбранных страниц. Все найденные данные фиксируются в контексте, создавая «след», который агент использует для дальнейших шагов, а не полагается исключительно на память.
Команда не использовала стандартные API для поиска. Вместо этого был создан собственный конвейер, который фильтрует и обрабатывает информацию гораздо точнее. Результаты поиска проходят через BM25, эмбеддинги и ререйканинг, что даёт возможность LLM собирать более точные и тематичные сниппеты.
❗️ Почему обычный «вики-ретривер» не подходит?
InfoAgent делает акцент на задаче, где важно не просто находить факты, а проверять их на глубоком уровне. Для этого они специально «размывают» данные — имена заменяются на описания, даты превращаются в диапазоны, а точные формулировки перефразируются. Это заставляет модель не торопиться и искать более точные данные. При этом вопросы подбираются таким образом, чтобы агент не мог дать быстрый ответ — они требуют развернутого анализа.
⁉️ Как обучают модель?
Основным этапом обучения является создание длинных траекторий запросов, иногда до 20 шагов, где каждый запрос уточняет предыдущий. Изначально агент учится на размеченных данных (SFT), а затем проходит этап усиления с помощью обучения с подкреплением (RL). Это помогает модели не останавливаться на первом попавшемся ответе, а продолжать искать до тех пор, пока не будет найдено точное решение.
🔼 На практике, агент InfoAgent демонстрирует выдающиеся результаты. Например, на сложных бенчмарках он показывает отличные результаты, часто обходя более крупные модели с большим количеством параметров. При этом переход от SFT к RL существенно повышает точность поиска, делая результаты более разнообразными и точными.
InfoAgent наглядно демонстрирует, как можно улучшить работу LLM с поиском в интернете. Он учит модель не просто генерировать ответы, а проводить глубокий анализ данных, проверять факты и делать выводы, как это делал бы каждый их нас. В конечном итоге, это подход, который может стать незаменимым в продуктах, где важна точность, проверка источников и репродукция информации.
Data Science
Читать полностью…
Data Science | Machinelearning [ru]
26 May 2026 17:07
Agentic Vision: Google превращает зрение модели в рабочий процесс
Google quietly выкатили Agentic Vision для Gemini 3 Flash, и это довольно важный сдвиг в том, как модели работают с изображениями. Вместо привычного «посмотри на картинку и ответь» теперь используется полноценный цикл Think–Act–Observe: модель сначала анализирует изображение и строит план, потом запускает код для обработки — детекцию, расчёты, измерения — и только после этого возвращается к рассуждению уже с новыми данными в контексте. Проще говоря, картинка превращается не в статичный вход, а в рабочее пространство для мышления. Типовой пример — подсчёт пальцев: модель не угадывает число, а реально детектит каждый палец, считает боксы и выводит результат. Лучше всего это заходит на сложных таблицах, схемах и мелких деталях, где обычное «визуальное понимание» раньше сыпалось. По метрикам прирост относительно обычной Gemini 3 Flash — в среднем 5–10%, а попробовать фичу уже можно и через API, и в AI Studio.
Data Science
Читать полностью…
Data Science | Machinelearning [ru]
25 May 2026 13:07
🤣 Мем отлично отражает настроения в сообществе прямо сейчас
✖️ xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
21 June 2026 14:07
Feature-wise Gradient Noise Injection против концептуального дрейфа
Концептуальный дрейф — это когда модель резко теряет качество, потому что данные поменялись. В online-пайплайнах это проблема номер один. Модель банально переобучается под текущее распределение, а при сдвиге — всё, метрики летят в тартарары. Ретрейнинг? Запаздывает. Детекция дрейфа? Тоже не сразу, да и переразметка нужна. Есть штука поизящнее — Feature-wise Gradient Noise Injection.
Суть метода
Коротко: добавляем шум к градиентам, но не абы как, а для каждого признака отдельно, с учётом его дисперсии в батче. Это мешает модели выучивать хрупкие паттерны, которые типичны для дрейфа. Признаки с высокой дисперсией — те, что чаще всего и дрейфуют — получают больше шума, их влияние на обновление весов снижается. Модель учится обобщать, а не запоминать случайные корреляции.
Почему это работает
Шум адаптируется под текущее распределение — если дисперсия меняется при дрейфе, шум автоматически подкручивается. И никакой отдельный детектор не нужен, регуляризация уже вшита в обучение. На мини-батче считаем дисперсию каждого признака σ²_j. Потом к градиенту по этому признаку добавляем шум N(0, λ·σ²_j). λ — гиперпараметр.
Пример на PyTorch
import torch

def add_feature_wise_noise(grad, features, lambda_noise=0.01):
    var = features.var(dim=0, unbiased=True)
    noise = torch.randn_like(grad) * (lambda_noise * var.sqrt())
    return grad + noise

for x_batch, y_batch in dataloader:
    pred = model(x_batch)
    loss = criterion(pred, y_batch)
    loss.backward()
    for param in model.parameters():
        if param.grad is not None:
            param.grad = add_feature_wise_noise(param.grad, x_batch)
    optimizer.step()
    optimizer.zero_grad()
Практические советы и предупреждения- λ — ключевой параметр. Слишком маленький — эффекта ноль. Слишком большой — модель перестанет сходиться. Я обычно начинаю с 10⁻³ и подбираю по валидации на исторических дрейфах. Это типичная ошибка — не настраивать λ под конкретные данные.
- FGNI не отменяет мониторинг дрейфа, но заметно повышает робастность в промежутках между детекциями. Он не заменяет отслеживание метрик, а дополняет его, давая дополнительный запас надёжности.
- Метод лучше всего заходит на tabular data и MLP. На RNN или трансформерах придётся модифицировать — шуметь, например, по hidden state. Прямое применение к градиентам параметров на этих архитектурах может быть нестабильным.
Вывод: Feature-wise gradient noise injection — простой и дешёвый по вычислениям способ сделать online-пайплайн устойчивее к дрейфу за счёт адаптивного регуляризатора прямо в градиентном спуске.
Читать полностью…
Data Science | Machinelearning [ru]
20 June 2026 14:07
Feature-wise quantization-aware training для production inference: как сохранить метрики при внедрении 4-битных моделей на GPU с ограниченной памятью
Квантование до INT4 в продакшене режет память, но часто убивает метрики на чувствительных признаках. Обычный QAT усредняет scale на весь тензор, и редкие, но критичные фичи затираются. Feature-wise QAT решает это на уровне отдельных признаков.
Почему обычный QAT ломает метрики
Стандартное квантование обучает единый scale для всего тензора. В production-моделях, особенно в рекомендательных системах или NLP, некоторые признаки имеют высокую дисперсию или распределены неравномерно. Пример — эмбеддинги редких сущностей или временные ряды с выбросами. Один scale усредняет эти выбросы, и модель теряет важные нюансы, теряя 2-5% на задачах классификации и регрессии.
Как работает Feature-wise QAT
Вместо общего scale ты учишь отдельные параметры для каждого признака: scale и zero-point. Во время fine-tuning модель подстраивает каждый канал под искажения при 4-битном представлении. Псевдокод кастомного слоя:
class QuantLayer(nn.Module):
    def __init__(self, num_features, bits=4):
        super().__init__()
        self.scales = nn.Parameter(torch.ones(num_features))
        self.zero_points = nn.Parameter(torch.zeros(num_features))
        self.max_val = 2**(bits-1) - 1

    def forward(self, x):
        x_scaled = x / self.scales
        x_quant = torch.clamp(torch.round(x_scaled), -self.max_val, self.max_val)
        return x_quant * self.scales
Практический совет: используй learnable параметры, инициализированные из предварительной калибровки на репрезентативном датасете. Это ускоряет сходимость и снижает риск переобучения.
Production-метрики и trade-offsНа BERT-подобных моделях FWQAT даёт прирост F1 на 2-3% относительно обычного QAT. ResNet-50 теряет всего 0.5% против FP32, тогда как стандартный QAT режет 2-3%. Типичная ошибка — тонкий fine-tuning без репрезентативной выборки. Для стабильности нужно минимум 1% обучающих данных с сохранением оригинального распределения. На старых GPU без аппаратного INT4 (например, P40) эмуляция дорогая, но гибрид Int8+FP16 через кастомные ops улучшает блочное квантование.
Инженерные нюансы при деплоеВ production FWQAT легко интегрируется: кастомные ops для TensorRT или прямой вызов learnable параметров из рантайма. Предупреждение: после fine-tuning обязательно перекалибруй scale и zero-point на валидационном датасете — иначе дрейф данных сломает метрики. Latency растёт на 5-10% из-за per-feature операций, но это окупается при памяти менее 4 ГБ на батч.
Вывод: Feature-wise QAT сохраняет метрики на production-моделях с INT4 за счёт раздельного квантования каждого признака, но требует репрезентативного fine-tuning и обязательной перекалибровки в production-пайплайне.
Читать полностью…
Data Science | Machinelearning [ru]
19 June 2026 14:07
Label Leakage: когда валидация врет, а метрики — это иллюзия
Радуешься ROC-AUC 0.99 на сложном пайплайне, а в проде модель выдает 0.6? Знакомо. Это label leakage — утечка таргета. Но часто проблема не в банальной ошибке вроде scaler.fit(X_train, y_train). Скрытые пути хитрее, и они любят засады на middle/senior уровнях.
1. Агрегаты с прицелом на будущее
Классика в feature engineering. Допустим, считаешь среднее по категории:
df['avg_target_by_city'] = df.groupby('city')['target'].transform('mean')Если делаешь это на всем датасете до разбивки на train/val, модель на валидации видит среднее, посчитанное с учетом future-меток. Метрики взлетают, в проде — провал.
Решение: агрегаты строго в рамках train-фолда через target_encoding в Pipeline или GroupKFold. И никаких transform до split.
2. Time-aware валидация: иллюзия порядкаВременные ряды без строгого разбиения по времени — утечка из-за shuffle. Модель на валидации подсматривает данные из будущего. Простое правило: никакого train_test_split с random_state. Используй TimeSeriesSplit или PurgedGroupTimeSeriesSplit. И проверяй lag-фичи — они любят заглядывать вперед. Типичная ошибка: добавление rolling-агрегатов на всем датасете, а не в рамках временного окна.
3. Фичи-строки, которые знают ответБывает, поле user_flag появляется только после события (таргета). Или transaction_id коррелирует с таргетом: новые транзакции — выше риск дефолта. Удали ID-поля, проверь корреляцию с таргетом. Значение >0.95 — явный leakage. Еще один production-пример: в NLP пайплайне, когда токен документа использется как фича, но он присваивается после разметки таргета. Это ломает валидацию в LabelPropagation на stream-данных.
Как детектировать скрытые утечки * Lasso-регрессия: если модель оставляет 1-2 фичи с огромными весами — red flag.
* Permutation importance: аномально высокое падение метрики при перестановке одной фичи.
* Lookahead bias audit: проверь, что признаки вычисляются на момент t-1, а не t. Используй reverse-engineering на отложенной выборке по времени.
Вывод: Label leakage убивает ML-продукт — лучше потратить час на аудит пайплайна с time-aware валидацией и permutation tests, чем два месяца на восстановление репутации.
Читать полностью…
Data Science | Machinelearning [ru]
18 June 2026 14:07
Delayed feedback в CVR-моделях: как не сломать обучение и оценку конверсий из-за запаздывающих лейблов
В CVR пользователь может конвертироваться через минуты, дни или недели после клика, поэтому разметка «как есть» часто превращает будущие positive в ложные negative. Это критично для рекламы, рекомендаций, marketplace-воронок и A/B-тестов, где модель обучается на неполных логах.
Проблема: лейбл может быть еще не созрел
Для клика в момент click_time = t мы хотим оценить:
P(conversion | click, x)
Но на дату сборки датасета T мы знаем только одно из двух:
* конверсия уже произошла до T
* конверсии пока не видно
Второй случай не равен converted = 0. Это censored observation: объект наблюдался недостаточно долго.
Типичная ошибка:
converted = 1, если conversion_time - click_time <= 7d
converted = 0, иначе
Так свежие клики получают искусственно заниженный CVR, модель учится на ложных negative, offline-метрики зависят от «зрелости» среза, а production-калибровка плывет: модель предсказывает full-window CVR, а мониторинг видит partial-window CVR.
Baseline: обучаться только на mature dataЕсли целевой горизонт - конверсия за 7 дней, а данные доступны до
2025-01-31, то в train стоит брать клики не позже
2025-01-24.
Плюсы:
* честные лейблы
* простая валидация
* легко дебажить пайплайн и leakage
Минусы:
* теряем свежие данные
* хуже адаптация к сезонности и изменению трафика
* при длинном conversion lag train сильно устаревает
Практический совет: явно храните в feature store или training dataset поля
event_time,
label_observed_until,
horizon и
label_age. Без них невозможно воспроизвести разметку и понять, почему CVR изменился после очередного retraining.
Более сильный подход: моделировать задержкуМожно разложить задачу на вероятность конверсии и распределение delay:
P(y = 1, delay <= H | x)Например:
* CVR-модель оценивает вероятность самой конверсии
* delay-модель оценивает
P(delay <= age | y=1, x)Это ближе к survival analysis: есть событие, time-to-event и censored observations. Такой подход особенно полезен, если задержка зависит от категории товара, канала, географии, цены, устройства или ретаргетинга.
Альтернатива - дискретный hazard:
P(conversion at day k | no conversion before day k, x)Тогда клик, наблюдавшийся только 2 дня, все еще полезен для обучения первых двух шагов, а не выбрасывается целиком. Trade-off: модель и inference становятся сложнее, зато меньше потерь данных и честнее работа с длинным хвостом конверсий.
Оценка: test тоже должен быть matureЕсли
horizon = 7d, то holdout должен содержать только объекты, для которых прошло минимум 7 дней после клика. Иначе вы измеряете не качество модели, а незрелость лейблов.
Хорошая схема:
train: clicks [D0, D1]
validation: clicks [D2, D3]
label cutoff: >= D3 + horizon
В production дополнительно смотрите метрики по delay buckets:
*
0-1h*
1-24h*
1-3d*
3-7d*
7d+Так видно, где ломается система: в быстрых конверсиях, длинном хвосте, data freshness, attribution или из-за цензурированных лейблов. Для A/B-тестов это особенно важно: ранний readout может завысить эффект модели, которая хорошо ловит быстрые конверсии, но проигрывает на полном окне.
Вывод:Delayed feedback в CVR - это не косметика разметки, а инженерное ограничение ML-системы: без mature labels, явного label cutoff и корректной валидации модель оптимизирует артефакты логирования вместо реальной конверсии.
Читать полностью…
Data Science | Machinelearning [ru]
16 June 2026 14:07
Как находить вредные обучающие примеры перед fine-tune: influence functions, TracIn и data pruning в production ML
В production ML «плохие» train-примеры могут стоить дорого: кластер mislabeled, устаревших или аномальных объектов способен стабильно ухудшать fine-tune на свежем срезе данных. Частая ошибка - чистить датасет только по эвристикам и не проверять, какие samples реально увеличивают loss на production-like validation.
1. Influence Functions
Идея: оценить, как изменится loss на validation-примере z_val, если немного увеличить вес train-примера z_train.
I(z_train, z_val) ≈ - ∇L_val^T H^-1 ∇L_train
где H - Hessian по параметрам модели.
Если influence большой и положительный, train-пример, вероятно, увеличивает validation loss и вредит качеству.
Плюсы:
- аккуратная теоретическая постановка;
- можно связывать конкретные train-примеры с конкретными ошибками модели.
Минусы:
- дорогой H^-1;
- плохо масштабируется на большие нейросети;
- чувствителен к non-convexity, batchnorm/dropout, чекпоинтам и приближению Hessian.
В production обычно используют приближения: LiSSA, conjugate gradients, low-rank approximation или считают influence только для последнего слоя / head модели.
2. TracIn
Более инженерный вариант: train-пример полезен для val-примера, если их градиенты по ходу обучения направлены похоже. Вреден - если направлены противоположно.
TracIn(z_train, z_val) = Σ_c η_c · ∇L_train(θ_c) · ∇L_val(θ_c)
где θ_c - чекпоинты, η_c - learning rate.
Сильно отрицательный score означает: train-пример тянет модель против направления, полезного для validation.
Мини-скетч для последнего слоя:
for ckpt in checkpoints:
    model.load_state_dict(load(ckpt))

    g_val = mean_grad(model.head, val_loader)

    for i, batch in enumerate(train_subset):
        g_train = grad(model.head, batch)
        scores[i] += lr[ckpt] * dot(g_train, g_val)

harmful = argsort(scores)[:K]
Практический совет: считайте score не по всему validation, а по важным production-срезам: новые пользователи, редкие классы, проблемные регионы, свежий drift, сегменты с высокой бизнес-ценой или высоким SLA.
3. Data pruning перед fine-tuneРабочий пайплайн:
1. Зафиксировать production-like validation set без leakage.
2. Обучить baseline / fine-tune и сохранить несколько чекпоинтов.
3. Посчитать influence или TracIn для
train→val.
4. Проверить top harmful samples:
- label noise;
- outdated distribution;
- конфликтующие дубликаты;
- corrupted inputs;
- неправильная task/schema version.
5. Удалить, downweight или отправить на relabeling.
6. Повторить fine-tune и проверить не только общий metric, но и regression по сегментам.
Production-пример: перед дообучением рекомендательной модели на свежих логах можно найти старые взаимодействия с изменившейся таксономией товаров, конфликтующие labels после миграции схемы или ботовый трафик, который ухудшает ranking loss на свежем holdout.
4. ПредупреждениеНе стоит слепо удалять все «вредные» примеры. Иногда они ухудшают текущий validation, но нужны для long-tail robustness, fairness или устойчивости к редким сценариям.
Безопаснее начинать с top-K, делать human-in-the-loop аудит, сравнивать варианты
remove /
downweight /
relabel и смотреть trade-off между quality, latency пересчета, стоимостью разметки, воспроизводимостью и надежностью мониторинга.
Вывод:Influence Functions и TracIn полезны не как магическая чистка данных, а как инженерный способ сделать fine-tuning менее токсичным к шуму, устаревшим данным и конфликтующей разметке.
Читать полностью…
Data Science | Machinelearning [ru]
14 June 2026 14:07
Конформные интервалы в production ML при covariate shift: как держать coverage без бесполезно широких предсказаний
Split conformal хорошо работает при exchangeability: train, calibration и test приходят из одного распределения. В production это часто ломается из-за гео, девайсов, каналов, сезонности или смены acquisition mix, а типичная ошибка - просто расширить интервалы “с запасом”.
Что именно ломается
При covariate shift имеем:
p_prod(x) != p_cal(x)
но предполагаем, что p(y|x) примерно сохраняется. Если считать обычный conformal quantile на старом calibration set, coverage на текущем трафике может просесть.
Наивное решение - увеличить correction глобально. Coverage частично вернется, но price prediction interval, ETA interval или forecast band станут настолько широкими, что downstream-система перестанет им доверять.
Базовый production-рецепт
1. Учим quantile-модель:
q_low(x), q_high(x)
2. На calibration set считаем nonconformity scores:
s_i = max(q_low(x_i)-y_i, y_i-q_high(x_i), 0)
3. Оцениваем importance weights:
w_i ~= p_prod(x_i) / p_cal(x_i)
4. Берем не обычный, а weighted quantile score'ов.
5. Для нового объекта строим:
C(x) = [q_low(x)-tau, q_high(x)+tau]
Минимальный скелет:
import numpy as np

def weighted_quantile(values, weights, q):
    order = np.argsort(values)
    v = np.asarray(values)[order]
    w = np.asarray(weights)[order]
    cw = np.cumsum(w)
    return v[np.searchsorted(cw, q * cw[-1])]

alpha = 0.1

scores = np.maximum(q_low_cal - y_cal,
                    y_cal - q_high_cal,
                    0)

weights = ratio_model.predict_weight(X_cal)
tau = weighted_quantile(scores, weights, 1 - alpha)

low = q_low_prod - tau
high = q_high_prod + tau
Так calibration distribution становится ближе к production distribution без грубого раздувания всех интервалов.
Как не получить слишком широкие интервалыОдин глобальный
tau часто переоценивает неопределенность, если ошибка модели сильно зависит от
x.
Практически помогают:
-
CQR вместо point prediction: Conformalized Quantile Regression уже моделирует heteroscedastic uncertainty, поэтому conformal correction обычно меньше.
-
Нормализованный score: например
s_i = |y_i - y_hat_i| / sigma_hat(x_i), а интервал строится как
y_hat(x) +- tau * sigma_hat(x).
-
Локальная калибровка: отдельный
tau по geo, device, channel, price bucket или risk bucket. Это близко к Mondrian conformal, но требует достаточного числа calibration examples в каждом сегменте.
-
Rolling calibration buffer: для рекомендаций, скоринга и forecasting старый calibration set быстро перестает описывать текущий traffic mix.
Главный риск - плохие весаDensity ratio model может быть шумной. Несколько объектов с огромными весами фактически “заменят” весь calibration set.
Контролируйте:
ESS = (sum w)^2 / sum(w^2)Если ESS низкий, weighted quantile нестабилен, а интервалы начинают прыгать от релиза к релизу.
Практичные меры:
- clip weights и мониторить долю clipped weights;
- сглаживать density ratio;
- объединять редкие сегменты;
- не калибровать сегмент, где мало свежих labels;
- запускать перекалибровку при падении ESS или drift по
X.
Production-чеклист- отдельный calibration set, не смешанный с training;
- drift detection по feature distribution;
- density ratio model между prod traffic и calibration traffic;
- weighted conformal calibration;
- мониторинг coverage, average width, coverage по slices, ESS и latency;
- алерты на рост ширины интервалов без роста ошибки;
- A/B validation, если интервалы влияют на routing, fallback или human review.
Важно не путать marginal и conditional coverage. Conformal может держать 90% coverage на потоке в среднем, но проваливаться в отдельных микросегментах. В production это надо проверять явно.
Вывод:При covariate shift цель не в том, чтобы слепо расширить интервалы, а в том, чтобы калибровать их под текущую смесь production-объектов и контролировать надежность этой калибровки.
Читать полностью…
Data Science | Machinelearning [ru]
13 June 2026 12:07
Corpus drift в RAG-системах: как заметить деградацию retrieval без разметки, labels и явных ошибок
В RAG retrieval часто ломается тихо: модель та же, embedding model тот же, prompt тот же, latency в норме, а ответы стали хуже. Типичная ошибка - сразу крутить prompt или ругать LLM, хотя проблема ниже: изменился корпус.
1. Мониторьте drift самого корпуса
Мы не измеряем качество напрямую, но смотрим, как изменилось пространство, в котором работает retriever:
- распределение embedding-ов чанков;
- средняя длина чанка, overlap, число чанков на документ;
- доля новых, удалённых и изменённых чанков;
- дубликаты и near-duplicates;
- распределение доменов, типов документов, языков, дат;
- плотность embedding-пространства: не стало ли много «слипшихся» чанков.
Если корпус заметно сдвинулся, старые retrieval-пороги и ожидания по top-k могут стать мусором. Особенно если confidence logic завязана на score или gap между top-1 и top-2.
2. Anchor queries вместо labels
В production почти никогда нет labels вида «для этого query релевантны вот эти chunks». Но можно взять стабильный набор production-запросов: например, 500-5000 частых или бизнес-критичных query.
Это не разметка. Мы не знаем правильный chunk. Но знаем, что retrieval-поведение не должно хаотично меняться после каждого обновления корпуса.
Для каждого anchor query сохраняйте baseline:
- top-k doc/chunk ids;
- retrieval scores;
- rank positions;
- gap между top-1 и top-2;
- diversity top-k;
- source distribution.
После обновления корпуса сравнивайте новый retrieval с baseline.
Полезные proxy-метрики:
- Jaccard@k между старым и новым top-k;
- rank churn: сколько документов поменяло позиции;
- score distribution shift;
- падение top-1 score;
- уменьшение score gap;
- рост доли low-confidence retrieval;
- изменение источников в top-k;
- рост почти одинаковых чанков в top-k.
Минимальный набор, который уже даёт сигнал:
- mean_jaccard@10;
- p95_top1_score_drop;
- score_wasserstein между baseline и current scores.
3. Как интерпретировать сигналы
- mean_jaccard@10 резко упал: retriever стал приносить другой контекст;
- top-1 score системно падает: запросы хуже матчятся с корпусом;
- score distribution сильно сдвинулась: старые thresholds и confidence logic могли сломаться.
Практический совет: считайте эти метрики не только глобально, но и по сегментам - источникам, языкам, типам документов, продуктовым доменам. Глобальный average легко скрывает деградацию в критичном сегменте.
4. Retrieval confidence без ground truth
Даже без разметки можно смотреть на «уверенность» ретривера:
- высокий top-1 score;
- большой gap между top-1 и top-2;
- согласованность dense retrieval и BM25;
- стабильность top-k при query rewriting;
- низкая доля дубликатов в top-k;
- покрытие нужных источников.
Если dense и lexical retrieval внезапно начали расходиться, не стоит списывать это на шум. Часто это значит, что корпус или запросы изменились так, что одна из стратегий больше не работает как раньше.
Production minimum для RAG:
- хранить snapshot retrieval-результатов для anchor queries;
- считать overlap, score drift и rank churn после каждого обновления корпуса;
- отдельно мониторить дубликаты, новые чанки и распределения источников;
- заводить alerts не на один query, а на агрегаты по сегментам.
Corpus drift неприятен тем, что не выглядит как авария. Система отвечает, ошибок нет, latency нормальная. Просто контекст стал чуть менее релевантным. Потом ещё чуть менее. И качество RAG медленно проседает.
Вывод:
Без labels нельзя честно измерить relevance, но можно мониторить стабильность retrieval-поведения, уверенность ретривера и изменения корпуса, чтобы поймать деградацию раньше пользователей.
Читать полностью…
Data Science | Machinelearning [ru]
10 June 2026 20:07
Turbo ML Conf 2026: конференция в области машинного обучения и ИИ пройдет в Москве в третий раз
На мероприятии, которое Т-Технологии проведут 18 июля в ДК “Серп и Молот”, соберутся ML-инженеры, исследователи, продакты и техлиды AI/ML-команд из крупнейших российских компаний. В этом году организаторы делают Turbo ML Conf 2026 более хардовым: меньше воды, больше практической информации и упор на практику в реальных кейсах. Одна из ключевых тем — разработка современных моделей, их архитектурные особенности и интеграция в конечные продукты. Программа разделена на три направления. Первое посвящено архитектуре современных моделей, их интерпретируемости, безопасному поведению, способности к рассуждению и самокоррекции. Второе — внедрению ML в продукты, интеграции классических и GenAI-моделей, влиянию на бизнес-метрики и пользовательский опыт. Третье — пайплайнам данных, методам дообучения, низкоуровневой оптимизации инференса и инфраструктуре. В программе — демозоны от ведущих компаний про продуктовые, платформенные решения с применением ML, а также выступления спикеров, которыми станут более 20 экспертов из Т-Банка, Яндекса, Авито, Сбера и Института AIRI. Участие бесплатное по предварительной регистрации. Количество мест ограничено.
Data Science
Читать полностью…
Data Science | Machinelearning [ru]
10 June 2026 09:07
Когда ИИ-агент выходит за пределы экспериментов, одного «умного чата» становится мало. Чтобы агент был полезен в рабочей разработке, ему нужны правила, доступ к инструментам, понятный контекст, проверка действий и безопасная обвязка. Иначе вместо ускорения команда получает непредсказуемость, лишние риски и дорогой хаос в контекстном окне.
На открытом уроке 15 июня в 20:00 разберём, как устроены современные ИИ-агенты и их обвязка: правила, модули навыков и MCP — протокол подключения модели к внешним инструментам.
Поговорим, чем поведенческий слой агента отличается от слоя подключения, где искать готовые навыки, почему они стали популярны и как их устанавливать. Отдельно обсудим, как с помощью MCP дать агенту нужные инструменты, не перегружая контекст, а также как защищать агентов: схемы проверки, журналы аудита и типовые способы атак.
Урок не для тех, кто хочет просто «подключить агента к проекту» без правил, контроля и понимания рисков. И не для тех, кто считает, что рабочая интеграция ИИ — это только написать хороший запрос.
Регистрация: https://vk.cc/cYDpol
Реклама. ООО «Отус онлайн-образование», ОГРН 1177746618576, www.otus.ru
Читать полностью…
Data Science | Machinelearning [ru]
04 June 2026 16:37
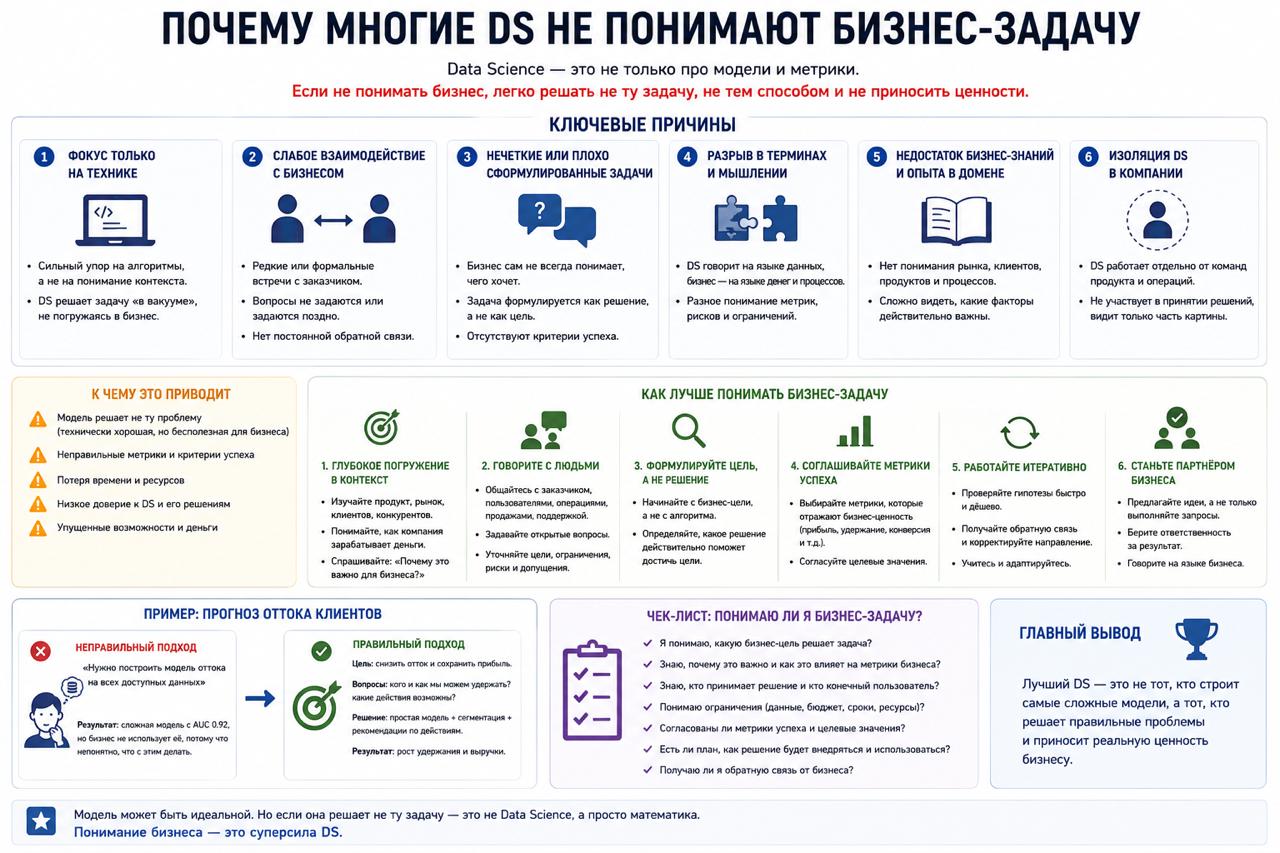
Почему многие DS не понимают бизнес-задачу
Одна из самых частых проблем в Data Science
вообще не связана с моделями.
Многие DS отлично знают:
👉 метрики
👉 архитектуры
👉 feature engineering
👉 Python
👉 математику
Но при этом плохо понимают,
зачем бизнесу нужна модель.
И это потом очень заметно в работе.
Когда ML уходит в вакуумНапример,
человек может месяцами улучшать ROC-AUC:
👉 с 0.91 до 0.93
Хотя для бизнеса разницы почти нет.
Или строить сложную систему там,
где хватило бы пары SQL-правил.
И наоборот:
👉 модель с «неидеальными» метриками
👉 может приносить много денег
потому что хорошо встроена в процесс.
Откуда начинается проблемаБольшинство курсов учат:
👉 обучать модели
👉 подбирать гиперпараметры
👉 улучшать benchmark
Но почти не учат задавать вопросы:
👉 что именно пытается оптимизировать бизнес?
👉 сколько стоит ошибка?
👉 как модель будут использовать?
👉 кто принимает решения на основе предсказаний?
Хотя это важнее половины ML-стека.
Метрика ≠ цель бизнесаМногие воспринимают задачу как:
«Получить максимальную метрику».
Хотя в реальности задача обычно звучит иначе:
👉 уменьшить churn
👉 снизить потери
👉 ускорить процесс
👉 сократить ручную работу
И иногда лучший ML-проект —
это вообще не ML.
Прод быстро возвращает в реальностьБизнесу всё равно:
👉 какой у тебя encoder
👉 сколько слоёв
👉 какой learning rate
Его интересует:
👉 работает ли система
👉 экономит ли деньги
👉 не ломается ли каждую неделю
Частая ошибкаЛюди начинают:
👉 с модели
👉 обсуждают архитектуру
👉 спорят про CatBoost vs XGBoost
Ещё до того,
как нормально поняли саму задачу.
Хотя хороший DS обычно сначала пытается понять:
👉 откуда берутся данные
👉 как принимаются решения
👉 где появляется ценность
И только потом думает про модель.
Главная мысльСильные специалисты часто отличаются
не тем, что знают больше алгоритмов.
А тем,
что умеют связывать:
👉 данные
👉 продукт
👉 ограничения
👉 деньги
👉 реальный процесс
Без этого ML очень быстро превращается
в дорогую игрушку.
Читать полностью…
Data Science | Machinelearning [ru]
03 June 2026 17:07
🤣 Не баг, а фича
✖️ xCode Journal
Читать полностью…
Data Science | Machinelearning [ru]
28 May 2026 17:07
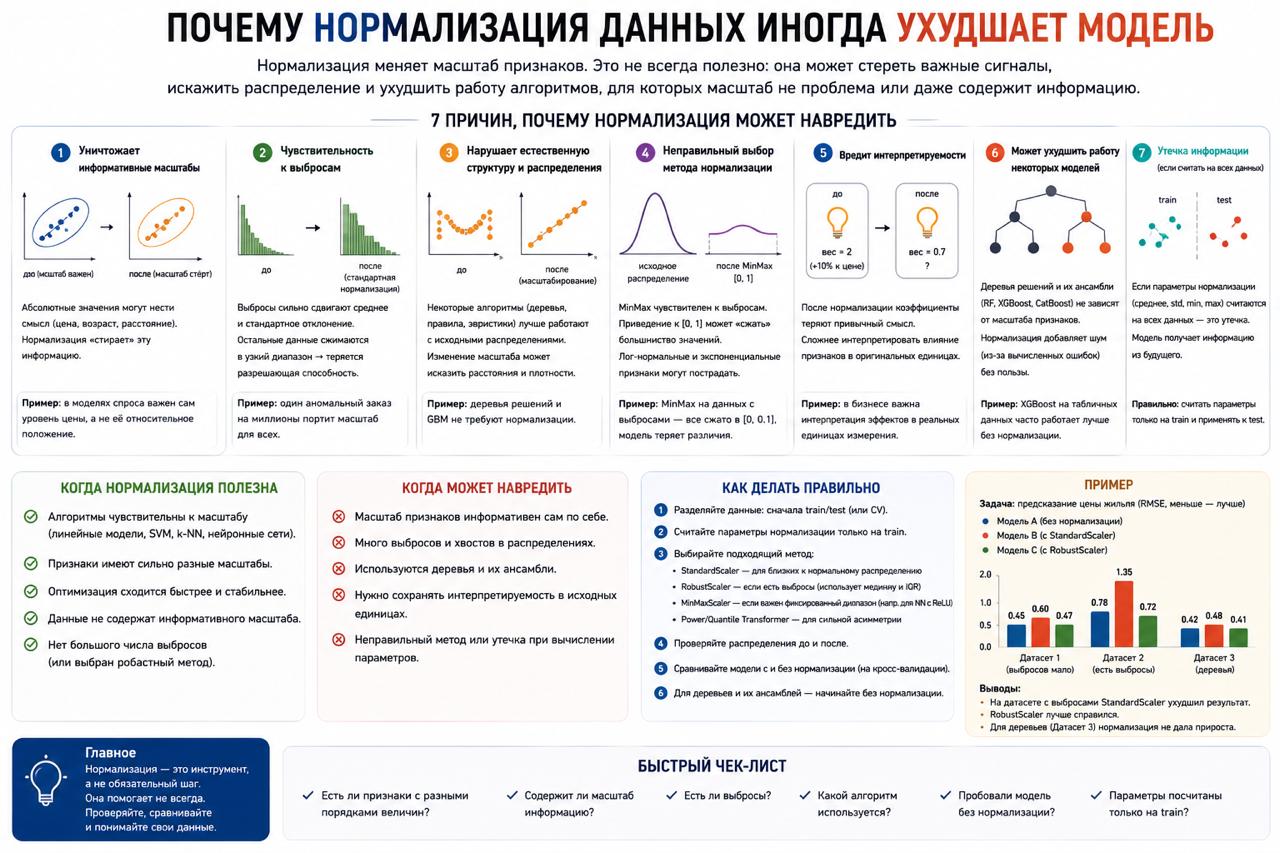
Почему нормализация данных иногда ухудшает модель
Есть совет,
который почти все слышат в начале изучения ML:
«Всегда нормализуй данные».
Проблема в том,
что это не универсальное правило.
Иногда после scaling
модель становится не лучше, а хуже.
Особенно это удивляет людей
после перехода с учебных задач на реальные данные.
Зачем вообще нужна нормализацияОна приводит признаки к одному масштабу.
Например:
👉 возраст: 18–60
👉 зарплата: 1000–300000
Для некоторых моделей это действительно критично.
В первую очередь:
👉 Logistic Regression
👉 SVM
👉 KNN
👉 нейросети
Они чувствительны к масштабу признаков.
Без scaling:
👉 обучение может быть нестабильным
👉 градиенты становятся странными
👉 одна фича начинает доминировать над другими
Но дальше начинается самое интересноеДля деревьев scaling обычно почти бесполезен.
👉 Random Forest
👉 XGBoost
👉 LightGBM
👉 CatBoost
работают через split’ы:
feature < threshold
Им не особо важно:
👉 0.5 это
👉 5000
👉 или 500000
Структура дерева от этого почти не меняется.
И поэтому люди иногда строят огромный preprocessing pipeline,
который вообще ничего не улучшает.
Иногда scaling реально портит модельОсобенно если:
👉 много выбросов
👉 странные распределения
👉 heavy tails
👉 шумные данные
После StandardScaler часть фич
может стать менее информативной.
Автоматический scaling — частая ловушкаМногие делают scaling,
даже не задавая вопрос:
«А моей модели это вообще нужно?»
Просто потому что:
👉 «так принято»
Хотя на практике:
👉 CatBoost отлично работает на сырых данных
👉 табличные бустинги сами справляются с масштабами
👉 лишняя обработка только усложняет pipeline
Отдельная классика — leakage через scalingКогда человек:
👉 нормализует весь датасет
👉 потом делает train/test split
И модель уже косвенно «видела» test.
Метрики после такого обычно очень красивые.
До первого прода.
Главная мысльОдна из главных проблем в ML —
привычка применять техники автоматически.
Scaling — это не улучшение данных само по себе.
Это инструмент под конкретный алгоритм.
Читать полностью…
Data Science | Machinelearning [ru]
27 May 2026 08:07
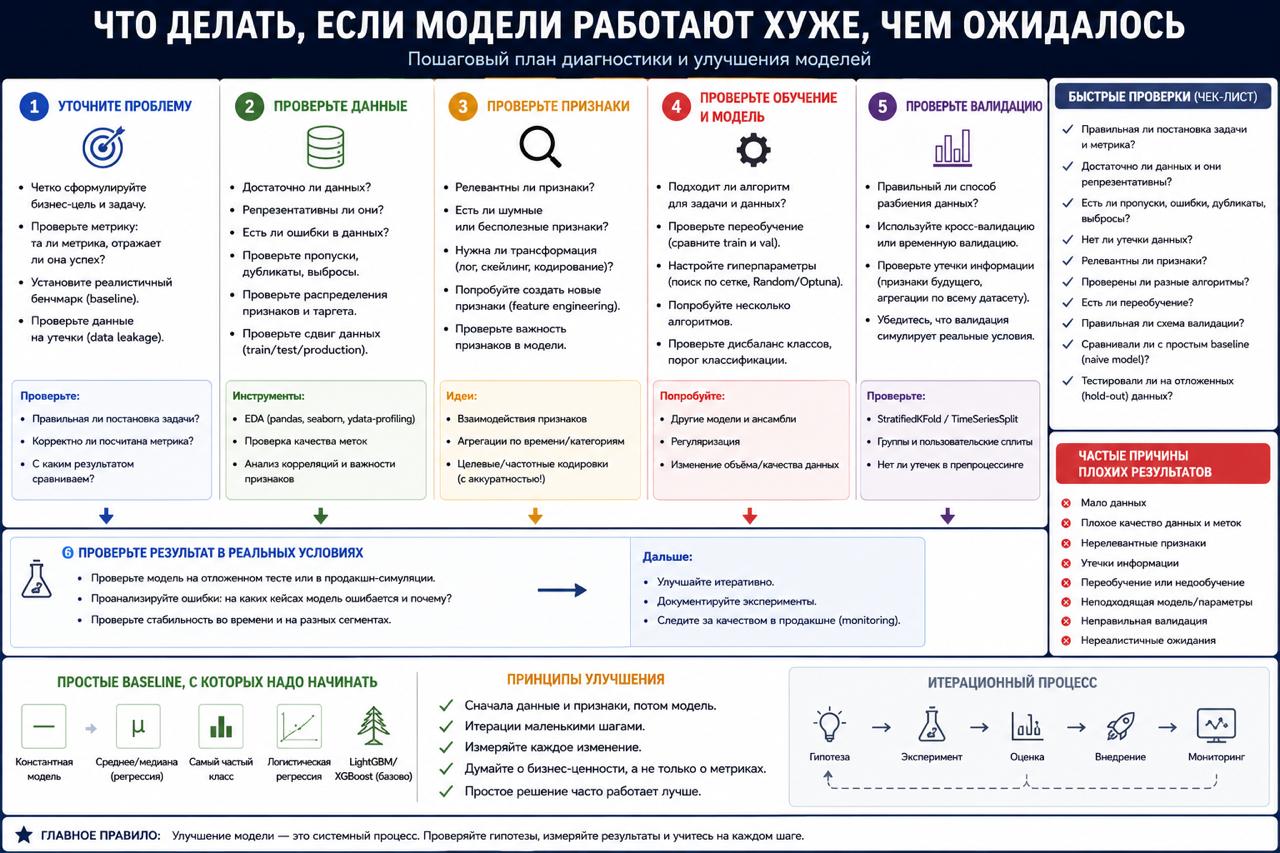
Что делать, если модели работают хуже, чем ожидалось
Почти у всех в ML есть этот момент.
Ты:
👉 почистил данные
👉 обучил модель
👉 потратил кучу времени
👉 посмотрел метрики…
И качество оказалось намного хуже,
чем ты ожидал.
Первая мысль обычно:
«Нужна модель посложнее».
По опыту,
это ошибка процентов в 80 случаев.
Чаще проблема вообще не в модели.
Первое, что стоит проверить — данныеОчень часто оказывается, что:
👉 target шумный
👉 классы плохо разделяются
👉 половина фич бесполезна
👉 в данных мало сигнала
Некоторые задачи в принципе плохо предсказываются.
И это нормально.
Есть ощущение,
что многие ждут от ML магии:
«Если модель умная —
она всё найдёт сама».
Не найдёт.
Если в данных нет устойчивой закономерности,
XGBoost её не создаст.
Вторая проблема — leakage или плохой splitОсобенно в табличных данных.
Иногда offline всё красиво:
👉 ROC-AUC = 0.95
👉 accuracy почти идеальная
А потом модель разваливается на новых данных.
И наоборот тоже бывает:
Метрики низкие,
потому что split слишком жёсткий и реалистичный.
Ещё одна частая история — неправильная метрикаНапример:
👉 оптимизируют accuracy при сильном дисбалансе
👉 смотрят ROC-AUC там, где важен precision
👉 радуются хорошему loss, который ничего не значит для бизнеса
Модель может быть «математически хорошей»
и бесполезной одновременно.
Baseline почти всегда недооцениваютИногда:
👉 логистическая регрессия
👉 среднее по группе
👉 простое правило руками
дают результат близкий к сложной модели.
И это не провал.
Наоборот.
Это хороший сигнал,
что задача либо почти линейная,
либо данных мало.
Есть ещё неприятная вещьНекоторые задачи просто не стоят ML.
Серьёзно.
Бывает, что:
👉 данных недостаточно
👉 поддержка модели дороже выгоды
👉 бизнес-эффект минимальный
Но многие продолжают:
👉 тюнить learning rate
👉 менять архитектуры
👉 гонять AutoML
👉 перебирать 40 моделей
Потому что «мы же делаем AI».
Хотя даже нормально не посмотрели:
👉 распределения
👉 ошибки модели
👉 качество target’а
А именно там обычно и лежит ответ.
Читать полностью…
Data Science | Machinelearning [ru]
26 May 2026 09:07
Галлюцинации LLM: где модель помогает, а где уверенно врёт
Большие языковые модели выглядят как всезнающие эксперты. Текст гладкий, уверенный, логичный. Ровно до тех пор, пока не выясняется, что все это были галлюцинации. Давай разберёмся, где галлюцинации — это ожидаемое поведение модели, а где они quietly превращаются в серьёзную проблему.
1. Где галлюцинации — это «нормально»
Модель не знает, она продолжает
LLM — это не база фактов, а сверхмощный автодополнитель. Её цель — сгенерировать правдоподобное продолжение, а не истину.
Недостаток или неоднозначность данных
Если вопрос редкий, свежий или нишевый, модель просто заполняет пробелы. Она не умеет сказать «я не знаю» без отдельного обучения.
Креативные задачи
В сторителлинге и брейншторме галлюцинации — это не баг, а фича. Проблемы начинаются, когда тот же режим включается в фактах и коде.
2. Где начинаются проблемы
Фактические вопросы
Чат-бот уверенно сообщает неверные даты, имена и события. И пользователь принимает это за правду.
Генерация кода
• Функции, которых не существует.
• API, которых никогда не было.
• Код выглядит правильно — пока не запускаешь.
Критические домены
Юриспруденция, медицина, финансы. Здесь «звучит убедительно» = потенциальная катастрофа.
Уверенный тон без знаний
Самое опасное — модель не сомневается. Она не краснеет, не делает пауз, не оговаривается.
3. Что реально снижает галлюцинации
RAG (привязка к данным)
Модель отвечает не «из головы», а по конкретным документам. Есть источник — меньше фантазий.
Дообучение и выравнивание
RLHF, domain fine-tuning, обучение говорить «я не уверен». Модель учат быть осторожной, а не болтливой.
Чёткие инструкции:
— отвечай только по контексту
— если не знаешь — скажи
— обоснуй каждый шаг
Иногда этого уже достаточно.
• Пост-проверки и правила
• Тесты для кода
• Проверка ссылок
• Фильтры на запрещённые паттерны
Попросить модель:
— проверить себя
— оценить уверенность
— пересмотреть ответ
4. Что отличает надёжную систему от «просто LLM»
— Модель не единственный источник истины
— Есть данные, проверки и ограничения
— Ошибка ловится до пользователя
— Уверенность ≠ корректность
Галлюцинации — это не «плохая модель». Это следствие того, что LLM всегда старается ответить. И если не обложить её контекстом, проверками и правилами, она будет стрелять в ногу ровно так же уверенно, как и рассуждать.
Data Science
Читать полностью…
Data Science | Machinelearning [ru]
25 May 2026 10:07
Устал инициализировать претрейны весами Qwen? Приходи к нам — мы честно учим с нуля! 😉
Ищем Senior/Senior+ AI Engineer и продактов в RnD-команду: как отдельных специалистов, так и целые команды, — которые готовы разрабатывать прорывные AI-решения.
Познакомиться ближе с нашими направлениями и оставить отклик можно на сайте.
А если хотите следить за тем, как команда RnD ML Сбера исследует и разрабатывает AI-технологии, — подписывайтесь на Telegram-канал команды. Там делятся исследованиями, экспериментами и инсайтами из мира AI, а также свежими вакансиями 🚀
Читать полностью…


 19745