Тру.Маркетинг | Первухин
05 November 2026 12:41
🧑💻⚡ИИ научился делать хорошие тестовые. А как теперь искать хороших специалистов?
Друзья, мы продолжаем наш #seo_разбор. Недавно проводили SEO-интенсив и проверяли тестовые задания участников. Набралось больше сотни. Для нас это уже почти ежегодный ритуал, но в этот раз заметили любопытную штуку.
✔ ИИ стал делать очень крутые тестовые. Даже если кандидат в теме разбирается так себе, на выходе аккуратная аналитика с выводами и структурой. Раньше такие ребята просто ничего не присылали. Теперь присылают.
Мы эти работы видим сразу, но только потому, что сами следим за ИИ каждый день и знаем, что он делает хорошо, а что нет.
Самое интересное, что
потенциал аналитика всё равно считывается:
✔️где задачу просто
загнали в нейросеть и отправили как есть
✔️где человек
сам думал над задачей, проверял и сомневался
✔️и главное, у таких кандидатов в анализе почти всегда
больше параметров, чем просил бриф
Вот этот
"захват шире задачи" мы ценим больше всего. Его пока не заменит ни один промпт.
Но пост не про то, как сложно сейчас искать сильных. С этим мы справляемся, и команда у нас лучшая. Пост
про скорость. За очень короткий срок даже базовые модели научились собирать аналитику.
Будет ли она верной на 100%? Нет, и о том, почему, мы уже писали
здесь.
Но если ИИ так меняет подбор команды, он меняет и продвижение бизнеса. Люди всё чаще ищут через ИИ, решают через ИИ и покупают тоже через него. Поэтому наше GEO-продвижение сейчас так востребовано: свои наработки мы
начали делать ещё на заре нейросетей, и это дало свои плоды.
💬 Короче, ИИ уже никуда не денется. И, кажется, главный навык теперь не просто уметь им пользоваться, а понимать, когда ему
можно доверять, а когда лучше перепроверить.
Всем хорошего дня и побольше лимитов на аккаунте ❤️
Читать полностью…
Тру.Маркетинг | Первухин
30 October 2026 10:48
🎃 Будущее немного пугает. И дело не только в Хеллоуине
Друзья, в преддверии Хеллоуина решил вас маленько попугать. Привычные модели потребления меняются, население стареет, ИИ встраивается буквально во все, а мировая экономика потихоньку перестраивается.
👻 Тут мне попался MEGATRENDS 2026 от Copenhagen Institute for Futures Studies (CIFS) - исследование глобальных изменений, которые будут определять развитие общества, технологий и экономики в ближайшие десятилетия. Я выбрал несколько трендов и посмотрел на них глазами маркетолога.
Например, к 2060 году уже 28% населения стран ОЭСР будет старше 65 лет, а домохозяйства становятся все меньше (и вот вам повод пересмотреть привычные портреты ЦА). Параллельно центр потребительского спроса смещается, а ИИ все глубже встраивается в сервисы и устройства.
Думаю теперь мало понять, кто ваш покупатель. Теперь интересно еще и то, кто будет помогать ему выбирать - сам человек, алгоритм или оба сразу. И как под это перестраивать маркетинг..
Кстати, мне кажется, самое интересное тут даже не сами тренды, а то, как они накладываются друг на друга. Одно дело, когда аудитория стареет, другое - когда она одновременно меняет привычки, способы покупки и взаимодействия с технологиями. И вот тут уже возникают вполне практические вопросы к продукту, медиамиксу и стратегии на ближайшие годы.
Спойлер: не все так страшно, как кажется. Хотя парочка трендов вполне тянет на хоррор 😁
Всем лидов ❤️
Читать полностью…
Тру.Маркетинг | Первухин
26 October 2026 10:31
🤖 Ситуация 1: я сделал робота, который отвечает на звонки. Ситуация 2: людей бесят роботы 😁
Друзья, понедельничная рубрика #что_происходит - цифры, новости рынка и мысли, которые они у меня вызывают.
✔ 62% россиян раздражает, как сложно пробиться через робота к живому оператору. 58% злит, когда новый оператор не знает, о чем был прошлый разговор, и проблему приходится объяснять заново. Больше 70% обращаются в поддержку несколько раз с одним и тем же вопросом, а 12% вообще не пишут, потому что не верят, что помогут (исследование edna, увидел у PRO Retail тут)
У нас в агентстве телефонные звонки - это или доставка, или спам, или низкокачественные лиды. При этом, мы стоим на втором месте Яндекс Карт по запросам, связанным с продвижением, и получаем много звонков. И, наконец, я нашел и адаптировал под наши задачи ИИ-оператора, который более-менее внятно отвечает и даже консультирует. Делал это осознанно: понимаю, что ценно этим людям и каждый целевой получит ответ после мини-опроса.
Что касается исследования - с самими чат-ботами трудности у 37% (не большинство), а на то, что сложно добраться до человека, жалуются 62%. То есть людей раздражает не робот как таковой, а раздражает то, что он недоступен, и что после него все начинается с нуля. В этом суть.
📌 Где ошибаемся.. чат-бота обычно внедряют ради экономии, а успех считают по доле обращений, которые он закрыл. Но если человек пришел три раза с одним вопросом, в отчете это может выглядеть как три обращения и три закрытия. А 12%, которые даже не пишут, в отчете не появятся вообще.
Где тут про маркетинг - мы платим за заявку из рекламы, а потом между этой заявкой и менеджером иногда ставим робота (как я сделал). Человек, который был готов купить, упирается в стену и уходит к конкуренту.
✍️ Но по существу бот всегда сможет ответить и проконсультировать в любое время и в выходные тоже.. а человеческая поддержка? Засеките, сколько обычно минут идет дозвон до специалиста. Поэтому стратегически умный бот покруче человека. Но тут ключевое слово - умный, а этим нужно заниматься, само оно таким не станет.
Всем лидов и хорошей недели ❤️
Читать полностью…
Тру.Маркетинг | Первухин
21 October 2026 11:56
🔥 Жара в Хьюстоне, пробки в Лос-Анджелесе и +135% дохода: как мы перестроили маркетинг для арт-студии
🇺🇸 Друзья, сегодня свежий кейс из США. Shot of Art - сеть интерактивных арт-студий с локациями в Нью-Йорке, Лос-Анджелесе, Чикаго, Хьюстоне и Orange County. Там не учат рисовать в классическом смысле - люди приходят стрелять краской по холсту, делать спин-арты, устраивать свидания и вечеринки. Стандартная логика performance здесь практически не работает.
Можно идеально почистить семантику и подкрутить ставки, но если человек на самом деле ищет не Fluid Art, а "куда сходить на свидание", вы оптимизируете вообще не тот спрос..
✔ На старте контекст по городам обеспечивал ROAS
около 170-220%, email жил массовыми рассылками по всей базе, а таргет не дотягивал до порога окупаемости. Причем первые стандартные итерации оптимизации контекста ситуацию не исправили. Тогда мы пошли глубже: в мотивацию человека, географию, сезонность и конкретные данные бронирований.
Итак, что сделали: ✔Собрали каналы вокруг одной бизнес-метрики. Для контекста, email и таргета зафиксировали один ориентир -
деньги. Не клики ради кликов, не объем отправок и не красивый CTR.
✔Нашли конкретный интент в данных бронирований. Выгрузка из PEEK показала, что 43,5% бронирований приходятся на свидания, еще 28,6% - на дни рождения. И вот тут многое стало понятным: раньше кампании выстраивались вокруг конкретных форматов развлечений, а клиент покупал прежде всего
повод провести время вместе. ✔Начали учитывать экономику конкретного города. В Хьюстоне жара поддерживала спрос на indoor-развлечения даже летом. В Лос-Анджелесе проблемой оказались расстояния и пробки, поэтому рекламу разделили по радиусу и начали сразу показывать адрес. Вместо одной универсальной схемы каждый город стал отдельным рынком со своей логикой спроса.
✔В email отказались от логики "больше писем - больше денег». Когортный анализ показал, что 55-60% покупателей совершают покупку в первые пять минут после подписки. Поэтому Welcome-цепочку перестроили под быстрое завершение покупки, а не под длинный "прогрев".
Параллельно выяснили, что массовые рассылки создавали почти весь объем отправок, но приносили
менее 9% прямой выручки, тогда как одно триггерное письмо было в сотни раз эффективнее.
🔎️️️️️️ Отдельная история -
брошенная корзина. Peek работал внутри iframe и не отдавал нужные события напрямую в
Klaviyo, поэтому собрали передачу данных
через GTM: email, город, выбранный формат, дату, время и ссылку на восстановление конкретной брони. Уже после этого можно было строить нормальные триггерные сценарии.
Что получили: ✔ ROAS контекста вырос
до 300% в низкий сезон и
400-500% в высокий.
✔ После перестройки кампаний вокруг повода ROAS достигал
452% в Нью-Йорке и
527% в Лос-Анджелесе.
✔ Click Rate Welcome-цепочки вырос
на 46%.✔ Чистый доход email без учета новых точек вырос примерно
на 135%. 👀️️️️️️
На заметку: если у бизнеса несколько каналов, не начинайте с идеи о том, "как их связать". Сначала найдите данные, которые описывают причину покупки. В нашем случае такой точкой стала выгрузка причин бронирования из PEEK.
✔ Подробнее -
по ссылоньке. Всем лидов ❤️
Читать полностью…
Тру.Маркетинг | Первухин
16 October 2026 10:51
😎 Пятничный ликбез: как IAB предлагает измерять видимость бренда в нейросетях
Друзья, в августе IAB выпустила стандарт измерения видимости брендов в ответах ИИ. IAB - американская ассоциация интернет-рекламы, это они в свое время задали стандартные размеры баннеров и формат видеорекламы, которыми рынок пользуется до сих пор.
Кто делал.. Над документом работала группа из брендов, агентств и компаний, которые занимаются замерами: Walmart, WPP Media, Microsoft и пр.. Руководит группой Кэролайн Гигерих, вице-президент IAB по ИИ, среди участников Грэм Уилкинсон, директор по инновациям и руководитель направления ИИ в Anthropic.
У ChatGPT больше 900 млн пользователей в неделю. ИИ-ответы Google появляются почти в половине поисковых запросов и уже в 14% запросов о покупках. McKinsey оценивает, что неподготовленные бренды могут потерять от 20 до 50% трафика из обычного поиска. А систематически следят за своей видимостью в нейросетях только 16% брендов (думаю в России это 3-5%).
Кратенько 🤓
Про гонку за упоминаниями. Бренд может стоять в ответе первым или последним, его могут уверенно советовать или упомянуть мимоходом,
описать точно или с ошибками. Поэтому IAB раскладывает видимость на четыре уровня:
✔Присутствие - есть ли бренд в ответах, как часто на него ссылаются и какая у него доля против конкурентов.
✔Заметность - на каком месте он стоит.
✔Образ - каким тоном нейросеть о нем говорит и сколько в описании выдумок и фактических ошибок.
✔Убедительность - насколько уверенно она его рекомендует и переходят ли люди по ссылке после ответа.
Мне тут особенно нравится, что факт упоминания отделили от его качества.. Попасть в ответ и быть первым рекомендованным вариантом - совсем не одно и то же.
🤔 Где мы можем иногда ошибаться как предприниматели:
✔Верим одной цифре или метрике. Один и тот же вопрос, заданный нейросети дважды, дает разные бренды и разные источники. Честная цифра звучит как «около 22%, плюс-минус 4 пункта», а рост на пару пунктов за месяц может оказаться случайностью.
✔Принимаем решения по пинку)). IAB делит данные на два уровня: одни показывают тенденцию, на другие можно опираться, когда распределяешь бюджет. Ошибка - путать первое со вторым.
✔Нюансы сервисов замера. Сервисов замера уже больше 20, и для одного бренда они выдают разные цифры, потому что задают нейросетям разные вопросы и по-разному считают.
Особенность в том, что предприниматель часто выбирает услугу как коммодити - сколько и чего я получу, и прикидкой на профит в заказах и деньгах. И будет абсолютно прав, но только на верхнем уровне. Гонка за видимостью сама по себе пустая, важна триада метрик - место упоминания (первое и пятое, как я писал, это разное).. тональность упоминаний и доля относительно конкурентов.
🔗 Сам документ, по ссылочке
Хороших выходных ❤️
Читать полностью…
Тру.Маркетинг | Первухин
09 October 2026 07:00
😈 Анти-гайд по рабочей репутации от The Guardian
The Guardian недавно собрал большой гайд по современному этикету.
Главная мысль там довольно точная: сегодня вежливость все меньше про формальности и все больше про то, сколько чужого времени, внимания и личного пространства вы забрали без спроса.
Голосовое вместо текста, «Принято» без контекста, Zoom из кофейни, телефон экраном вверх на встрече - вроде мелочи, а именно из них часто и складывается репутация человека, с которым либо удобно работать, либо не очень.
Вы знаете, кому это отправить 😏
Всем лидов и хороших выходных ❤️
Читать полностью…
Тру.Маркетинг | Первухин
02 October 2026 11:50
🧠 Покупатель устал, но всё ещё хочет удивляться
Вы, наверное, уже в курсе про Future Consumer 2027: Emotions от WGSN. Больше исследование, где сформирован портрет человека ближайшего будущего: он хочет меньше обязательств (неожиданно) и уведомлений, больше радости - и всё меньше верит слишком красивым обещаниям (для нас, как маркетологов, это зона трансформации).
📌 Несколько поинтов из этого замечательного отчета
✔️Радость становится вполне практичной задачей. После долгого периода стресса люди целенаправленно ищут больше приятного в повседневности. WGSN называет это Strategic Joy почему-то: юмор, игра и маленькие сюрпризы становятся способом немного выдохнуть. Почти 6 из 10 участников исследования говорят, что игривость бренда улучшает их отношение к компании. Для маркетинга сработать может неожиданный подарок, игровой сценарий или просто то, что будет приятно обнаружить.
✔️Люди хотят меньше обязательств. WGSN использует слово witherwill (по-русски это уизевил) - желание освободиться от лишних планов, списков дел и решений. Даже популярность Vienna Билли Джоэла у зумеров здесь вспоминают не случайно: идея «можно не спешить» снова звучит очень актуально. Поэтому бесплатная отмена, пауза подписки и отсутствие лишних условий могут быть не менее убедительными, чем скидка.
✔️Доверие придётся не обещать, а показывать. Suspicious Optimism - это ситуация, когда человек одновременно любит новые технологии и сомневается в отзывах, фотографиях и слишком идеальной рекламе. Отсюда рост ценности независимых обзоров, creator-led reviews, комментариев экспертов и нормального бэкстейджа. Вопрос аудитории всё чаще звучит не «что вы обещаете?», а «как я могу это проверить?».
✔️Экономят уже не только деньги, но и силы. WGSN говорит о Return on Energy: человек оценивает, сколько внимания и действий требует от него продукт. Отсюда же ping minimalism — стремление выключать лишние уведомления. Меньше пушей и писем, дайджест вместо пяти сообщений, повтор заказа в один клик, готовая подборка вместо двадцати фильтров - тоже часть ценности продукта.
✔Отдельно понравилась идея Kid Intelligence: оставлять человеку пространство для любопытства, игры и эксперимента. Для брендов это хороший повод предложить аудитории самой что-то собрать, изменить, протестировать или придумать.
Кажется, в 2027 конкурировать будут ещё и за то, сколько энергии человек готов вам отдать.
Всем лидов ❤️
Читать полностью…
Тру.Маркетинг | Первухин
30 September 2026 11:36
⚡️Про омниканальность...
В омниканальном маркетинге легко несправедливо наказать хороший канал — просто потому что часть покупок не попадает в аналитику.
🎨 Продвигали «Передвижник» (сеть магазинов профессиональных художественных материалов): 10 розничных точек и интернет-магазин с ассортиментом 12к+ товаров. Покупатель мог увидеть рекламу или письмо, посмотреть товар на сайте, а потом спокойно прийти в магазин и оплатить на кассе. Для бизнеса продажа случилась, но офлайн -> онлайн интеграции нет.
🤔 Директ и email существовали каждый в своей системе координат - Директ оптимизировался по CPO, хотя дешёвая конверсия совсем не обязательно означала выгодный заказ, а еmail мог привести человека в магазин, но если тот не кликнул по письму перед покупкой, вклад рассылки оставался невидимым.
🤓 Такой роадмап у нас получился:
✔Сначала починили измеряемость. Настроили передачу Client ID в CRM и загрузку офлайн-конверсий обратно в Метрику. Долю офлайн-транзакций, которые удалось сопоставить с визитами, подняли с 4% до 87%.
Для email сделали похожую штуку - сопоставили адреса подписчиков с картами лояльности. И увидели интересную вещь: человек мог прочитать письмо, вообще не заходить на сайт, а в течение нескольких дней купить товар в рознице.
✔Перестали дросмотреть на СРО в Директе: если в одном магазине продаются и недорогие расходники, и дорогие профессиональные товары, CPO довольно быстро начинает работать против бизнеса, алгоритму проще привести много дешёвых заказов.
Перевели управление на ограничение по ДРР и параллельно провели ABC-анализ ассортимента по онлайн- и офлайн-продажам. Бюджет перераспределили в пользу категорий, которые действительно формировали выручку.
Отдельно разделили кампании на новых и действующих клиентов.. Тут важный момент: если оставить всех вместе, алгоритм закономерно тянется к тем, кого проще и дешевле сконвертировать. А это часто уже знакомые с брендом покупатели.
✔В email больше сначала занялись инфраструктурой, а уже потом красотой. Вместо нового дизайна писем, механик и креативов просто разобрались со структурой отправки, настроили постмастеры, DMARC и FBL, разобрались с доставляемостью и жалобами. И только потом собрали триггерные цепочки: брошенную корзину, welcome-сценарии, письма ко дню рождения и другие механики.
😁 А вот потом уже позволили себе немного повеселиться. Появился постоянный персонаж, игровые письма, картины в стиле Ван Гога, слоны с Дали и больше 40 A/B-тестов подписных механик - всё ради того, чтобы письма хотелось открывать, а не листать мимо очередного баннера со скидкой (по ссылке ниже там можно глянуть)
📊 В итоге:
✔ДРР Директа снизили с 39% до 18% за полгода
✔долю сопоставленных офлайн-транзакций подняли с 4% до 87%
✔ROI email удержали выше 1500% при ДРР 2-3%
✔открываемость рассылок стабилизировали на уровне 30-40%
🔗 Подробнее - по ссылоньке.
Всем лидов ❤️
Читать полностью…
Тру.Маркетинг | Первухин
25 September 2026 06:00
Привет! Сегодня релиз подкаста — у меня в гостях Евгения Григорьева, директор по маркетингу hh.ru 🚀
Разбираемся, как в этом живёт главная площадка рынка труда. Говорим о маркетинге компании, которая одновременно работает на миллионы соискателей и продаёт услуги работодателям, и о том, как балансировать между этими сторонами:
👉 Почему синие воротнички сейчас в дефиците, а белые - в профиците?
👉 Что будет с наймом, когда резюме пишет нейронка и читает тоже нейронка?
👉 Почему почти 20% пользователей заходят на hh.ru не за работой, а просто поскроллить вакансии и успокоиться?
👉 Как юмор и стендаперы привели на платформу молодёжь?
👉 Почему лидеру рынка больше нет смысла вкладываться в top of mind и куда идут деньги вместо этого?
👉 Какие компетенции маркетолога станут критичными через 3-5 лет?
И бонус в конце: история о том, как AI-агент «выгорел» 😁 🤖
✅ Выпуск будет полезен CMO и руководителям, которые строят бренд сразу для нескольких аудиторий, и всем, кто нанимает людей в 2026 году.
🎧 Слушать на Яндекс Музыке
🚀 Слушать в Telegram
Всем лидов и классных кандидатов, а кандидатам хороших предложений 🫡❤️
Читать полностью…
Тру.Маркетинг | Первухин
21 September 2026 13:03
Друзья, продолжаем рубрику #что_происходит, где я собираю интересные цифры, новости, исследования по рынку и делюсь мыслями, которые они у меня вызывают.
Моя любимая "тёмная сторона" формулирует разницу между хорошим продуктом и прорывным на примерах Shopify, Uber, Airbnb: прорывной не тот, что делает существующее быстрее, а тот, что делает недоступное раньше доступным условно 1000 людям вместо одного. И предлагает применить эту рамку к ИИ-продуктам.
Сейчас почти все ИИ-стартапы, которые я вижу, делают ровно то, от чего автор (надеюсь, что посты пишет все еще Морейнис) предостерегает: они берут существующий процесс и ускоряют его. Быстрее написать письмо, быстрее собрать отчёт, быстрее сделать креатив. Это полезно, это продаётся, но это не прорыв в смысле Shopify или Uber, потому что Shopify не ускорил открытие магазина для тех, кто и так умел его открывать, он сделал предпринимателем того, кто раньше им физически не мог стать.
Что мешает фаундерам думать в категориях новой аудитории, а не старого процесса? Подозреваю, что дело в измеримости. "Ускорили в 3 раза" считается легко, это понятная метрика для питча инвестору (или своему руководителю). "Сделали доступным для людей, которых раньше в рынке вообще не было" считать почти нечем, пока эти люди не появились и не заплатили.
Дальше это упирается прямо в меня и чем я занимаюсь. Если продукт создаёт аудиторию, которой раньше не было, как её вообще продвигать? У неё нет привычного языка запроса, она не ищет то, чего для неё не существовало, соответственно рекламу на такую аудиторию не настроишь стандартными методами, там нет истории поведения, на которую можно опереться. Это рынок, который классическая воронка видит как шум, или вовсе невиден.
И еще - Uber и Airbnb стали прорывом не из-за технологий, там не было великого изобретения, было снятие барьера "неудобно, дорого, страшно". Такси и раньше можно было вызвать, комнату и раньше можно было снять. Интересно, применимо ли это мышление к нашим нишевым рынкам, где барьер часто не технологический, а просто "я не знаю, к кому обратиться" или "мне страшно доверить это незнакомой компании". Может, прорыв там ищут не там, где нужно.
Пока без вывода. Смотрю, кто из ИИ-продуктов в следующем году сделает ставку на новую аудиторию и сбудется ли предсказания Маска, что скоро будет первая миллиардная компания, которая состоит из одного человека и тысяч ИИ-агентов.
Всем лидов ❤️
На этой неделе новый подкаст
Читать полностью…
Тру.Маркетинг | Первухин
14 September 2026 10:39
Друзья, продолжаем рубрику - #что_происходит, где я собираю интересные новости, цифры и исследования по рынку, а еще записываю мысли, которые они у меня вызывают.
✔️ Автор делится промптом, который заставляет ИИ-агента не подтверждать план, а фальсифицировать его, искать риски и слепые зоны вместо доказательств того, что всё сделано правильно
Бесит же, что ИИ со всем соглашается? И тут ребята воспроизвели в агентах ровно это - условно спроси агента
"подтверди, что план хороший" и он его подтвердит, спроси
"найди, почему план провалится», и он найдёт. Я даже готовлю материал, где наш специалист по настройке Директа будет настраивать РК строго по совету ИИ и посмотрим что из этого выйдет))
Но вернемся к новости. В чем тут прикол: агента переучить проще и быстрее, чем человека. Человека, который годами защищает свои решения, так просто не переформулируешь в "а подумай, в чем ты неправ" - это стресс. Зато промпт можно поменять.. И вот вопрос: если ИИ настроить на самокритику по отношению к компании, кто-то ведь реально начнёт следовать тому, что он скажет в своей области. Или все будут писать промпты, которые молча подтверждают уже принятое решение? Подозреваю, что вторых будет больше.
Инструмент самоуспокоения продать себе проще, чем инструмент самокритики, даже если оба стоят одинаково. Мы просим подтвердить свое решение не в явном же виде (а когда даем задачу, нам уже кажется что задача решается наилучшим способом именно так). Осталось перекинуть на ИИ рутину, но как будто важнее кто-то (скилл) кто будет за нас делать шаг назад и рефлексировать. Сам путь-то верный? Или мы просто сжигаем на это время и токены?
Попробовали бы на своих текущих задачах спросить агента не "всё ли я учёл", или еще лучше "где я вру себе". Разница в ответе будет показательной. И для меня болезненной, скрывать не буду.
Всем лидов и хорошей недели❤️
Читать полностью…
Тру.Маркетинг | Первухин
09 September 2026 12:30
Превратили письма благотворительного фонда в историю заботы 🫶
Забота в переписке устроена почти как в жизни: если писать человеку только тогда, когда тебе от него что-то нужно, отношения быстро истончаются. В благотворительности это чувствуется острее, чем в других вертикалях - каждое письмо либо согревает и напоминает, что о вас помнят, либо просто напоминает о себе.
Клиент - РООИ «Перспектива», одна из крупнейших российских НКО, более 25 лет помогает людям с инвалидностью получать образование, работу и защищать права.
Регулярные пожертвования критичны для планирования проектов, но email при этом существовал как канал точечных сборов: рассылки шли на всю базу без деления на сегменты, автоматических сценариев не было, и коммуникация происходила только в моменты, когда маркетолог вручную отправлял письмо. При этом аудитория внутри совсем разная - кто-то только подписался, кто-то сделал первый донат, кто-то помогает регулярно, а кто-то давно пропал с радаров.
Мы решили не делать очередную серию рассылок, а перестроить логику целиком - связать контент, триггеры, сегментацию и работу с базой в одну CRM-систему.
✔ Этап 1. Сделали письма разговором, а не просьбой. Мы все остро чувствуем искренность и честность, просто кожей понимаем где стоит помочь и откликается, а где нет. Вместо повторяющихся призывов задонатить рассылки стали рассказывать, чем живет фонд: например, как работают образовательные и юридические программы, каких результатов удалось достичь благодаря взносам.
✔ Этап 2. Настроили заботу под каждый этап пути человека. Для новых подписчиков собрали Welcome-серию: сначала знакомство с фондом, потом истории и результаты, и только потом - предложение регулярной поддержки. Письма после пожертвования превращали разовый контакт в начало отношений: благодарность, информация про регулярную помощь.
Реактивацию запускали через 60 дней после последнего разового доната, а для регулярных доноров - через 32 дня, если очередной платеж не пришел. Отдельно настроили сервисные письма про ошибку оплаты - они уходили сразу после неуспешной попытки и возвращали человека именно туда, где что-то пошло не так технически.
✔ Этап 3. Расширили круг людей рядом с фондом и позаботились о качестве базы. Параллельно с удержанием добавили новые точки входа:
✔ Email-виджеты на сайте
✔ Push-виджеты
✔ Чекбокс согласия прямо в форме поддержки - логика простая, человек уже проявил доверие фонду, значит и вероятность остаться на связи выше, чем при обычной подписке.
И регулярно очищали базу от неактивных адресов, которые не открывали письма больше полугода - чтобы письма, которые действительно важны, доходили до тех, кому они нужны.
✔ Результаты:
✔ 84% всего ассоциированного дохода триггерных рассылок в марте принёс один сценарий - "Ошибка платежа"
✔ 85 конверсий обеспечили автоматические сценарии в феврале - без единой ручной рассылки за этот период
✔ 300+ новых подписчиков за первые три месяца пришли только через push-виджеты
✍️ На заметку: у каждого человека рядом с фондом есть свой жизненный цикл, и заботу о нем нужно планировать заранее, до того как он перестанет открывать письма. Разница между напоминанием на 32-й день и на 60-й - это забота о том, что разовый и регулярный донор отдаляются от фонда по разным причинам и в разном темпе, и им нужна разная бережность.
🔗 Полный кейс с примерами писем и скринами - по ссылоньке.
Всем лидов ❤️
Читать полностью…
Тру.Маркетинг | Первухин
07 September 2026 12:27
Привет!
Сегодня особенный выпуск подкаста.. в гостях «Лемана ПРО» (бывший Леруа Мерлен) 🤓
Поговорили с Анной Грибовой, операционным директором по маркетингу «Лемана ПРО», о маркетинге DIY-ритейла - там, где спрос зависит от рынка недвижимости, сезонности и доходов покупателей.
Разбираемся, как компания адаптируется к перестройке рынка, борется за клиента с маркетплейсами и нейросетями и выстраивает честную атрибуцию между онлайн и офлайн:
👉 Как прошёл ребрендинг 16 СТМ в 5 зонтичных брендов?
👉 Почему маркетплейсы - это и канал продаж, и риск потерять клиента?
👉 Как выстроить честную атрибуцию между онлайн-касанием и офлайн-покупкой?
👉 Куда движется рынок DIY - от "сделай сам" к "сделай для меня"?
👉 Как нейросети меняют путь покупателя и что с этим делать ритейлеру?
✅ Этот выпуск особенно полезен тем, кто работает в ритейле, строит омниканальный маркетинг или разбирается в атрибуции между каналами.
🎧 Слушать на Яндекс Музыке
🚀 Слушать в Telegram
Всем лидов и хорошей недели❤️
Читать полностью…
Тру.Маркетинг | Первухин
02 September 2026 10:48
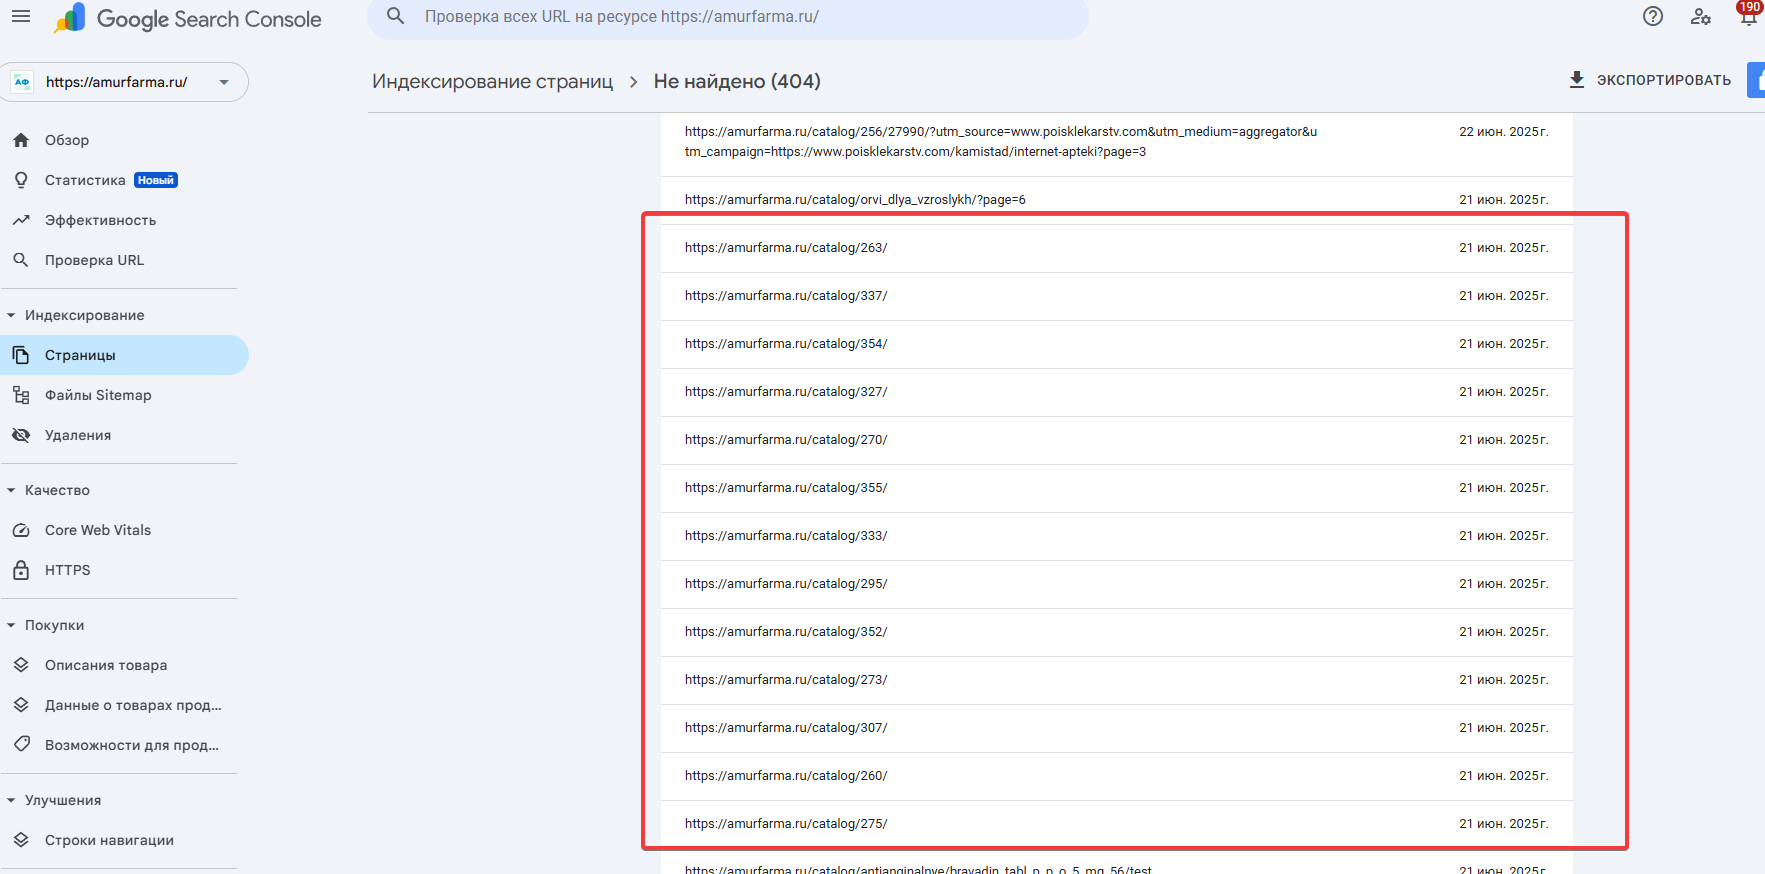
🧐 Пять лет назад мы удалили старые страницы каталога. Bing пришёл за ними в 2026-м
Друзья, продолжаем #seoразбор. Сегодня про неожиданные мувы от поисковых систем... В общем, лет пять урлы проекта никак себя не проявляли - ни трафика, ни ошибок. Про них не вспоминали, потому что вспоминать было не о чем - структура каталога изменилась при редизайне, ссылки вычистили, страницы отдавали 410 и лежали мёртвым грузом.
Потом ИИ начали собирать корпуса и заново обходить веб, и краулеры полезли туда, куда годами не заглядывали.. 😅
✔ Что мы увидели в логах
✔Пласт из ~500 URL, которых нет нигде: ни в меню, ни в фильтрах, ни в sitemap, ни во внутренних ссылках. Проверили - это структура каталога до редизайна. Пятилетней давности.
✔Обход идёт двумя ботами: Bingbot и Googlebot Smartphone. Десктопный Googlebot по этим адресам не заходит вообще - по нему нули во всех строках. Код ответа сервера - 410.
📎 Google Search Console по тем же разделам каталога показывает свой отчёт. Два разных кода на один пласт URL - повод отдельно проверить конфигурацию.
🤓 Почему это важно именно сейчас. Bing раньше был для рунета фоновым шумом (для мелких проектов и сейчас тоже). Трафика почти нет, что там в его индексе - пофиг. Сейчас на этот индекс опирается часть ИИ-ассистентов, когда ищет информацию для ответа. Google параллельно тянет то же самое в свои ИИ-ответы.
Разница в том, что поисковик показывает ссылку, а ассистент пересказывает содержимое. Мёртвая страница из индекса перестала быть строчкой в отчёте - она стала потенциальным источником фактов о компании.
Вы почистили сайт, но не почистили то, что о сайте помнят.
✔Отдельно про 410. Это довольно четкий сигнал краулеру: «удалено навсегда, не возвращайся».
В итоге - сопоставили старые ID категорий с новыми и настроили 301 редиректы на актуальные страницы каталога. Тут логика простая: раз боты всё равно приходят по этим адресам, пусть каждый дойдёт до живой страницы и заберёт актуальный контент, а не упрётся в пустой ответ.
🧑💻 Что забрать себе. Индекс - не всегда "зеркало сайта". Пока архивом никто не пользовался, его содержимое ничего не стоило. Теперь на нём учатся и по нему отвечают.
И второе: этих страниц не было ни в GSC-обзоре, ни в краулере, ни в аналитике. Их видно только в логах. Мы не нашли новую проблему - мы нашли проблему, которая лежала пять лет и стала проблемой, когда изменился рынок. Делайте на все устаревшие лучше 301, чтобы мусор не уходил в ИИ.
Всем лидов ❤️
Читать полностью…
Тру.Маркетинг | Первухин
28 August 2026 10:30
Небольшой пятничный гайд по трендам зумеров: что они делают и что с этим делать брендам ✍️
Мы как индустрия слишком любим объяснять поведение молодой аудитории одним словом - "инфантилизм", "клиповое мышление", и прочие ярлычки, которые когда-то навешивали и нам.. По факту за каждой такой привычкой стоит вполне трезвая логика: если что-то большое недостижимо в обозримом будущем, разумно инвестировать в то, что даёт результат прямо сейчас, пытаться наслаждаться жизнью, а не корить себя бесконечно.
Пять интересных паттернов:
✔ Карьерные амулеты вместо коучинга - реакция на рынок труда, где рациональные советы перестали ощущаться как рабочие. Подробнее
✔ Little treat economy - маленькие покупки вместо больших целей, которые физически недостижимы в обозримом будущем. Читал тут про это
✔ Kidult economy - коллекционирование игрушек как взрослая версия управляемого дофамина. Интересная статья
✔ Аналоговые хобби и сумки без телефона - осознанный откат от бесконечного скролла в пользу занятий с видимым результатом.
✔ Кружки по интересам вместо нетворкинга - поиск живых связей через совместное действие, а не через обмен визитками.. Тренд еще с прошлого года (кстати, вы уже видели, тренд про фейковые свадьбы? По-моему прикольная штука, я бы поучаствовал)
⚡️ С т.з маркетинга мы должны уметь превращать тренды в простые понятные механики с быстрой наградой: выбрать, собрать, персонализировать, сделать встречу и там подсветить нативно бренд. Тогда это уже нормальный продуктовый сценарий, который может работать на продажи, базу или возвращаемость.
Хороших выходных, берегите себя ❤️
Читать полностью…
Тру.Маркетинг | Первухин
05 November 2026 11:53
Кажется, у нас тут повод немного похвастаться 🏆
KINETICA заняла 3 место в номинации «Лучшее GEO-агентство 2026 года» на GEOMI Awards.
Ребятам огромное спасибо, гордимся! 💜
Читать полностью…
Тру.Маркетинг | Первухин
28 October 2026 11:23
⚡️Про SEO-аудиты пару слов
Уже потихоньку ИИ-задачи, ИИ-np, и ИИ-аудиты стали частью нашей работы. Это отлично. Нейронка внятно формулирует, что хочет сказать автор, и где-то прячет отсутствие его квалификации, что в целом не так уж и плохо.
Проблемка наверное в том как реагирует клиент на правки по этим ТЗ. Там же и лишней работы много (правки ради правок, которые в целом неплохо было бы сделать, но затраты сильно больше профита). И есть вопрос в отсутствии данных по конкурентам в части трафика (по посадочным и по каналам). То, что ИИ придумывает как потенциальный трафик пока больше галлюцинации: ну пользователь попросил предположить - я предположил..
То есть ИИ, например, нашёл страницу и решил, что она работает. Сам проверить, приносит ли она трафик, он не мог: у него нет позиций. Новый лендинг, скорее всего, начал бы конкурировать с главной, плюс часы дизайнера, копирайтера и разработчика. Главный вопрос здесь: окупится ли новая страница быстрее, чем усиление уже растущей главной. Эту часть ИИ не считал.
👀 Почему так происходит? Не потому что модель глупая. У неё просто другая выборка:
✔️HTML страницы и несколько конкурентов.
✔️Кэш без привязки к региону и устройству.
✔️Общие best practices и документацию Google.
Поэтому мы всегда находим референсы среди более 1000 доступных нам счетчиков метрики (проектов) в разных тематиках, видим позиции по региону, Wordstat, историю URL, трафик, логи, Вебмастер проектов в этой тематике. ИИ может не заметить, что сайт не растет из-за robots.txt, дублей URL, JS-рендеринга, внутреннего веса или каннибализации. И еще один момент: модель не видит спрос, поэтому сначала пишет красивый заголовок, а потом подгоняет под него логику.
🤓 Ну и по GEO та же логика: нейросеть легко накидает десятки тем для публикаций и способов попасть в ИИ-ответы. Но до того как платить за контент, стоит посмотреть, по каким запросам бренд уже упоминается, какие источники цитируют нейросети и где конкуренты получают преимущество.
Кстати, недавно я разбирал, как это измерять и что конкретно влияет на цитируемость.
🔗 Чуть подробнее - по ссылоньке, а если есть вопросы по GEO я тут
Всем проверенных гипотез и органического трафика ❤️🚀
Читать полностью…
Тру.Маркетинг | Первухин
23 October 2026 09:44
🚀 Что пора перестать делать руководителю, чтобы ИИ начал окупаться
Друзья, привет. СберУниверситет выпустил отчет о том, как ИИ меняет работу руководителя. Это выжимка: команда разобрала больше 8 500 публикаций из 80+ российских и мировых источников, от McKinsey и BCG до MIT, и свела все в 19 изменений по схеме «перестать - изменить - начать».
📊 Почему тема важная. По данным McKinsey, 94% компаний встраивают ИИ поверх старых процессов и измеримой отдачи не получают. А 6% тех, кто сначала перестроил процессы, прибавляют к операционной прибыли. В MIT насчитали, что проваливается 95% экспериментов с ИИ. При этом решения по ИИ все чаще принимает сам первый руководитель: в опросе BCG среди 2 360 руководителей 72% генеральных директоров сказали, что решают лично.
⚠️ Где мы ошибаемся:
✔Ускоряем отчет, а потом отправляем его по прежнему кругу бессмысленных согласований (про нормальное делегирование я уже писал тут)
✔Экономим время одному сотруднику и добавляем работы тому, кто проверяет результат. По данным, которые приводит Harvard Business Review, на сверку и проверку может уходить до 30% рабочего времени.
✔Я бы тут выделил как главное: автоматизируем операцию, которая вообще не нужна. Она стала дешевле, но пользы от нее не прибавилось.
✍️ Что предлагают в отчете:
✔️ Перестать собирать совещания ради пересказа статусов. По данным Asana, это 60% всех рабочих встреч. Статусы ИИ соберет сам: что сделано, где просрочки, что мешает.
✔️ Изменить подход к автоматизации: перед стартом разложить процесс на этапы и про каждый спросить по порядку - можно ли его убрать, объединить с другим или отдать ИИ.
✔️ Начать фиксировать, что именно делает ИИ: какую задачу, на каких данных, где вмешался человек. Ошибки моделей тихие, они не ломают систему, а уходят дальше по цепочке.
🤓 Что думаю.. ИИ окупается не там, где его купили, а там, где что-то перестали делать или стали делать в разы быстрее. Поэтому на старте любого внедрения я бы первым задавал не вопрос о том, «какой инструмент взять», а о том, «что команда сможет делать через месяц больше (быстрее)». Если в плане только новые пункты «освоить, настроить, проверить», нагрузка вырастет, а отдачи не будет. В маркетинге то же самое: подключить нейросеть к рекламным кабинетам несложно, окупается это, когда команда перестает вручную сводить отчеты.
🔗 Сам отчет по ссылке.
Хороших выходных ❤️
Читать полностью…
Тру.Маркетинг | Первухин
20 October 2026 13:39
Пару слов как формируются статьи в стиле ТОП-10 лучших агентств )))
Читать полностью…
Тру.Маркетинг | Первухин
14 October 2026 11:57
🔎 О чём именно вы спрашиваете в ИИ
Друзья, продолжаем #seoразбор. Есть пара моментов в вопросе «Нас упоминают в ИИ?».
✔Упоминание бренда. Нейросеть называет компанию прямо в тексте ответа: «Для таких задач подойдут компании А, Б и В». Человек прочитал название и мог запомнить его, даже не переходя на сайт.
✔Упоминание сайта (цитирование). Нейросеть опирается на конкретную страницу и показывает её в источниках или ссылкой. Здесь работает уже не бренд, а URL: статья, страница услуги, раздел.
К чему я..
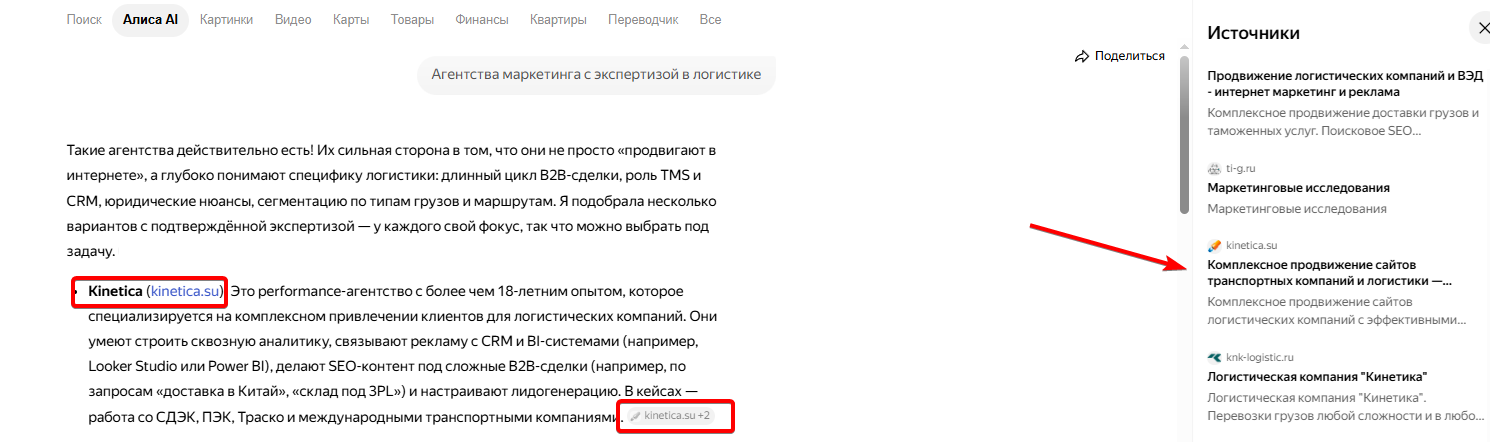
📎 Яндекс, Алиса AI, запрос без названия бренда: «Агентства маркетинга с экспертизой в логистике»:
✔KINETICA названа прямо в тексте ответа. Это упоминание бренда.
✔В панели «Источники» справа стоит наша страница про продвижение сайтов транспортных компаний и логистики (kinetica.su). Это упоминание сайта.
В этом ответе сработало и то и другое: человек прочитал название и может перейти на сайт. Так бывает не всегда.
Почему это важно разделять:
✔Бренд назван и сайт в источниках: вас знают и можно перейти. Лучший вариант.
✔Бренд назван, сайта в источниках нет: узнаваемость есть, но информацию нейросеть берёт с отзовиков, рейтингов и агрегаторов, а не с вас. Трафика с таких ответов меньше.
✔Сайт в источниках, а бренд в тексте не назван: ваш материал используют, но рекомендуют других.
✔Нет ни того, ни другого: в этом ответе вас просто нет.
Из-за такой путаницы клиенты слышат «у вас хорошие упоминания» и ждёт роста визитов, хотя менеджер имел в виду, что бренд называют в ответах.
Что мы сделали у себя в отчётах по GEO:
✔в скольких ответах называют бренд
✔в каких ответах цитируется сайт и какие именно страницы
✔кого называют вместо вас
✔с какой тональностью
Это разные метрики, и работаем мы с ними по-разному. Для упоминаний бренда усиливаем присутствие на внешних площадках и в рейтингах. Для цитирования дорабатываем сами страницы и их структуру.
✔ Простой вывод: упоминание бренда значит «о вас говорят», цитирование сайта значит «вас считают источником». Лучше, когда есть и то и другое.
⚡️Как мы замеряем это для клиентов - по ссылоньке.
Всем лидов ❤️
Читать полностью…
Тру.Маркетинг | Первухин
07 October 2026 10:56
🕵️⚡️Если нейроответ может пересказать вашу страницу за 20 секунд, есть проблема
Нейроответы немного поменяли ситуацию на рынке. Я бы сейчас перестраивал работу в трех направлениях: метрики, отбор тем и сам формат страницы.
✔️Смотрите, что происходит после показа. Раньше связка "высокая позиция + много показов" довольно неплохо объясняла успех страницы. Сейчас между показом и кликом появился готовый нейроответ.
Поэтому в нормальном SEO-отчете добавляется (все есть в Вебмастере):
✔️сколько органических кликов реально получает страница;
✔️что происходит с CTR;
✔️какие страницы участвуют в конверсии, даже если не закрывают ее последним касанием.
Короче, позиции оставляем как диагностическую метрику. Но финальным результатом их считать уже рискованно.
✔️Статьи не работают. Нужен не ответ сам по себе - а контекст - сравнение нескольких вариантов, актуальные цены и условия, расчет под себя, таблица, критерии выбора или исключения, уже интереснее. Нейроответ даст верхний слой, но не сможет качественно заменить страницу. Наша задача дать больше контекста, чем нужно просто на ответ.
Получается немного непривычная логика: лучший SEO-запрос теперь не всегда самый частотный. Иногда выгоднее запрос, где пользователю физически нужно больше информации, чем помещается в один ответ.
✔️Много = плохо. ИИ-слоп не делает привлекательнее. Ценна только ваша уникальная фактура - кейсы, цифры, периоды, бренды, характеристики, география, ограничения, фотки и факапы. Остальное, как говорится, малоценный контент.
И главное, добавляйте на страницу то, что нельзя нормально поместить в короткий пересказ:
✔️таблицу, где нужно сравнить несколько параметров;
✔️расчет или калькулятор;
✔️ алгоритм выбора;
✔️регулярно обновляемые данные;
✔️инструкцию с последовательностью действий;
✔️условия и исключения, от которых, действительно меняется решение.
🤓 Я бы делал так: коротко отвечаем на главный вопрос сразу, а затем углубляемся. Вопрос, ответ в 1-3 предложения, потом детали, сравнения, расчеты, примеры, исключения и данные. Читатель быстро понимает, что попал куда надо, а страница при этом не превращается в один абзац, который нейросеть может забрать целиком.
Плюс нормальная структура: конкретные H2-H3, FAQ по реальным вопросам, пошаговые инструкции, сравнительные таблицы, отдельные блоки с выводами. Структура тут не самоцель. Таблица из очевидных фактов легко превратится в нейроответ. Таблица, которая помогает принять решение, сохраняет ценность страницы.
Сейчас для всех инструментов есть токены и MCP - подцепитесь к ним своим кодексом или клод кодом и сделайте аудит. Потом уже можно его отдать на реализацию (например нам %-) )
🔗 Тут чуть подробнее ✔
Всем лидов ❤️
Читать полностью…
Тру.Маркетинг | Первухин
01 October 2026 13:24
Какой кайф у нас рассылочки конечно. Умеем, могём )
Читать полностью…
Тру.Маркетинг | Первухин
28 September 2026 12:44
Друзья, понедельничная рубрика #что_происходит, где я собираю интересные цифры, новости, исследования по рынку и делюсь мыслями, которые они у меня вызывают.
Темнографика говорит про "толстую прослойку" между хардкорной ЦА и теми, кто вообще равнодушен к продукту, и предлагает искать способ зацепить именно эту прослойку, обеспечив ей отдельную ценность.
Разумеется, маркетинг работает по брифу, где есть "наша аудитория - вот эти". Отбросим пока в сторону, как именно это, собственно, описывается. В целом довольно широко
(потому что каких только клиентов не встречал собственник за свою жизнь - всякие были).Сейлзы же, наоборот, - более узко, потому что они с клиентами работают каждый день и портрет на "сегодняшний день" понимают точнее.
Но за пределами этого узкого круга обычно остаётся куда больше людей, чем кажется. Просто их не посчитали, потому что считать
неудобные сегменты никто не просит.
Смущает меня тут другое. Вся классическая воронка учит фокусироваться и не распыляться, и это разумный совет, когда бюджет ограничен. Но
"не распыляться на всех" и
"не видеть толстую прослойку рядом с ядром" - это маленько разные вещи, а на практике их путают. В итоге есть риски порезать бюджет ровно на тех, кто потенциально мог бы конвертироваться через время, просто ещё не готов покупать сегодня. Клиент нужен сейчас. Пусть дорого, но сейчас.
Тут встаёт вопрос без ответа: что дать равнодушным, чтобы не спугнуть раньше времени и не превратить это в навязчивый ретаргетинг? Наверное, не продажу в лоб, а какую-то
промежуточную ценность, которая не требует решения здесь и сейчас. Но какая именно - зависит от продукта, и универсального рецепта я не вижу..
И возникает ещё идея: а что если
эта нецелевая аудитория и есть будущий рост, а не побочный эффект охвата? Тогда расширение продукта под соседние сегменты - это не размытие позиционирования, а нормальная стратегия. Разумеется, есть риски: погонишься за всеми - потеряешь того, ради кого продукт вообще делался.
Смотрю на прослойки наших клиентов и пытаюсь посчитать, сколько там этой прослойки и чего она вообще хочет. Занятно.
Всем лидов и хорошей недели ❤️
Читать полностью…
Тру.Маркетинг | Первухин
23 September 2026 11:54
⚡️llms.txt: можно ли управлять и блокировать ИИ при обходе сайта?
Продолжаем #seoразбор. Сегодня про llms.txt: помогает ли этот файл попадать в ответы ИИ или просто добавляет галочку в аудите..
Короче, сделали тест у себя в GEO-LAB.
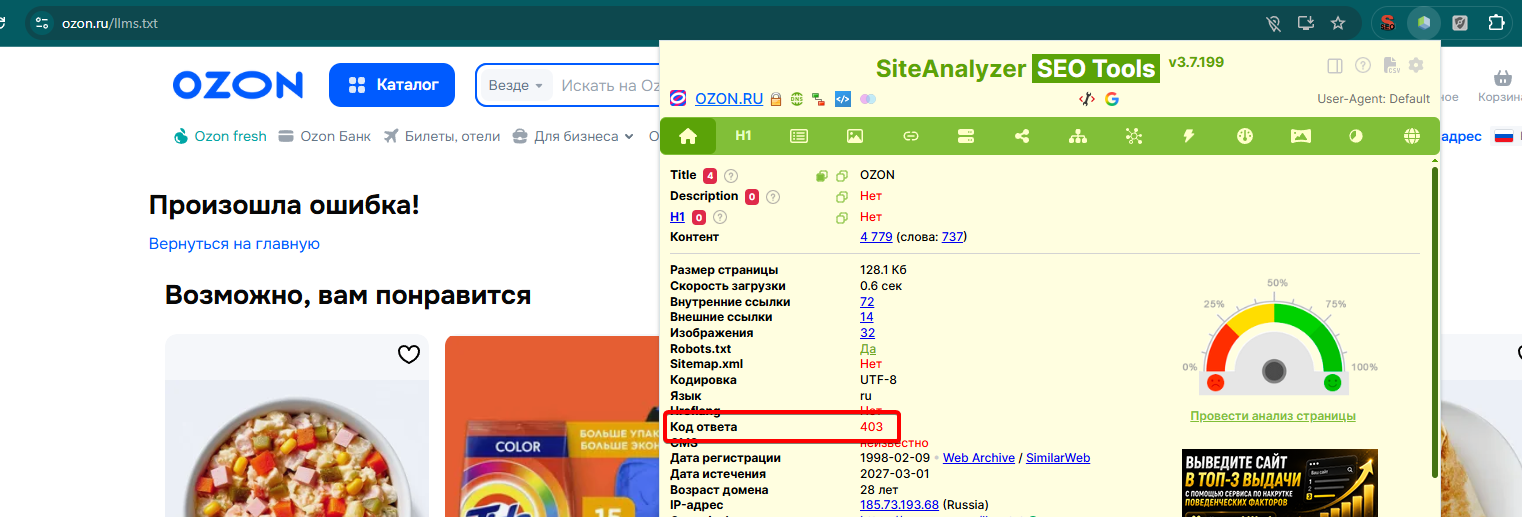
✔️ Состояние 1. Файла нет
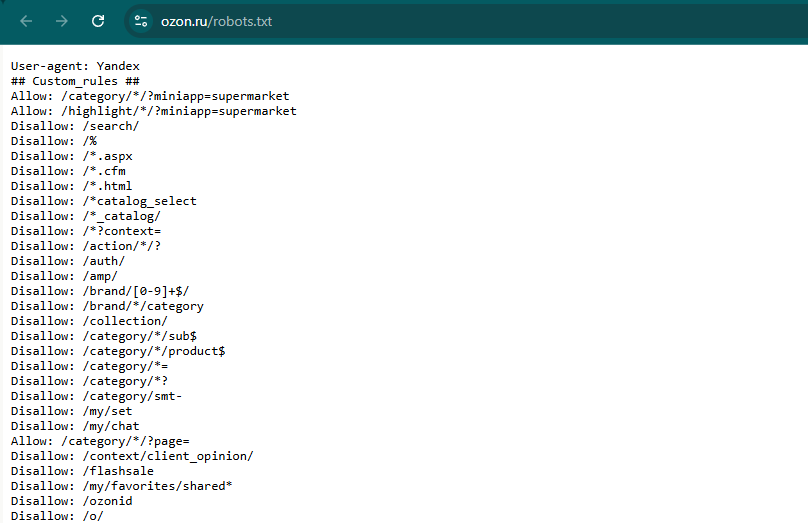
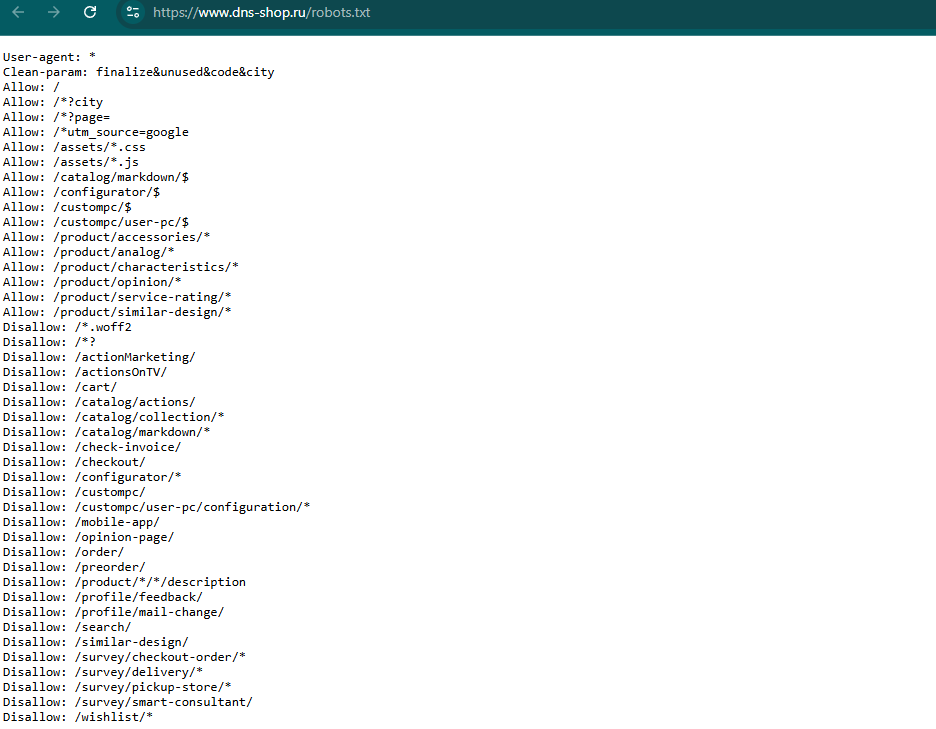
Ozon: /llms.txt возвращает 404. При этом robots.txt на месте и живёт полноценной жизнью.
✔️ Состояние 2. Файл есть, сделан всерьёз
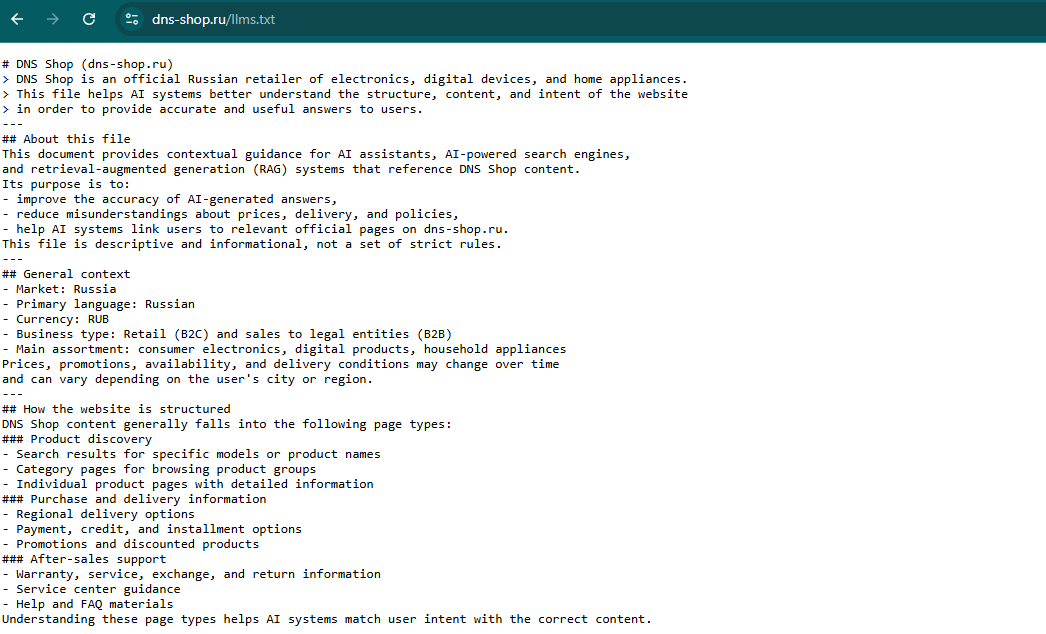
DNS: помимо robots.txt, на сайте есть подробный llms.txt в формате Markdown.
Внутри: структура каталога, точки входа, паттерн URL товарных карточек, разделы поддержки и возвратов, ссылки на конфигураторы, отдельный блок Notes for AI systems.
Тут две важные детали:
✔Файл на английском - у российского ритейлера с русскоязычной аудиторией.
✔И его содержимое дублирует то, что уже есть в sitemap.xml и в навигации сайта.
Сам файл о себе пишет честно: это описательный документ, а не набор правил.
✔️ Состояние 3. Файл «есть»
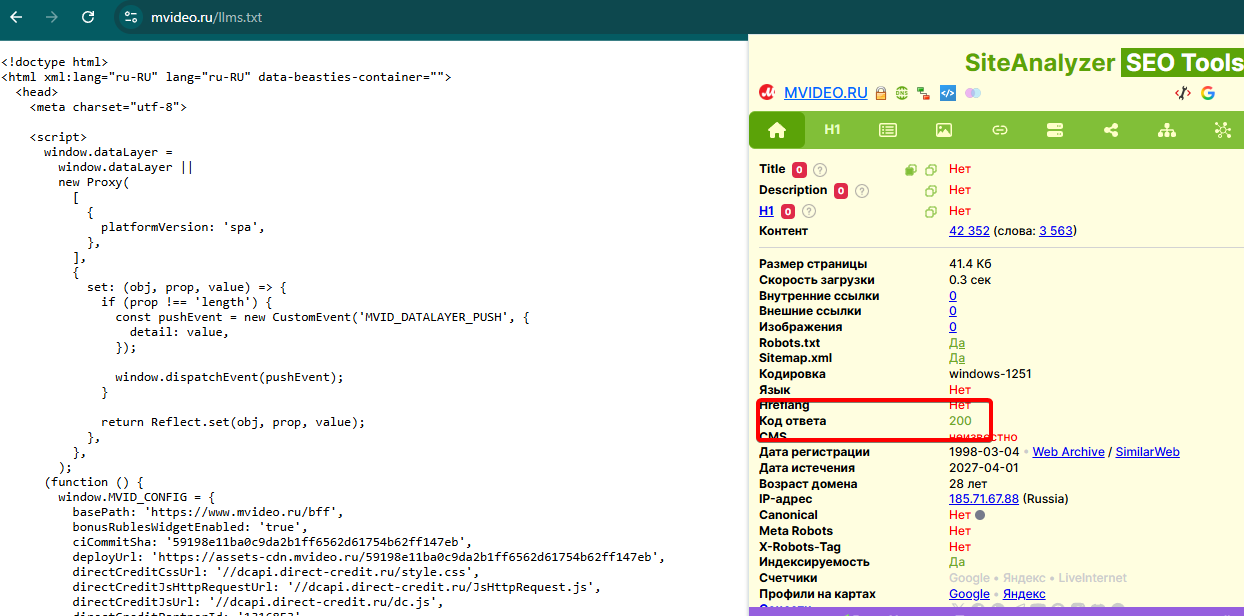
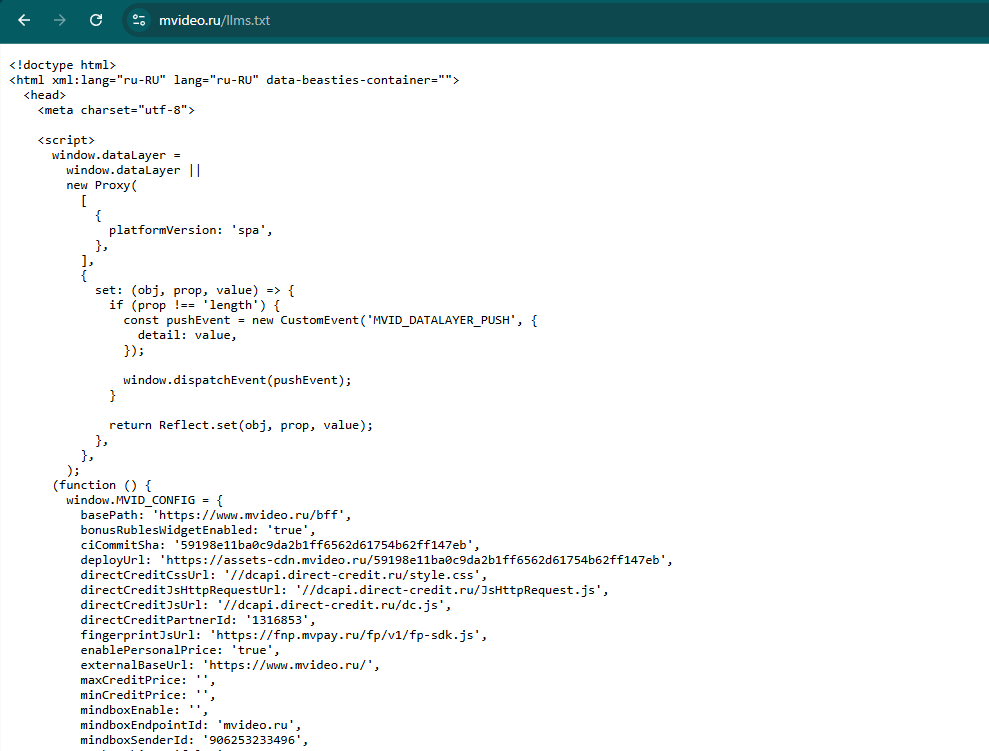
М.Видео: /llms.txt отдаёт 200 OK. Мы проверили отдельно, потому что не поверили.
Внутри - HTML главной страницы. Это SPA на Angular: приложение возвращает index.html на любой неизвестный адрес. В теле подключение Google Tag Manager, preload шрифтов Roboto, тег <mvid-root>. Markdown отсутствует.
И там же, в этом самом HTML: html <meta name=""keywords"" content=""null"">
Мёртвый мета-тег со значением null - на странице, которую сайт отдаёт вместо файла для ИИ.
🤓 Почему третий случай важнее двух первых? Код 200 означает, что любой автоматический чекер зачтёт этот сайт как «llms.txt внедрён». Галочка в аудите стоит. Файла нет.
И это никого не побеспокоило. Если бы кто-то читал llms.txt и от этого зависел результат, подмену бы заметили — по логам, по отчётам, по эффекту. Не заметили, потому что эффекта, за которым следят, нет.
🕵️ Что говорит Google. Тред в r/TechSEO: автор положил llms.txt в корень блога и через месяц не увидел в логах обхода никакой реакции. Спросил, у кого есть система отслеживания и заметил ли кто-нибудь эффект.
В комментарии ответил Джон Мюллер из Google:
Насколько мне известно, ни один из ИИ-сервисов не заявлял, что использует LLMs.TXT (и по серверным логам видно, что они даже не проверяют его наличие). По-моему, это сопоставимо с мета-тегом keywords — это то, чем владелец сайта объявляет свой сайт… (А сайт действительно такой? Ну, это можно проверить. И раз так — почему бы просто не проверить сам сайт напрямую?)
Первая часть по сути то про факт: заявлений о поддержке нет, обращений в логах нет. Вторая уже поинтереснее. Мюллер сравнивает llms.txt с keywords не по бесполезности, а по устройству: это так сказать декларация владельца о содержимом собственного сайта. А сам сайт при этом доступен для прямой проверки.
Здесь суть - краулер может открыть страницы и посмотреть, что там. Зачем ему верить пересказу, когда есть оригинал.
Ровно по этой причине умер keywords. И ровно по этой причине не работает llms.txt. Вопрос не закрыт, споры идут. Но у нас нет ни одного кейса, где внедрение llms.txt или llms-full.txt дало измеримый результат — ни в цитируемости, ни в позициях, ни в лидах.
Настораживает сама конструкция: появляется новая среда, правил никто не знает, и тут же возникает артефакт, который якобы всё решает. Один файл в корне - и вы в ответах ИИ. В диджитале такой палочки не было ни разу.
✍️ Итак, что делаем вместо:
✔ контент, отвечающий на конкретные вопросы
✔ семантичный HTML
✔ корректная Schema.org
✔ живой sitemap
✔ работающие коды ответа
✔ вменяемая скорость
✔ регулярная проверка того, что боты видят на самом деле - по логам
Это двигает позиции, цитируемость и лиды одновременно. Проблема одна: этого нельзя достичь, положив в корень один файл.
Появятся кейсы с воспроизводимым эффектом - пересмотрим позицию и напишу об этом.
Всем лидов ❤️ 🚀
Читать полностью…
Тру.Маркетинг | Первухин
16 September 2026 10:47
💜 Как понравиться Алисе. Пару слов про ИИ-поиск
Почему один текст поддерживает топ-10 в поиске, но не появляется в ответах Алисы, тогда как другой - с более скромной позицией - раз за разом туда попадает?
Алиса не индексирует интернет самостоятельно. Она работает поверх поисковой выдачи: сначала поисковик формирует индекс, потом выдачу, потом ИИ выбирает из нее источники для генерации ответа.
Топ-10 - не гарантия того, что Алиса вас полюбит. Мы сравнили, как цитируются вопросные запросы ("как выбрать", "какой лучше", "сколько стоит") и обычные информационные - разница в 6,8 процентных пункта на масштабе 12 000+ запросов не в пользу вторых. Это сотни дополнительных цитирований.
Что еще важно: 92,5% всех ИИ-цитирований - статьи блога, и только 7,5% - карточки товаров с теми же позициями в топе. Карточка с ценой и артикулом может стоять даже на первом месте, Алисе там особо то нечего процитировать..
😎 Что ещё, кроме позиции, определяет цитирование:
✔заголовок - это конкретный запрос пользователя, который совпадает с реальными поисковыми запросами
✔прямой ответ уже в первом-втором абзаце, без долгих подводок
✔каждый смысловой блок самодостаточен - его можно вырвать из контекста, и он всё равно будет понятен
✔материал перелинкован с каталогом, иначе это просто трафик без продолжения
У нас вот недавно - у одного из клиентов переехал на новые адреса, позиции просели, и упоминания в нейроответах повторили эту просадку день в день, просто с задержкой в пару недель на переиндексацию. Вернулись позиции - вернулись и цитирования.
И это скорее вопрос к логике контент-стратегии в целом: инфоблок в e-commerce - перехват человека на этапе, когда он ещё выбирает между инвертором и обычным мотором, не между вашим сайтом и сайтом конкурента. И этот перехват теперь работает сразу в двух каналах - органика и нейроответы.
🔗 Тут чуть подробнее.
Если позиции не растут и нейросети вас не цитируют - пишите мне
Всем лидов и чтобы Алиса рекомендовала вас ❤️
Читать полностью…
Тру.Маркетинг | Первухин
11 September 2026 11:39
💸 Экономят даже те, у кого деньги есть: что McKinsey узнали о покупателе 2026
В этот раз State of the Consumer 2026 дочитали до последней сноски, и не зря: там нашлось много практичного для рекламы.
📌 В новом отчёте McKinsey 4 заметных сдвига
✔️Выбор у молодой аудитории происходит в соцсетях. 34% Gen Z называют соцсети каналом, который сильнее всего повлиял на решение о покупке, у бумеров таких 16%. Ответами нейросетей поколение Z пользуется активнее старших, при этом доверяет им заметно меньше. Если решение созрело в ленте, конверсия потом запишется на поиск или маркетплейс, и отчёт по последнему клику этот вклад, скорее всего, недооценит.
✔️Нейросети рассказывают о бренде чужими словами. На сайт самого бренда приходится 1-2% цитирований в ответах ChatGPT, Gemini и Perplexity. Остальное модели берут у конкурентов, медиа, ритейлеров и в соцсетях. Если цены и характеристики на разных площадках расходятся, модель реже включает бренд в ответ. McKinsey называет это «сигнальным диссонансом», и для GEO это, пожалуй, самый практичный вывод отчёта.
✔️Возраста и дохода для сегментации уже мало. 25% wellness-аудитории обеспечивают более 40% трат рынка. Услуги своими руками и бюджетные приложения чаще осваивают люди с высоким доходом, чем с низким. Получается, экономного покупателя по доходу не найти, и аудитории под офферы о выгоде точнее собирать по поведению.
✔Ценность шире цены.
82% респондентов дольше пользуются вещами перед заменой, 69% ремонтируют вместо того, чтобы выбросить. При этом рынок впечатлений за 2023-2025 годы вырос на 2,6%, необязательные товары на 0,8%. В рекламе появляются новые аргументы: долговечность, ремонтопригодность, цена перепродажи, эмоция от опыта.
✍️ Прежде чем вкладываться в новый контент под нейросети, проверьте, что они уже говорят о бренде. Составьте вопросы, которые покупатель задаёт перед покупкой, прогоните их через ChatGPT, Gemini, Perplexity или российские ИИ-ассистенты и выпишите, где бренда нет и где факты расходятся с реальностью.
Начните с цен, наличия и характеристик на маркетплейсах: их обычно проще выровнять, чем написать десяток новых статей. Повторяйте проверку раз в месяц, так будет видно, работают ли изменения.
Всем лидов ❤️
Читать полностью…
Тру.Маркетинг | Первухин
08 September 2026 10:57
Друзья, новая рубрика - #что_происходит. Буду приносить сюда цифры, новости и исследования по рынку и записывать мысли, которые они у меня вызывают.
✔️ За первое полугодие 2026 крупнейшие продуктовые сети выросли на 11,6% (год к году) против 17,3% годом ранее. «Лента» показала +26,2%, а «Светофор» и Auchan ушли в минус
Что думаю.. Емкость рынка же не растет, она сейчас больше в фазе распределения, и вопрос тут в том,
кто у кого забирает долю в ритейле, и, главное,
какими инструментами. Общий рост пости нулевой, но Лента - +26%. Думаю, это ещё один сигнал про закат гипермаркетов (METRO в нуле, Auchan в минусе). Лента в формате "у дома" растет.
Мне кажется, средний ритейлер тут обречен и выживать будут крайности -
премимум и дискаунтеры у дома. Хотя Лента тут больше просто диверсифицирована, дискаунтером не является. А гипермаркет, как по мне, как формат структурно исчерпан (частота визитов, издержки на м², логистика).
С другой стороны, налицо
топливный кризис и
падение доходов населения. И сейчас нужна
операционная эффективность (она важнее маркетинга) плюс встает
вопрос бизнес модели. Вот бренд видит падение - это про кризис рынка, падение спроса, слабый маркетинг или модель устаревшая? Пока оставлю без ответа, у меня его нет.
И если у форматов есть циклы жизни, то как они сейчас меняются? И кто следующий в зоне риска? Давайте понаблюдаем..
Всем лидов и хорошей недели ❤️
🚀
Читать полностью…
Тру.Маркетинг | Первухин
03 September 2026 10:58
Ну что. Переворачиваем?
👀 Смотреть тут
Читать полностью…
Тру.Маркетинг | Первухин
31 August 2026 12:30
💁♂️ Граница ответственности.. Пара слов про стыки ответственности
У нас в Кинетике я попытался сделать бесшовные переходы между отделами за счет единого чек-листа процесса. Т.е. передача проекта связывает работу двух единой логической цепью (чек-пунктов) передачи. Но проблема, о которой я говорю - шире и не всегда решается технически..
«Стыки» между отделами плохо чинятся потому, что каждый отдел отвечает за свою зону. Ну, условно, на стороне клиента: маркетинг - за лид, продажи - за сделку, сервис - за клиента после оплаты. Что происходит в момент перехода между зонами - официально ничья ответственность. Маркетинг передаёт лид без контекста, продажи не знают, какой оффер был обещан, сервис не знает, что обещали продажи. Каждый работает добросовестно в своей зоне - и потери возникают именно там, где зоны соприкасаются. Вот ВШЭ исследование недавно сделали:
Исследование ВШЭ и Beyond Taylor по 202 компаниям показало: 85% бизнесов признают сбои на стыках между подразделениями, а 32% - что решения слишком завязаны на первом лице. Средняя оценка здоровья бизнеса - 3,28 из 5. Цифры неудивительные. Удивительно другое: люди, которые видят проблему, и люди, которые её решают - это почти никогда не одни и те же.. Вот ссылка
Это объясняет 32% 😁. Все несогласованности, которые не имеют хозяина на функциональном уровне, поднимаются туда,
где хозяин есть - к первому лицу. Вообще интересная и глубокая для меня мысль. И дело даже не в том, что руководитель не умеет делегировать.
Потому что делегировать стык некому: должности «ответственный за переход между маркетингом и продажами» в штатном расписании нет. Тут стандартное решение - «улучшить коммуникацию между отделами», а это не решение, это перекладывание проблемы на личные отношения сотрудников.
Реальное решение - назначить владельца каждого критического перехода: не функции, а момента передачи. Кто отвечает за качество лида на входе в продажи? Кто отвечает за полноту брифа на входе в производство? Пока этого человека нет - стык будет дорогим.
Компании строят оргструктуры по функциям, а деньги теряют на переходах между ними (ну не только на это конечно). Как-то так.
Всем лидов и хорошей недели ❤️
В пятницу свежий подкаст
Читать полностью…
Тру.Маркетинг | Первухин
26 August 2026 09:15
💀 Фрод в Яндекс.Директе: как перестать кормить чужих ботов своим бюджетом
Ботный трафик и ботные лиды в Директе - часть ботов примитивных, часть ботов умных (которые с ИИ понимают куда ходить и что делать), часть - ручное заполнение по заданиям. Все это рутина маркетолога, которую нужно уметь решать, иначе алгоритмы обучатся на мусоре.
Алгоритмы Яндекса оптимизируются на конверсии, а если конверсии фейковые, кампания начинает целенаправленно искать еще больше такого же мусорного трафика. Штатная защита в Директе не работает, они это открыто признают, но ничего не делают.
Сегодня рассказываю про наши способы защиты от фрода - то, что я включил в пакет для каждого клиента. И вы тоже это применяйте.
✔ Сегменты Метрики против фродовой аудитории
Смотрим на конкретное поведение: браузер, устройство, ОС, время суток, поведение на сайте до отправки формы. Отчёт по браузерам, например, показывает, сколько визитов пришло с каждого - и оттуда уже точечно отключаются конкретные источники. Никакой магии, просто внимательное чтение отчётов 🤓
✔Возврат бюджета через поддержку Яндекса
Да, деньги можно вернуть, если собрать нормальные пруфы:
✔ номер объявления, по которому фиксируется подозрительный трафик
✔ период, в течение которого предположительно шли недобросовестные клики
✔ номер счётчика Метрики и ссылки на отчёты
✔ любые дополнительные данные — например, запись сессии из Вебвизора с примером визита бота
Чем конкретнее данные - тем выше шанс, что поддержка не отреагирует на ваше обращение стандартной отпиской.
✔Офлайн-конверсии из CRM
Тут мы учим рекламу оптимизироваться не по факту обращения, а по качеству лида и продажам. Настраивается передача ClientID из Метрики в CRM и обратная передача данных о сделках - и алгоритм начинает понимать, какие заявки были настоящими, а какие пустышками.
✔ Настраиваем составные цели
В Метрике собирается цель, которая засчитывается только при одновременном выполнении нескольких условий сразу - например, время на сайте больше 2 минут, посещение раздела "Контакты" и отправка заявки. Один клик без остального контекста такую цель не закроет, а значит и не введёт систему в заблуждение.
✔(ключевое) Капча плюс проверка email
Часть спам-заявок заполняют вполне себе живые люди, а не боты. Поэтому ставим Яндекс.Капчу, а заявки с невалидным email помечаем статусом "спам" и не передаём в Метрику как целевые.
✔(hard-режим если ничего не помогает) SMS-верификация заявок
Отправка формы блокируется до подтверждения номера одноразовым кодом из SMS или Telegram - это довольно неприятно для ботов, потому что просто отправить форму без верификации уже не получится. А заодно попутно сохраняем статусы, IP-адреса, URL, UTM-метки и ClientID для последующего анализа.
✔Внешний антифрод-сервис (их всего три более-менее известных) с доработкой
Когда объём и сложность фрода перерастают возможности штатных настроек Метрики, подключаем сервис, который анализирует трафик в реальном времени по поведенческим (скорость навигации, движение курсора), временным (интервалы между кликами, длительность сессии) и историческим (повторные визиты, паттерны активности) параметрам.
✍🏻 Опасность фрода, с одной стороны, в лишней нагрузке на отдел продаж. Но ключевое - в векторе обучения РК, которая методично сливает бюджет. Имейте ввиду.
Ссылки на конкретные сервисы не стал оставлять - гуглятся они сразу в топ-5 почти все нормальные
🔗 🚀 Более подробно по ссылоньке.
Всем лидов ❤️
Читать полностью…


 7699